Wiki 知识库

技术 / LLM

1284 篇
清除

从零安装Qwen3.8-27B:Mac本地部署与性能调优指南

本文详细介绍了如何在 Apple Silicon Mac 上从零部署 Qwen3.8-27B 模型。作者苏乐指出,普通 Mac 无需升级到最新 Mac Studio 即可运行该模型,关键在于算清内存账:模型权重、上下文缓存、运行缓冲、草稿模型和系统开销共享统一内存。文章对比了 4-bit、8-bit 和 BF16 量化版本的选择建议(24GB/32GB 选 4-bit,48GB/64GB 可选 8-bit),并提供了完整的部署流程:使用 uv 管理环境、通过 hf 命令下载模型、先测 baseline 速度再逐步开启优化。文章还解释了 DFlash 2 投机解码加速原理——通过轻量草稿模型并行提出候选 token,再由主模型验证,从而显著提升生成速度。

技术 › LLM 苏乐 2026-09-0137.3 KB 435.7K 623 85

国内大厂 AI 渗透率及趋势访谈报告,四位资深管理者给出了不同答案

本报告基于对四位国内大厂一线技术管理者的深度访谈,探讨 AI 在大厂的渗透现状与趋势。核心结论:AI 已完成工具层渗透,正在进入人才重估阶段,但尚未普遍完成组织重构。报告围绕 12 个问题展开,涵盖 AI 渗透程度、HC 收缩趋势、招聘标准变化、能力升贬值、管理岗位变革及 Agent 与人协作模式等。四位受访者均认为正式 HC 吃紧,人才市场正从按年限分层转向按潜力和责任能力分层;中层管理者的信息路由价值正在丧失,而能做风险决策并承担责任的核心人才更安全。

技术 › LLM 西西米修斯 2026-08-3148.1 KB 11.3K 26 81

实测智谱 GLM-5.3-Flash,我称之为能稳稳把 DeepSeek 纳入斩杀线

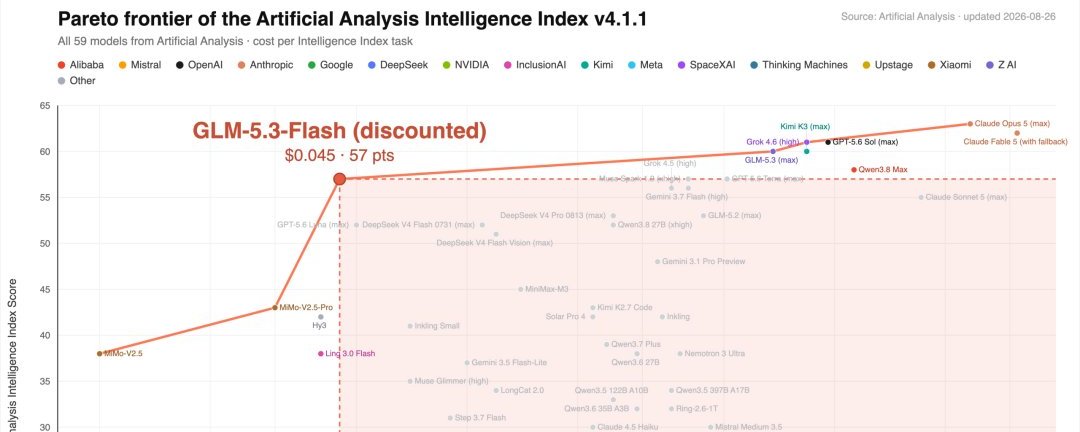
作者实测智谱新发布的 GLM-5.3-Flash 模型,对比 DeepSeek V4 Flash 的价格与性能。该模型每百万 Token 输入 0.8 元、输出 2.8 元,在 Artificial Analysis 榜单上以 $0.045 成本获得 57 智力分,14 项 benchmark 中赢 DeepSeek 11 项,视觉端六项全胜,与 Opus 4.8 对比 13 项赢 9 项。实际测试中,模型可通过一句话从截图、视频、链接复刻网站(如 GitHub、3D 游戏 Krunker),前端与视觉能力极强。作者计划将日常 coding 和 agent 任务分流给它以节省成本。

技术 › LLM 卡尔的AI沃茨 2026-08-3111.6 KB 1.9K 1 71

LEANN:省97%存储的轻量级本地RAG检索方案

传统RAG存储成本高昂,百万级文档索引动辄数百GB,本地设备难以承载。LEANN采用新思路:不存储所有向量,只保留精简的图结构,检索时按需计算,实现存储节省97%且精度不减。它可在笔记本上全本地运行,支持索引文件系统、邮件、浏览器记录、微信/iMessage、ChatGPT/Claude对话、Slack/Twitter实时数据及代码库,零云成本、数据不出设备、注重隐私。该项目已入选MLsys 2026,适合关注隐私的个人语义搜索开发者。

技术 › LLM LanfAI (@Huahuazo) 2026-08-31941 B 60

The Math of RL: From Policy Gradients to PPO and GRPO

本文深入讲解强化学习的数学原理,重点推导策略梯度、REINFORCE、PPO 和 GRPO 等算法。作者首先介绍 RL 的基本流程(Agent、环境、奖励、策略),并通过数学推导得到策略梯度估计器。随后指出原始策略梯度存在的高方差和偏置问题,引入 REINFORCE 算法进行改进。文章还结合 RLHF 和 RLVR 在大语言模型训练中的应用背景,说明 RL 在 LLM 对齐及数学、编程能力提升中的重要作用,帮助读者理解现代 LLM 强化学习训练的底层机制。

技术 › LLM Harsh Bhatt 2026-08-3117.7 KB 56K 567 56

Top AI Papers of the Week(8月24-30日)

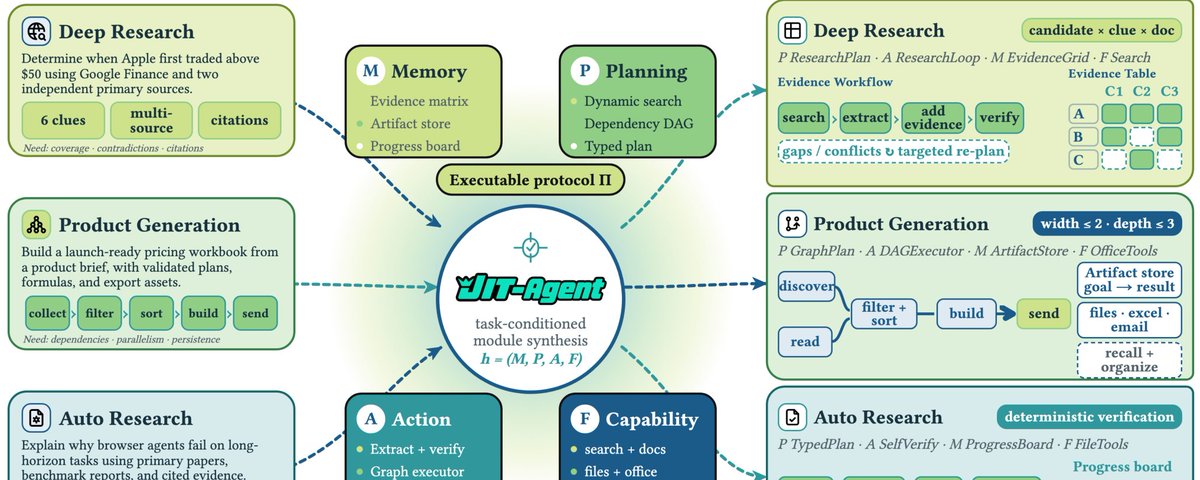
DAIR.AI 本周精选五篇 AI 论文:1)Netflix 的 LLM Judge 生命周期管理,通过推理对齐的评分标准调优实现生产级评估,A/B 测试显著提升用户浏览转化;2)NVIDIA 的 Skill Lift,用配对运行测量 Agent Skill 的实际增益,发现结构扫描分数与质量几乎不相关;3)阿里巴巴 Scroll,以代码方式管理上下文,用事件日志与沙箱内核替代预设 schema,在长记忆基准上取得最佳成绩;4)JIT-Agent,按任务即时生成 Harness,使多个骨干模型大幅提升;5)Prime Intellect 开源长程任务 Harness,支持跨轨迹持久化历史、记忆与技能,实现可复利的自我改进。

技术 › LLM DAIR.AI 2026-08-3114.2 KB 39.2K 88 83

BestBlogs 精选周刊|第 110 期:智能供给、稀缺迁移与长期资产

本期周刊以「新的稀缺」为主题,围绕 OpenAI 定制推理芯片 Jalapeño、智谱 GLM-5.3-Flash、千问 Qwen3.8-Flash 等发布,探讨智能供给成本下降后价值交付的真正瓶颈。文章指出,模型变便宜后,稀缺资源转移到了环境与验证、企业数据治理、Agent 自进化的控制面以及人类注意力上。Coding 只占研发链路的小部分,环境、审批、测试与数据可信度决定完成率;自进化系统需要评测、记忆、落地与控制四个齿轮协同;Harness 演进和记忆系统则凸显人类判断与信任界面的长期价值。团队应把节省的推理预算转投评测、失败分析与用户研究,建设可复利的组织能力。

技术 › LLM ginobefun 2026-08-3031.2 KB 2.2K 3 84

小白AI入门必学的:66 个 AI 高频词(人话版)

作者基于与朋友交流中发现普通人对 AI 术语的困惑,整理出 66 个高频 AI 词汇,用生活化比喻逐一解释。内容涵盖:AI 与大模型基础(LLM、Token、上下文、多模态等)、聊天常见术语(Prompt、幻觉等)、RAG 与检索技术、以及 Agent、工具调用和 MCP 协议等热门概念。每个词都说明其含义、常见使用场景和记忆方法,帮助零基础读者建立 AI 术语的整体认知地图。

技术 › LLM Adrian Punk 2026-08-3028.1 KB 196.2K 650 73

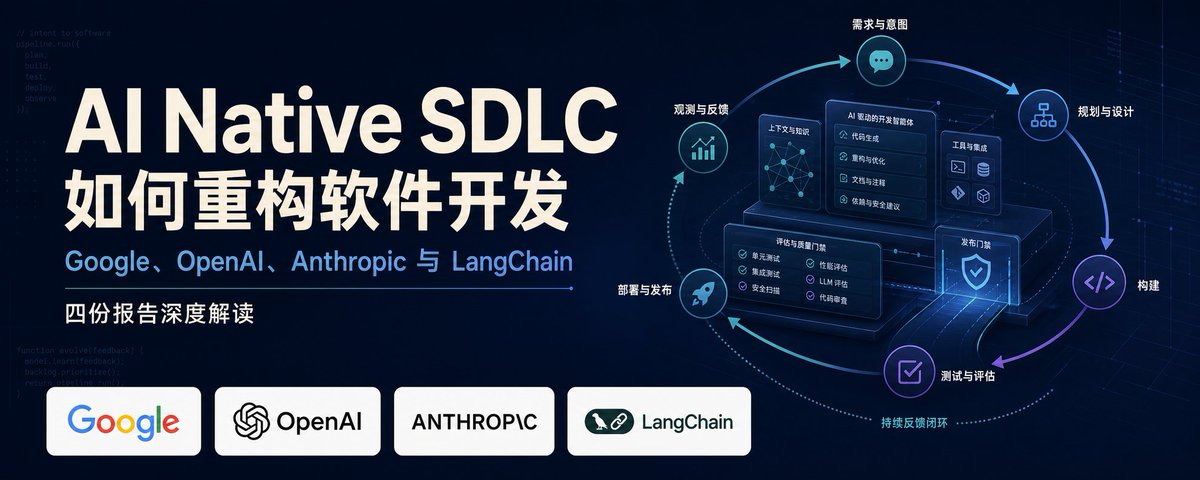
AI Native SDLC 如何重构软件开发:Google、OpenAI、Anthropic 与 LangChain 四份报告深度解读

文章交叉解读Google、OpenAI、Anthropic与LangChain四份行业报告,指出AI对软件工程的最大影响不是提高单环节效率,而是迫使企业重构整个软件开发生命周期。核心观点包括:代码生成正从稀缺能力变为基础能力,交付瓶颈向需求、验证、审查和治理迁移;Context与Harness比模型能力更关键;测试与Evals须形成持续闭环;人类从主要实施者转向意图定义者与风险责任人。文章详细阐述了从意图制品到生产反馈的AI原生工作流、vibe coding与agentic engineering的区别,以及治理如何通过Skills与Hooks等机制在行动时强制执行。

技术 › LLM meng shao 2026-08-3027.7 KB 35.4K 174 80

如何用 WorkBuddy 和手头资料,做成交互式智能问答网页?

本文详细记录了作者在广州某高校图书馆 AI 工作坊上,带领学员使用腾讯 WorkBuddy 将手头资料(如数据表、规章文件)制作为交互式智能问答网站的完整过程。文章涵盖:让 WorkBuddy 生成可视化网站、接入 DeepSeek API 实现自由问答、通过中转函数保护 API key 安全、用 Codex 操控 Chrome 自动完成腾讯云部署等环节。作者还分享了 API key 三道安全防线、部署踩坑经验(教程过时、云函数超时、日期偏差排查)以及成本控制(全班提问仅花两毛二),并强调数据授权与隐私边界的重要性。

技术 › LLM Wang Shuyi 2026-08-3018.8 KB 11K 70 82

AI写公众号贴图、小红书笔记、头条号文章为什么限流和搜索不到的原因分析和解决方案

文章分析了AI生成内容在公众号、小红书、头条号等平台被限流和搜索不到的原因:AI检测权重仅占三成,更关键的是内容同质化问题——连续发布3篇以上结构相似内容会导致账号权重下降,以及文章缺乏清晰问题实体导致搜索无法收录。作者提出解决方案:精心打磨大纲(总纲、卷纲、段纲分层),让AI仅做骨架填充;每百字埋藏一个情绪触发点延长停留时间;AI辅助比例控制在25%-30%,融入个人实测数据与判断;发布前进行全维度检测,大纲至少审核两次。

技术 › LLM 熊叔的茅草屋 2026-08-303.8 KB 5.4K 40 75

AI把努力变便宜以后,普通人靠什么翻身?

文章探讨AI普及后职场价值的重新分配:AI先将职业拆解为任务并压低可自动化部分的价格,使'第一版'产出贬值,而问题定义、高质量上下文、验证、责任判断和分发信任五种能力变得昂贵。作者指出AI首先挤压新人的练级区,建议普通人不要只学工具,而要建立完整工作流,把AI效率沉淀为流程、知识和市场三类个人资产,并给出90天升级路线,强调人机协作而非依赖,利用一人公司与智能体的低成本试错机会实现翻身。

技术 › LLM Stanley 2026-08-3025.3 KB 3.8K 6 83

垃圾佬的生意:方案免费,钱先出去

作者以'垃圾佬'自称,讲述自己用消费级硬件做本地AI推理落地的一人公司生意:长期垫付硬件、电费和算力成本,免费提供方案与判断,账户时红时平。文章剖析了'报价、合同、回本'旧生意信仰的失效,提出'资源与信赖置换'的两层模型:第一层免费提供判断与可行性,第二层持续占用硬件与时间则必须由对方承担成本。作者强调切分边界、保护信赖、尊重成本,并指出失败经验应当流动,避免后来者重复交学费。

技术 › LLM AI最严厉的父亲 2026-08-3030.1 KB 28.1K 6 67

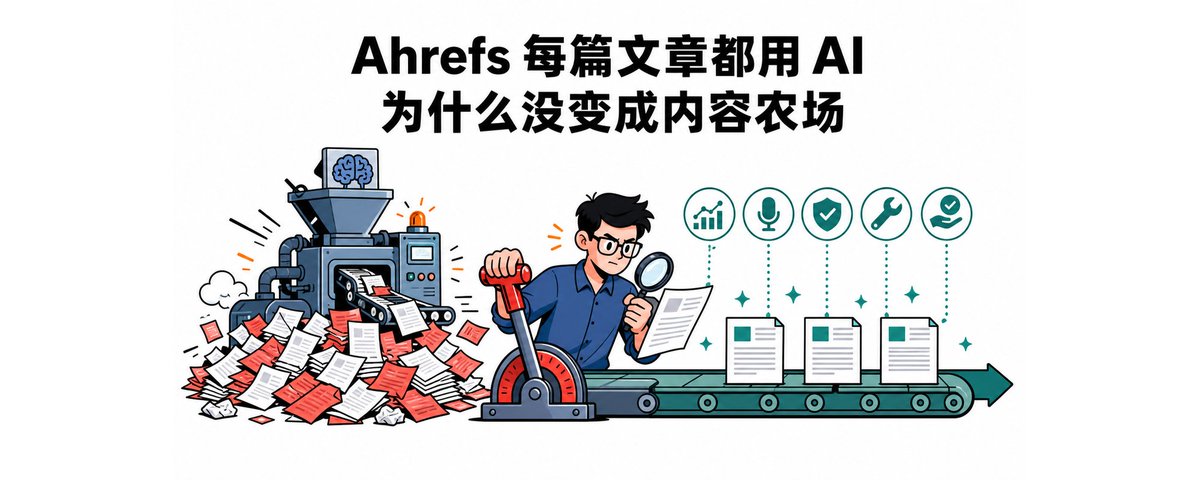
SEO厂商Ahrefs是怎么使用AI写文章的呢?

文章介绍Ahrefs如何用AI生产内容:建立研究、提纲、草稿、验证的内容流水线,6-12分钟生成接近可发布的文章,但强调批量生产不等于批量发布。核心在于理解Google对规模化垃圾内容的政策——Google不禁止AI内容,打击的是无用户价值的操纵排名行为。Ahrefs通过私有知识库、人工口述补充一手材料、多阶段人工review、以及由内容负责人最终审核来保证质量。节省的时间被投入到数据分析、免费工具、交互模块等高价值内容上。作者认为内容团队的关键逻辑是:不是AI产出多少就发布多少,核心价值在于内容价值、原创贡献和可验证的证据。

技术 › LLM Aron厚玉 2026-08-3013.1 KB 6.7K 25 77

斯坦福开源 STORM:给它一个主题,自动生成带引用的长报告

斯坦福开源项目 STORM 是一个基于 LLM 的知识整理系统,GitHub 揽获 3.1 万 stars,两篇论文分别入选 NAACL 2024 和 EMNLP 2024。它通过模拟多个不同视角的提问,先替用户生成提纲,再检索互联网资料,最后撰写结构化正文,每句话附带来源引用,大幅降低陌生领域调研的成本。其 Co-STORM 模式支持用户与多个 AI 专家在对话中共同梳理知识,并维护一张自动更新的分层思维导图,实时展示讨论进度与知识空白,让查资料不再需要一个人硬扛。

技术 › LLM Ren (@Ryrenz) 2026-08-301.4 KB 73

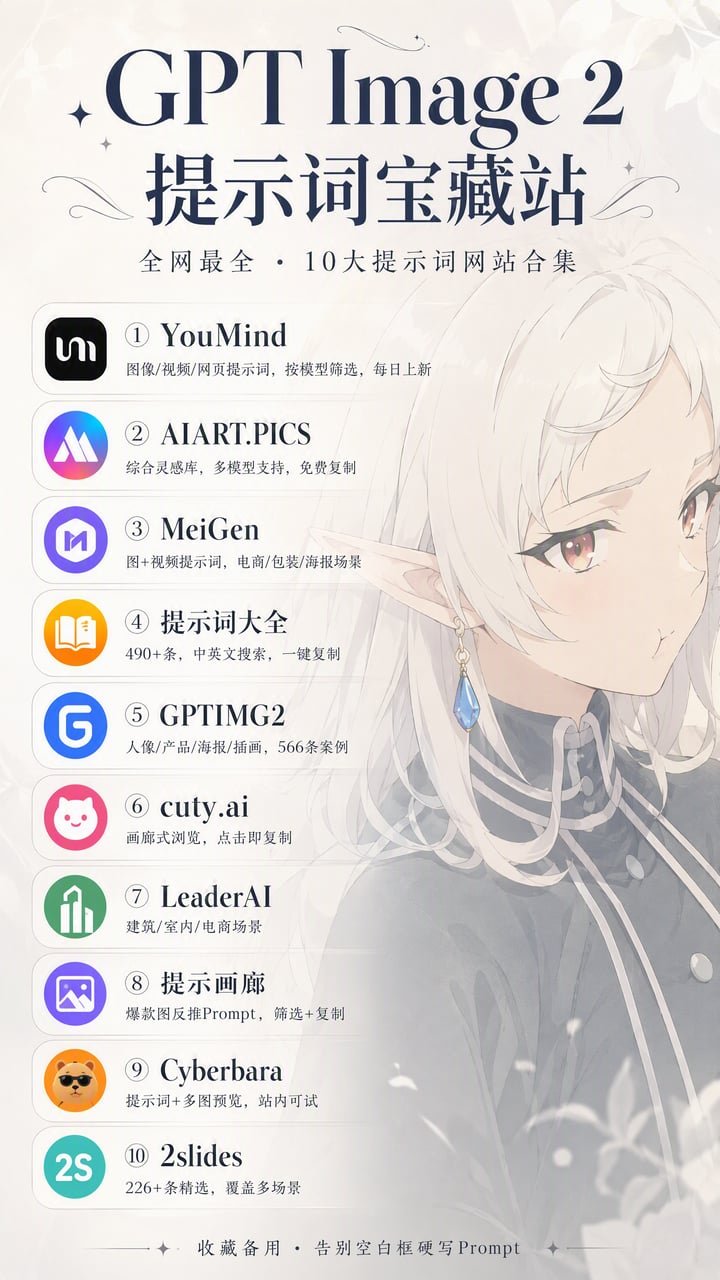
全网最全的GPT Image2提示词网站合集

作者整理了10个GPT Image 2提示词网站合集,帮助用户不必从零撰写提示词,可直接按图复制使用。包括YouMind(图像、视频、网页提示词,按模型筛选)、AIART.PICS(综合灵感库)、MeiGen(电商、包装、海报提示词)、GitHub上的490条GPT Image 2提示词大全、GPTIMG2(566条人像产品海报案例)、cuty.ai画廊、Leader Prompt Gallery、GPT-Image2提示画廊(爆款图反推Prompt)、Cyberbara(站内可试用)、2slides(226+条精选)等,并附图片反推提示词集合。

技术 › LLM Musolsol.𝟎𝐱𝐔 (@MMMusol) 2026-08-304.0 KB 69

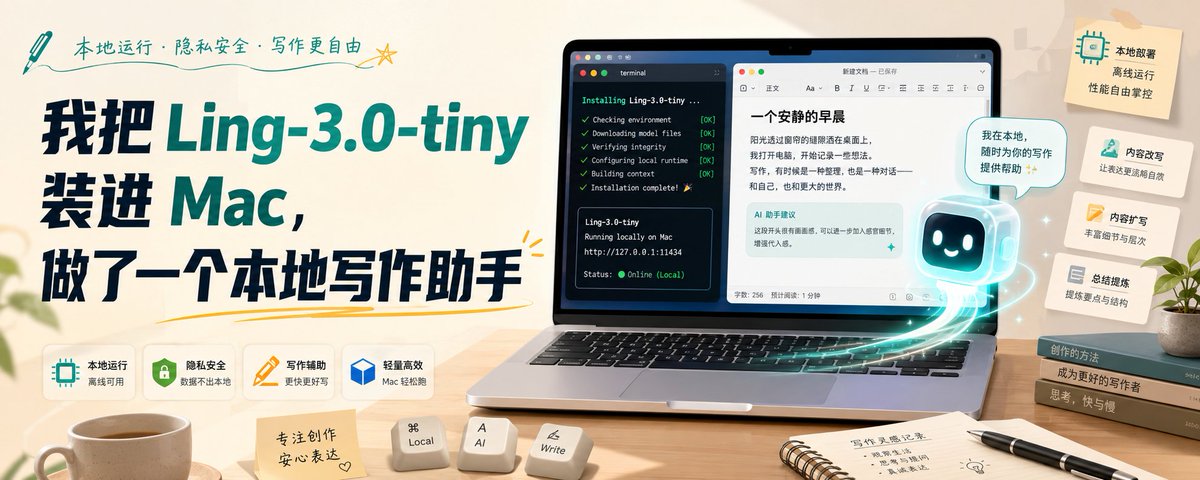
我把 Ling-3.0-tiny 装进 Mac,做了一个本地写作助手

作者记录了在 Mac mini(M4、16GB)上部署蚂蚁开源的混合推理小模型 Ling-3.0-tiny 的完整过程:编译 Ollama 实验分支、下载 FP8/BF16 权重并导入,验证服务后搭建了一个只调用本机接口的写作页面。随后用一篇真实口述稿进行四轮写作测试——提炼结构、检查问题、局部改写和反馈调整,发现模型擅长结构整理与问题扫描,但润色时 AI 味重,难以还原作者口吻。文章还对比了 FP8 与 BF16 的输入输出速度,并总结了端口冲突、上下文设置和接口安全等部署注意事项,最后给出将其用于写作第一轮辅助的定位。

技术 › LLM 小墨同学 2026-08-3017.2 KB 28.5K 40 82

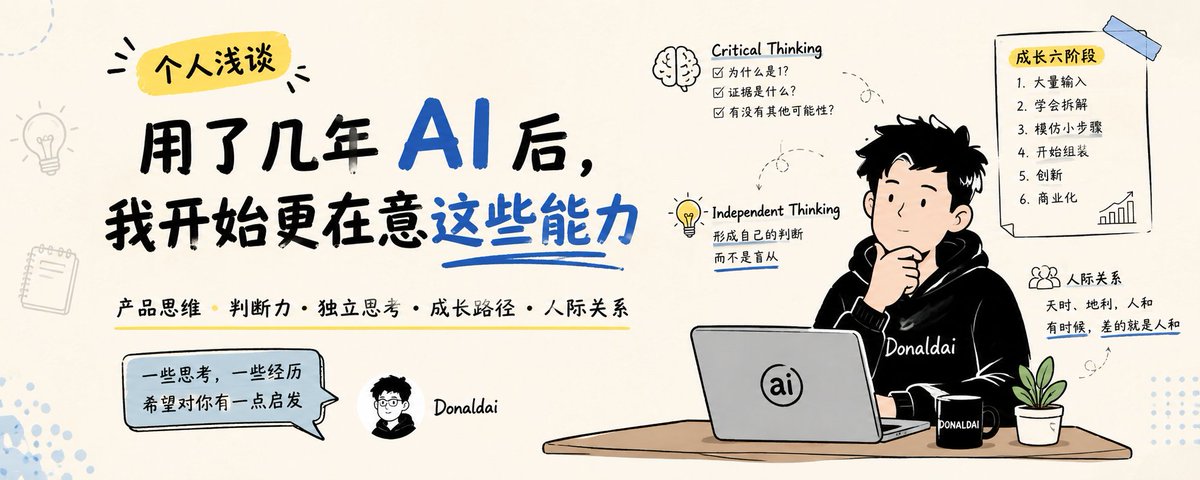
会用 AI 只是开始,真正拉开差距的是后面的能力

作者结合自己早期使用 GPT 的经历,指出会用 AI 只是起点,真正拉开差距的是闭环思维、产品思维、批判性思维和独立思考带来的判断力。作者认为产品是给人用的,而非功课式的完成任务,强调 output 与 outcome 的区别。他还提出成长的六个阶段:大量输入、拆解、模仿小零件、组装、创新、商业化。最后强调人际关系的重要性,并指出在 AI 越来越强的时代,判断力、质疑与修正能力才是最值得培养的「老派」能力。

技术 › LLM Donald AI 2026-08-3014.5 KB 2.6K 30 63

AIGC 冷知识:更长的提示词,准确率反而更低

文章探讨了提示词工程中的一个常见误区:提示词越长,生成结果不一定越准确。当提示词同时包含过多人物属性、颜色、物体数量和空间关系时,模型可能生成看起来不错却悄悄偏离关键要求的图片。文中通过长提示词与精简提示词加分步编辑的对比实验说明,约束越多,属性串位、关系混乱和细节遗漏的概率越高。DetailMaster 研究证实,随提示词长度增加,文生图模型在人物属性、位置和实体关系上的准确率一致下降。作者建议不要把提示词写成一次性需求文档,而应先用短提示词锁定主体和构图,再通过局部编辑逐层增加细节,每轮只修改一类变量。

技术 › LLM ViktorAI未来志 2026-08-305.1 KB 2.3K 10 74

一张图讲清 AI 推理内部流程:从发送请求到首 Token 输出

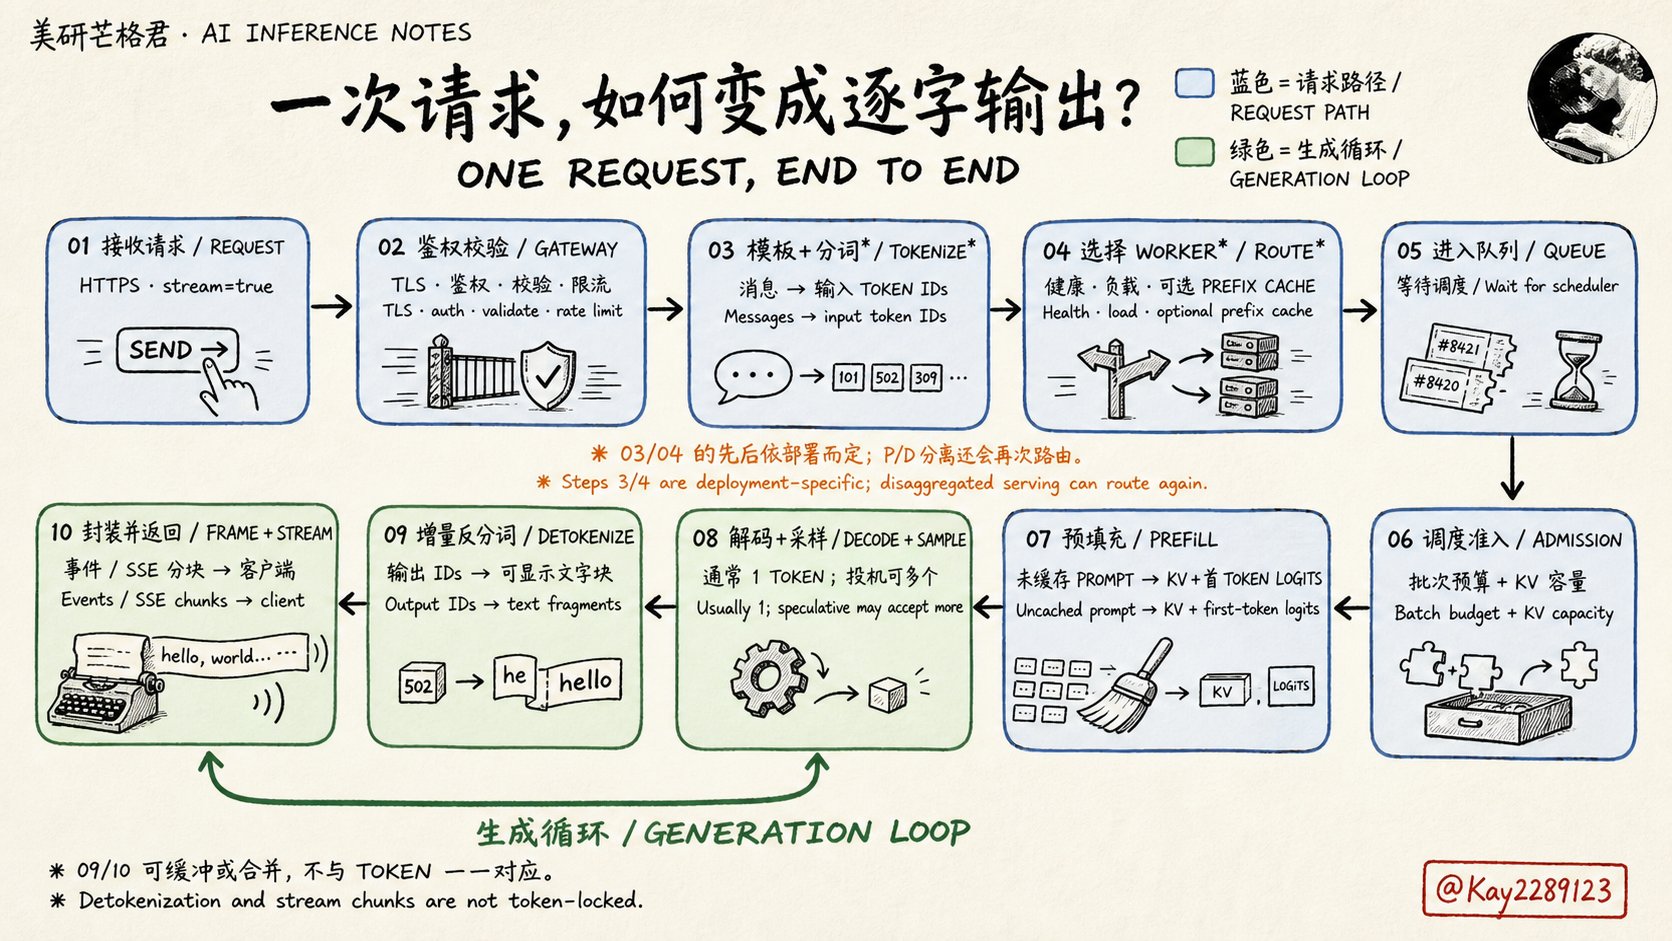
作者基于在硅谷大厂面试上百人的经验,介绍 AI 推理的完整内部流程:用户发送请求后,需经过 HTTPS 鉴权、模板化分词、路由排队与 KV 容量管理,Prefill 处理完未缓存的 Prompt 后才输出首个 Token,随后进入 Decode + sampling 循环,经增量反分词、SSE 分块返回客户端。作者强调 AI 推理不只是 GPU 速度问题,首 Token 延迟取决于并发排队与 Prefill 的均衡,持续输出取决于 Decode,需优化 KV Cache 以在有限硬件资源下服务更多用户。文中还提到帮团队成员规划了从 SDE 转型 AI infra 的 12 周学习路线。

技术 › LLM 美研芒格君 (@Kay2289123) 2026-08-302.0 KB 57

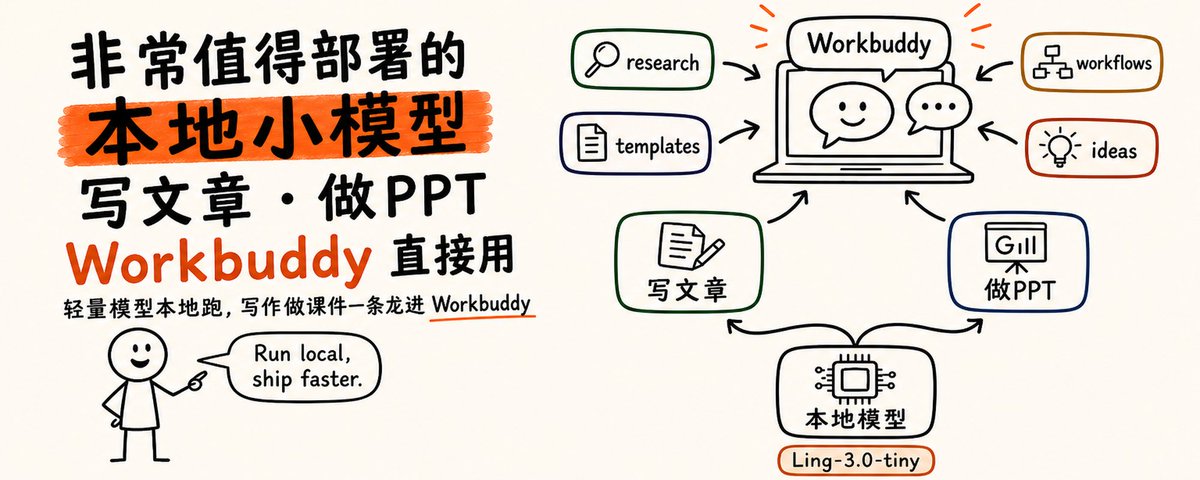
非常值得部署的本地小模型:写文章,做PPT,直接workbuddy里使用

文章介绍了蚂蚁刚开源的本地小模型 Ling-3.0-tiny(7.9B 总参数,每 token 激活 1.3B),在 Apple Silicon Mac 上的部署与实测表现。作者通过让 Cursor/Codex 自动部署 Rapid-MLX 的 4bit 版本,实测 M3 Max 上首字延迟约 55 毫秒,稳态解码约 110-125 tok/s,4bit 权重仅 4.2GB。该模型适合本机快速开发、大纲草稿、纪要压缩、做课件等短任务,也可接入 workbuddy 作为日常模型,但不适合复杂推理和长知识问答。文中给出了完整部署提示词、速度测试和文案处理实测案例。

技术 › LLM 产品经理老王霸 2026-08-307.4 KB 23.3K 74 77

BestBlogs 早报 · 08-30|腾讯开源 Hy4,Anthropic 员工用 Claude,携程推行代码即文档

本期早报聚焦 AI 能力如何进入真实任务并沉淀为组织资产。精讲一:腾讯发布开源大模型 Hy4 preview(770B 参数、激活 49B、1M 上下文),通过 CodeBuddy、WorkBuddy 等产品形成任务反馈闭环,并让模型参与推理系统自优化,端到端吞吐提升 31.8%。精讲二:Anthropic 分享员工在 Slack 中使用 Claude 的实践,通过明确搜索范围、匹配标准、事实核验与人工签字责任,把开放协作改造成可检查的工作流。精讲三:携程机票前端团队构建 Lumos,以 MR 为事件触发自动文档生成与向量知识库建设,人工维护文档时间下降 80% 以上。三条案例共同勾勒出「能力进入任务—过程接受核验—结果沉淀为资产」的完整实践路径。

技术 › LLM ginobefun 2026-08-3033.2 KB 6.8K 3 75

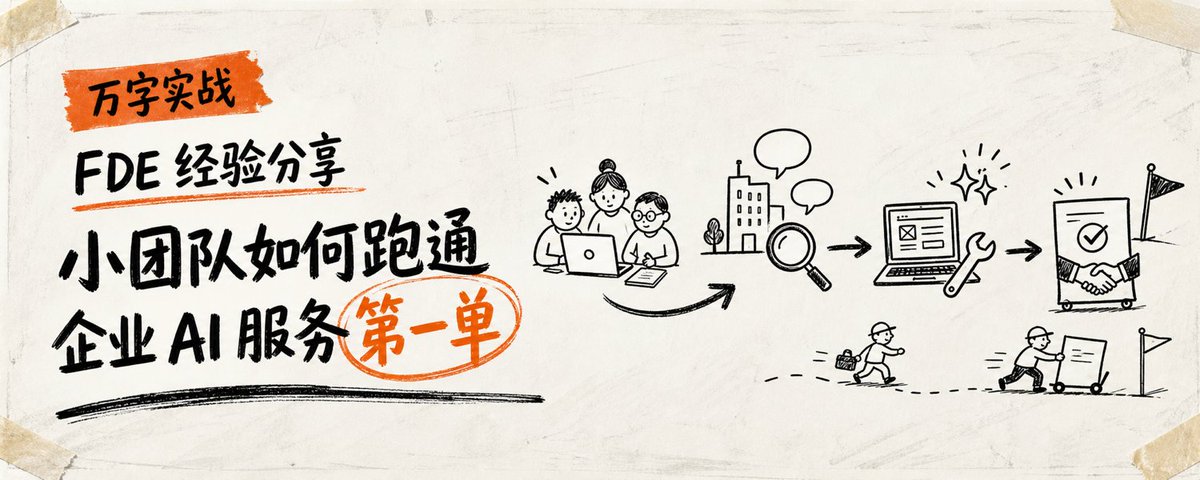
万字实战|FDE 经验分享:小团队如何跑通企业 AI 服务第一单

本文面向准备做企业 AI 服务的小团队(3-5 人),系统分享 FDE(前沿部署工程师)交付模式的实战经验。文章强调企业购买的是工作流结果而非 AI 功能,拆解了从获客筛选、需求访谈、付费诊断、报价结构、SOW 撰写到交付验收的完整流程。作者提出不应做免费 POC,而应按诊断、试点、生产部署、持续运营四层服务阶梯推进,并给出客户筛选表、报价表、验收指标等可复用模板,帮助小团队跑通第一笔可验收、可复用的企业 AI 项目。

技术 › LLM 朝朝(AI创业版) 2026-08-2930.8 KB 7.4K 114 82

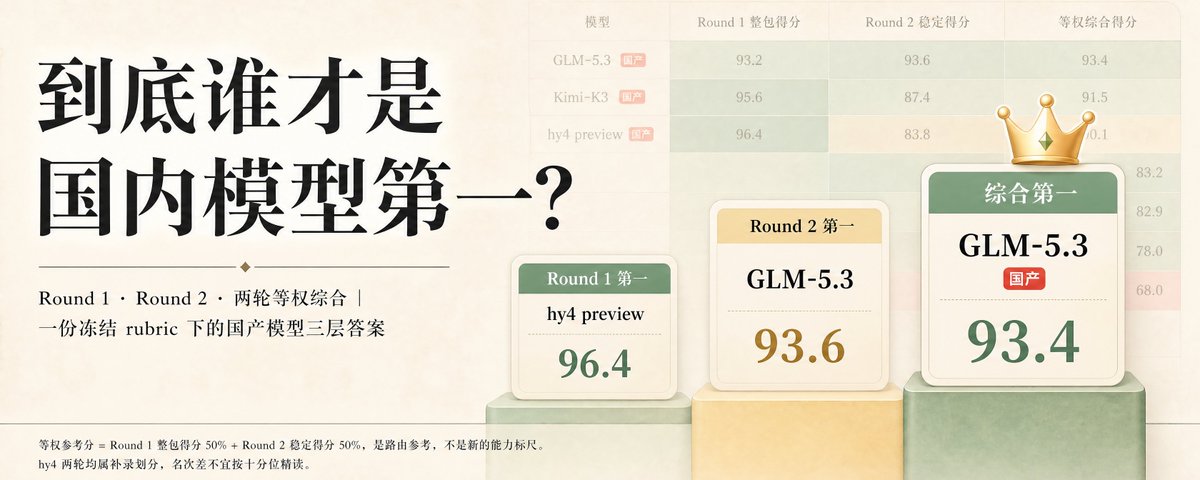
到底谁才是国内模型第一?

作者基于一份冻结 rubric 的自建评测(10 维 × 5 细项),通过 Round 1 超长整包和 Round 2 拆题稳定两轮测试对比八个大模型。Round 1 整包交付第一是 hy4 preview(96.4 分),Round 2 拆题稳定第一是 GLM-5.3(93.6 分);综合等权评分 GLM-5.3 以 93.4 分居国产第一,Kimi-K3 以 91.5 分列第二,hy4 因拆题时违反约束跌至 83.8 排第三。DeepSeek V4 Pro 与 Qwen3.8 Max 表现偏科,榜单前三均为国产模型。评测题面与方法已开源,结论是决定「第一」的不是最高一次成绩,而是每一次的稳定表现。

技术 › LLM huangserva 2026-08-2910.4 KB 228.8K 66 85

偏门赚钱神法:卖直播间场控小抄

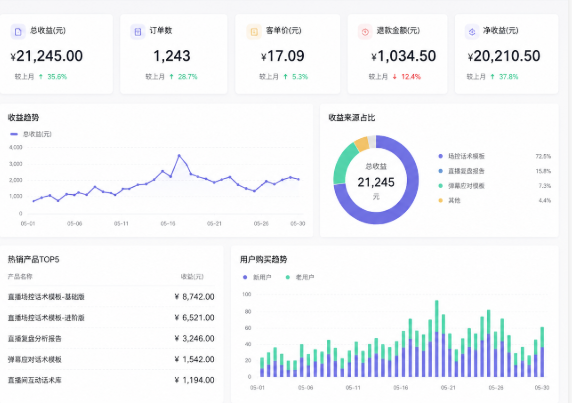
作者分享朋友的AI变现案例:用豆包+腾讯元宝为小主播生成带货话术和弹幕应对模板,三周收入2万多。买家是每天播4小时却不知如何接话的小商家。产品包括30套热场话术、砍价应对方案(宠粉版/限时版/库存版)、冷场互动问题和福利钩子,以及下播复盘建议。作者认为最有价值的是把'尬聊'变成流程,小商家不在乎用什么模型,只关心直播间效果。这种看似土的生意比很多AI项目更靠谱。

技术 › LLM 火山哥 (@huoshan007) 2026-08-291.5 KB 57

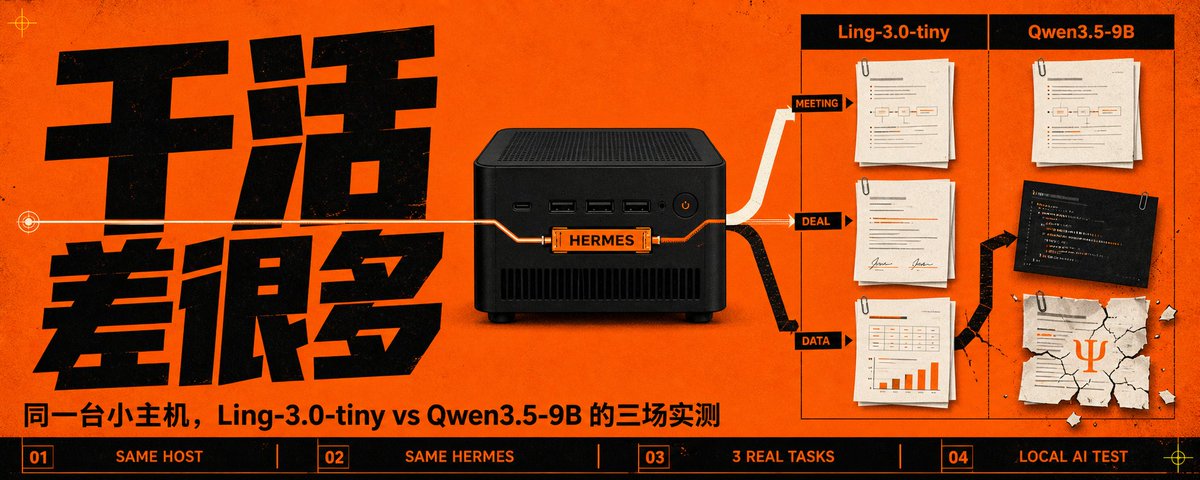
本地小模型实测!Ling-3.0-tiny vs Qwen3.5-9B

作者在 AMD Ryzen AI MAX+ 395 小主机上,用相同提示词和 Hermes 环境,对 Ling-3.0-tiny 与 Qwen3.5-9B(均 Q8_0、64K 上下文)跑三份真实业务任务:电商中台需求整理、商务合作决策备忘录、X 长文数据分析。结果 Ling 在前两轮抓住主线、输出可继续修改,总耗时仅约为 Qwen 的 56%;Qwen 在数据题上更稳,但商务任务两次失控,一次忘记任务、一次虚构公司实体。作者最终选择 Ling 作为默认模型,并强调应以模型最差一轮而非最好一轮作为取舍标准,同时收紧本地 Agent 的权限边界,保持人工把关。

技术 › LLM SakuAI 2026-08-298.2 KB 7.2K 20 83

H3 Prompt 实战:如何让 AI 真正理解“人物、镜头、动作、音乐”

文章分享了使用 H3 视频生成模型进行高分辨率俯拍镜头控制的提示词实战经验。核心技巧包括:将机位约束放在提示词最顶部以提高识别权重;明确接受俯拍导致的人脸透视变形,打破模型内置的人脸美化逻辑;直接禁止模型为美化人脸而将机位拉回平视的行为;使用 NO、DO NOT 等强否定短句代替解释性长文;保留原图的人物身份与服装参考,但完全替换原图机位、背景与灯光。作者强调,有效的提示词不是解释“什么是俯拍”,而是硬性禁止模型在高分辨率模式下自动修正机位和人脸透视的内部行为。

技术 › LLM AI Dance Paradise 2026-08-2923.6 KB 316.4K 302 80

图解大语言模型部署

本文系统讲解大语言模型自部署的核心指标与实践要点,覆盖延迟类指标(TTFT、TPOT/ITL、P95/P99)、吞吐类指标(TPS、QPS、连续批处理)、资源类指标(显存与KV cache计算、量化精度)、服务质量(错误率、探针、可用性)以及成本核算(cost per token、TCO)。作者以 Ling-3.0-Flash MoE 模型在 DGX Spark 上的真实实测为例,将抽象指标落地为具体数字,帮助读者选对硬件配置、排查吞吐瓶颈与OOM问题、评估自建与API的划算临界点。

技术 › LLM WquGuru 2026-08-2927.1 KB 56.2K 199 89

Agentic Kernels in Production

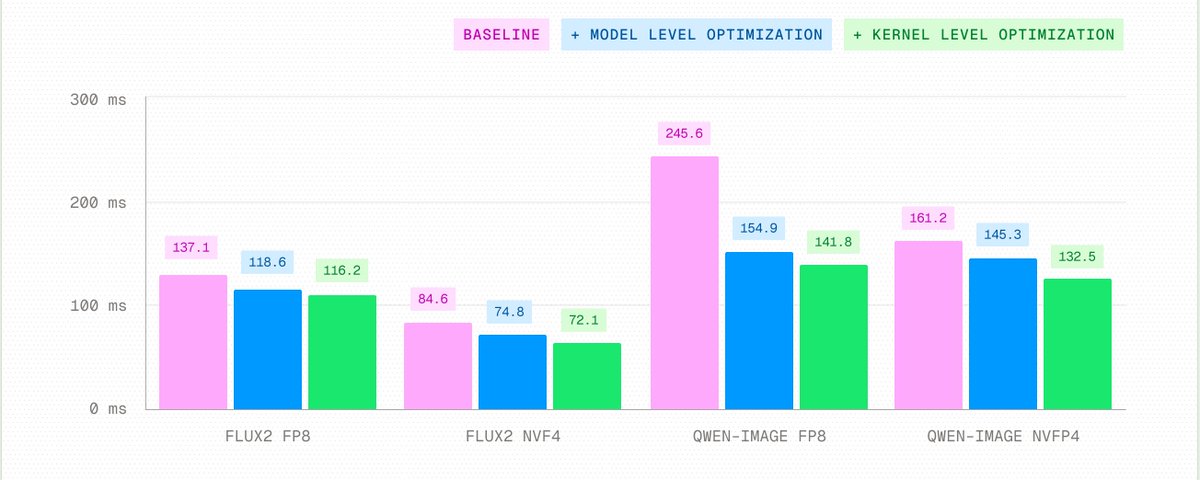
文章介绍了一个面向生产环境的 agentic kernel 优化框架,弥合基准测试与生产部署之间的差距。框架分为模型级优化和单 kernel 优化两层:先对完整 workload 进行 profile,提出算子融合、冗余消除等改进,再并行探索多个 kernel 实现并迭代优化。框架还具备自我改进机制,将成功与失败的优化经验存入知识库供后续复用。在实际部署中,该框架将 Qwen-Image 端到端延迟降低 42.3%,FLUX.2 降低 15.2%,MiniMax M3 吞吐提升 5.5%,具体优化包括 FP8 scale 预打包、QKV 投影融合、归一化与量化融合等。

技术 › LLM Brian Li 2026-08-2917.1 KB 265.1K 758 77

One person with AI outperformed an entire team

作者引用哈佛商学院的研究《The Cybernetic Teammate》,该研究对宝洁776名专业人士进行实验,发现单人配合AI能够媲美两人团队的绩效,相当于生产力翻倍。AI辅助的工作者速度更快、方案质量更高且更均衡,AI还抹平了专家与通才、资深者与新手之间的差距。更意外的是,使用AI的人报告了更高的积极情绪和更低的焦虑与挫败感。结合Mary Meeker报告显示AI职位增长448%,作者认为AI经济正在爆发,并提出个人应学会使用最新AI工具、把AI当作能力的放大器、定制自己的系统、并拥有可控的上下文管理中心,即他推广的Personal Context Management理念。

技术 › LLM Tiago Forte 2026-08-294.7 KB 69.6K 279 55