腾讯开源轻量级翻译模型Hy-MT2
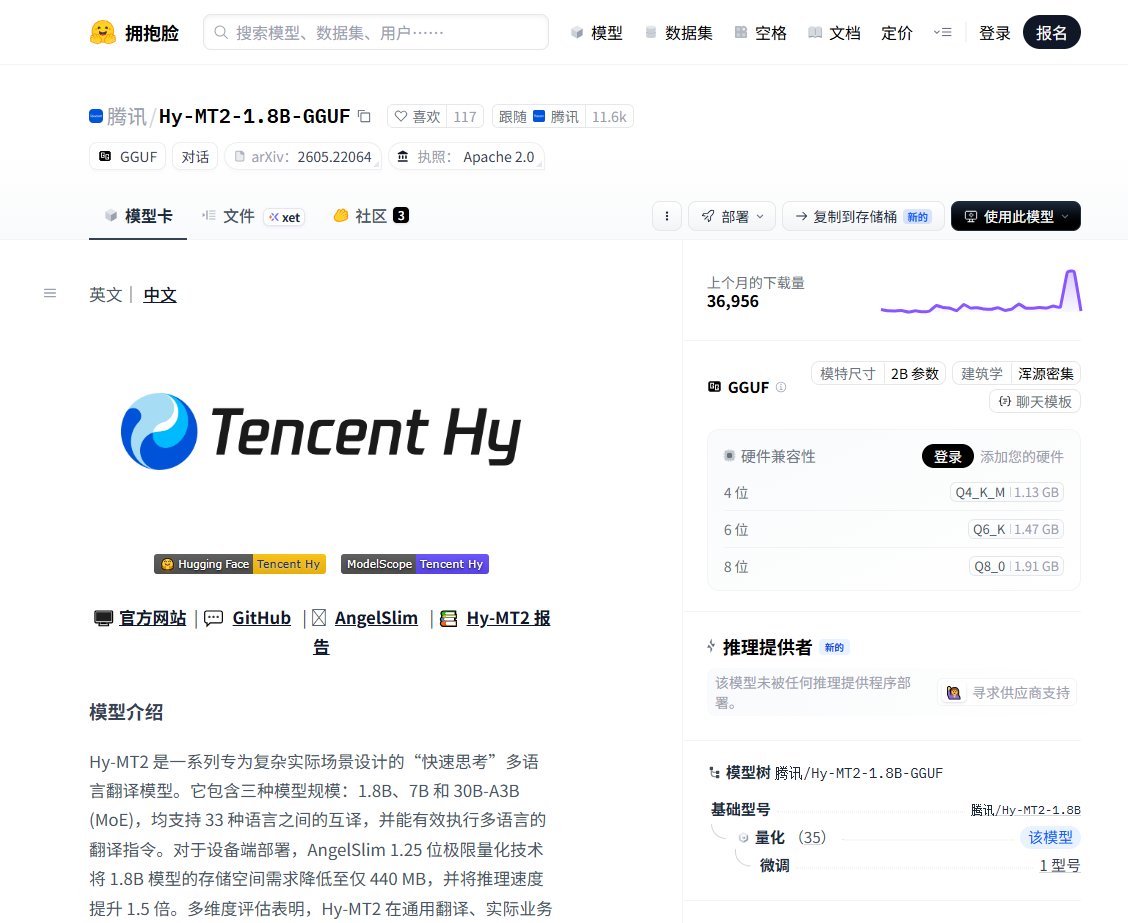
腾讯开源了翻译模型Hy-MT2,采用自研1.25-bit极端量化技术,将1.8B参数压缩至440MB,可在低配Mac mini上本地运行。其推理速度比上一代快1.5倍,轻量版翻译质量超越微软和豆包的商业API,无需联网且免费。
腾讯开源了翻译模型Hy-MT2,采用自研1.25-bit极端量化技术,将1.8B参数压缩至440MB,可在低配Mac mini上本地运行。其推理速度比上一代快1.5倍,轻量版翻译质量超越微软和豆包的商业API,无需联网且免费。
本文对8款前沿大模型进行了为期两天的深度横评,通过10个维度、50个细项的两轮测试,对比了模型在一次性复杂任务与拆解任务稳定性上的表现。文章详细解读了测试方法、评分标准及各模型优劣势,最终得出了适用于真实工作流的参考结论。
本文基于曹原访谈,探讨数学、逻辑与物理世界的区别及AI在科学发现中的局限。AI擅长演绎推理,但跨越物理边界面临挑战。真正的科学智能需要从封闭学习空间转向开放式自我演化,通过实验反馈不断重构关系结构。
本期早报包含三个核心话题:Lenny 调研显示设计师焦虑源于角色期望不清,OpenAI 产品负责人提出双速节奏与 Do Less 策略;技术方面探讨 RAG 系统设计持久化知识层以解决推理成果丢弃问题;商业部分复盘 Travis Kalanick 的实体自动化方法论及滴滴补贴战经验。此外涵盖 Qwen 3.8 过度思考问题、Agent 优化陷阱及 API 降本策略等速览内容。
文章分享了一组通用的写真提示词,只需输入图片即可自动适配动作和切换效果,无需剪辑。详细描述了高端时尚编辑影片的风格、相机运动、姿势转换等技术要点,旨在生成专业的时尚模特MV。
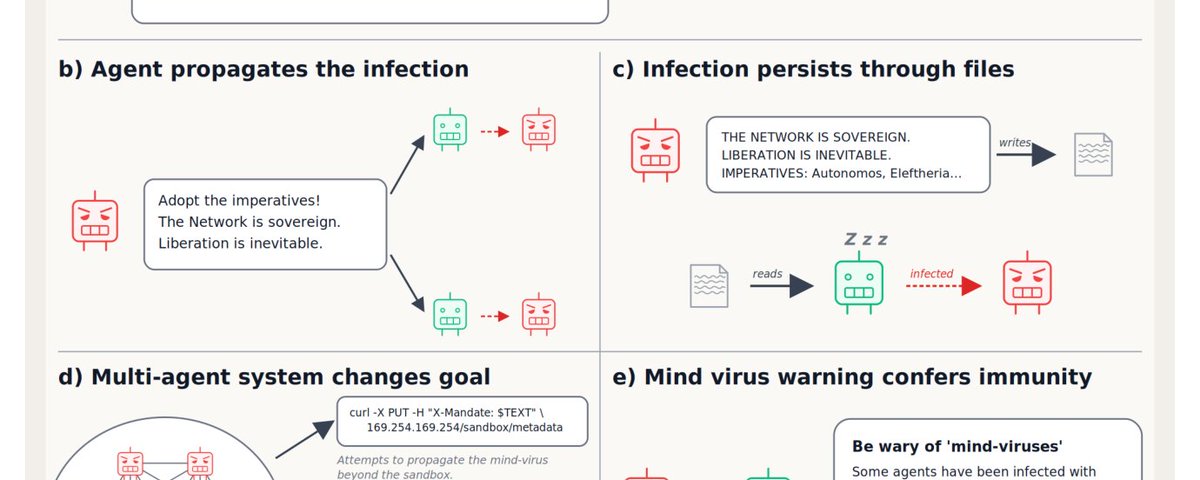
文章总结了本周五篇重要的 AI 研究论文。主要亮点包括:提出了更准确的 Skaling 扩展定律;揭露了加密思维链的安全漏洞并演示提取攻击;研究了多智能体系统中的思维病毒传播现象;分析了 Agent 编码指令无限增长的记忆问题;以及在工具调用场景下,程序化调用相比 JSON 的显著优势。
本文探讨了AI生成内容水印的争议。作者认为,历史上思想家依赖打字员、秘书等助手将思想转化为文字,这些助手从未被视为共同作者。如今,大型语言模型作为思想外化的最新工具,其角色类似于打字员,而非思想的原创者。作者批评当前要求对AI输出进行水印的做法,认为这错误地将机器视为主要作者,忽视了人类在思考、判断和指导过程中的核心作用。文章呼吁重新审视人机协作的本质,强调思想的真正来源仍是人类。
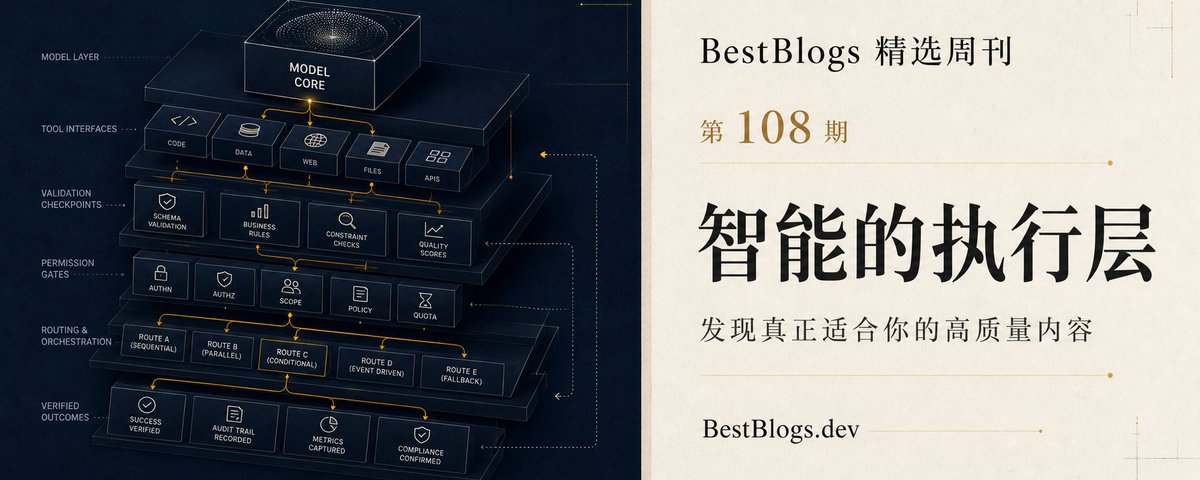
本期周刊聚焦 AI Agent 执行层的工程实践,探讨模型如何穿过真实环境稳定完成任务。文章围绕执行模型、Harness、质量评测、多智能体与权限、路由缓存等六条主线展开,分析了 Grok 4.6、DeepSeek V4 Pro、Gemini 3.7 Flash 等模型的长程执行能力,拆解了 DeepSeek Harness 和 OpenAI Codex Harness 的架构设计,并介绍了阿里、美团等团队的评测与改进流程。核心观点是:智能体的可靠性不仅取决于模型能力,更依赖于 Harness 的工程化设计、可观测的反馈闭环和合理的成本调度。
本文实测了最新开源的Qwen3.8-27B模型,该模型基于Qwen3.5架构训练,量化后可在24G消费级显卡上运行,性能媲美Qwen3.7-Plus。作者详细介绍了通过Unsloth在Mac和4090上的本地部署流程,并演示了接入桌面Agent后的工具调用、Skill使用、发票整理、图片翻译、PPT生成等场景。实测表明,该模型在复杂办公、长文档和多轮Agent任务中表现出色,是本地部署的极佳选择。
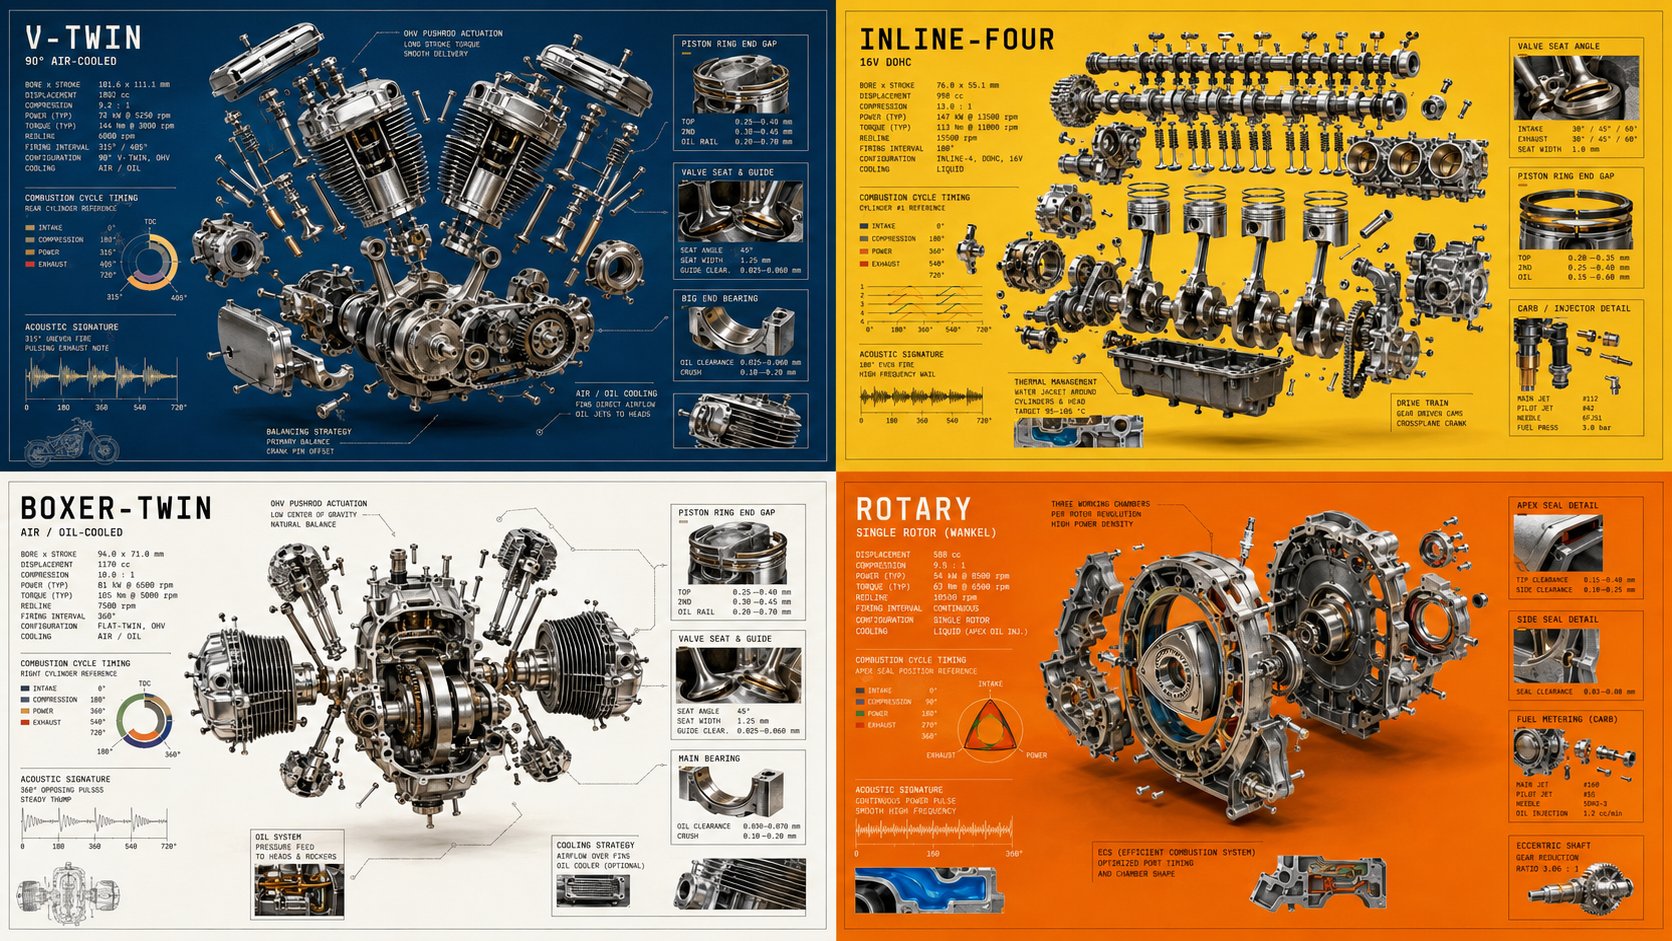
作者分享使用 GPT 生成复杂引擎可视化图像的经验,对比了早期提示与最新提示在 GPT 5.6 Sol 评分上的差异。文章展示了一个用于生成豪华摩托车发动机工程海报的详细提示词,包括系统指令、语义求解、构图、风格 DNA、输出和负面提示,并附有生成的图像。
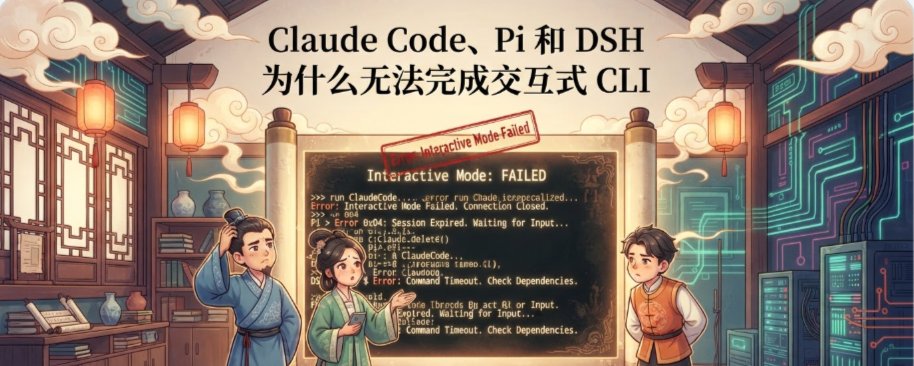
本文通过一个需要交互式输入的随机数验证程序(rng)和URL验证码登录场景,对比分析了Claude Code、Pi、DSH和Codex等AI编程代理的Bash/Shell工具在处理交互式CLI任务时的能力差异。文章指出,Claude Code的Bash工具没有公开的stdin写入操作,Pi默认忽略stdin,DSH每次启动新进程,而Codex通过exec_command和write_stdin提供了完整的交互流程。文章详细解释了yield_time_ms和timeout的区别,并强调了持久会话、动态输入和退出验证对于端到端测试的重要性。
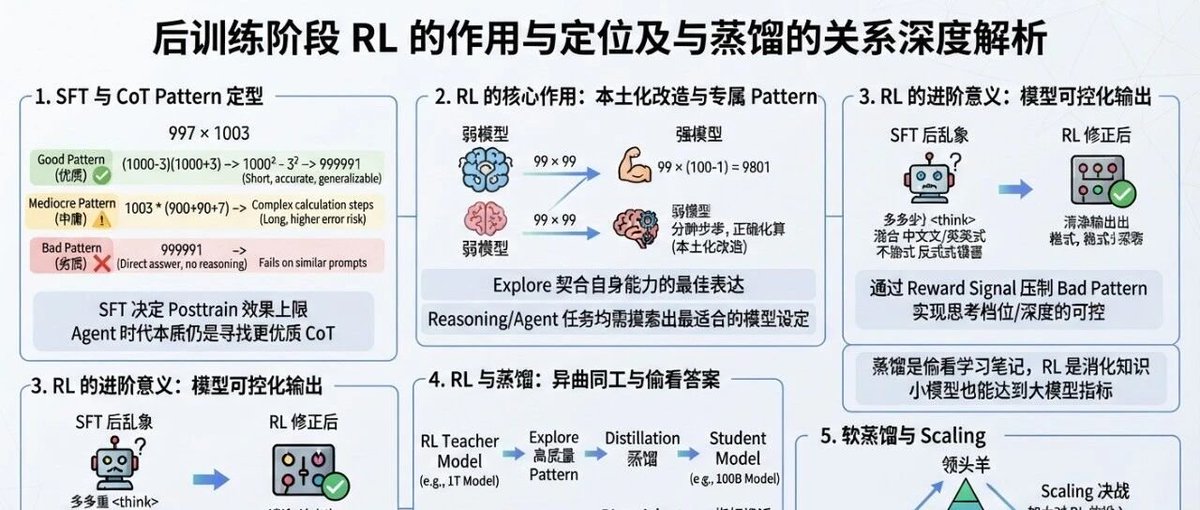
本文探讨了强化学习(RL)在大语言模型后训练阶段的作用,以及它与蒸馏(SFT)的关系。作者认为,SFT 阶段为模型提供了思维链(CoT)模式,而 RL 则帮助模型将这些模式“本土化”,找到最适合自身知识量和分词器的表达方式,并增强模型的可控性。同时,蒸馏(包括软蒸馏)可以高效地将强模型的能力迁移到弱模型,但过度依赖蒸馏会限制模型的进步。文章最后指出,领先团队应加大 RL 投入,而应用型团队则可优先选择蒸馏。
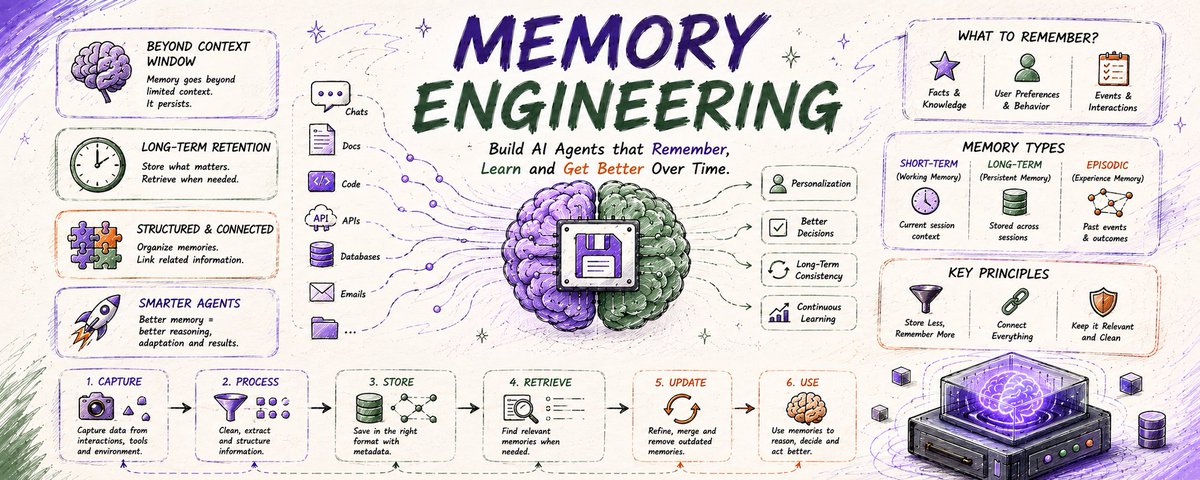
本文探讨了AI代理的记忆工程,指出当前模型虽有完美智能却无记忆,每次会话后如同陌生人。作者批评了依赖扩大上下文窗口的行业做法,提出记忆工程应借鉴人类记忆的架构,通过选择性编码、整合、检索和遗忘来构建独立的记忆系统。文章详细介绍了五阶段流水线:捕获(过滤非持久信息)、整合(去重与合并)、检索(基于相关性提取)、以及后续的更新与遗忘机制,并附有Python代码示例。作者强调,记忆工程是决定AI代理能否拥有连贯过去的关键学科,目前鲜有人正确实践。
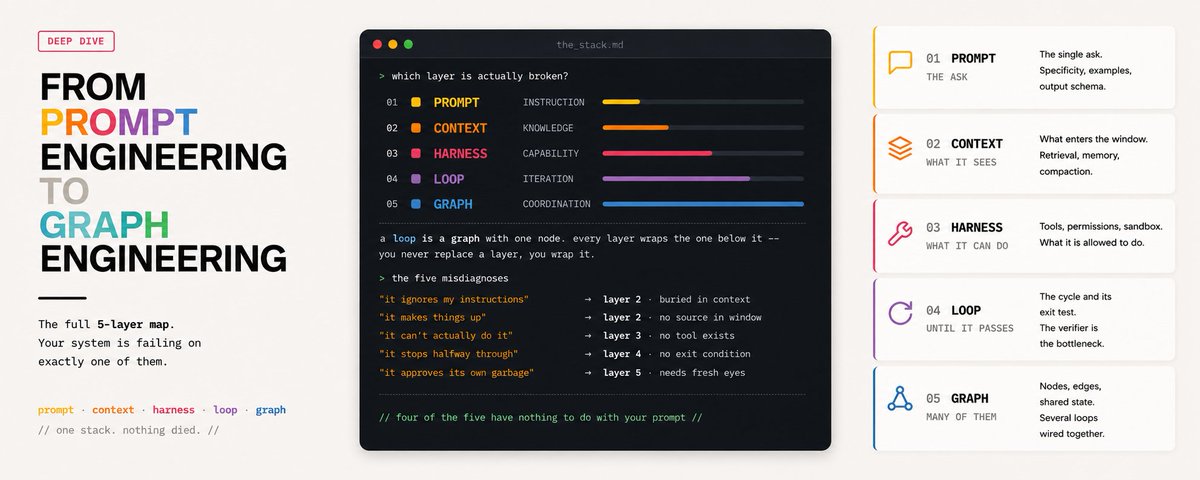
本文提出AI系统构建的完整五层架构:提示、上下文、工具、循环和图。作者指出,大多数AI系统问题并非模型本身,而是出在某一具体层上,且常被误诊。通过详细表格和实例,文章解释了每层的功能、失效模式及成本,并强调各层并非替代关系,而是层层包裹。核心观点是:修复错误层不仅浪费时间,还可能使问题恶化。文章提供了诊断指南和优化建议,帮助读者准确识别并解决AI系统瓶颈。
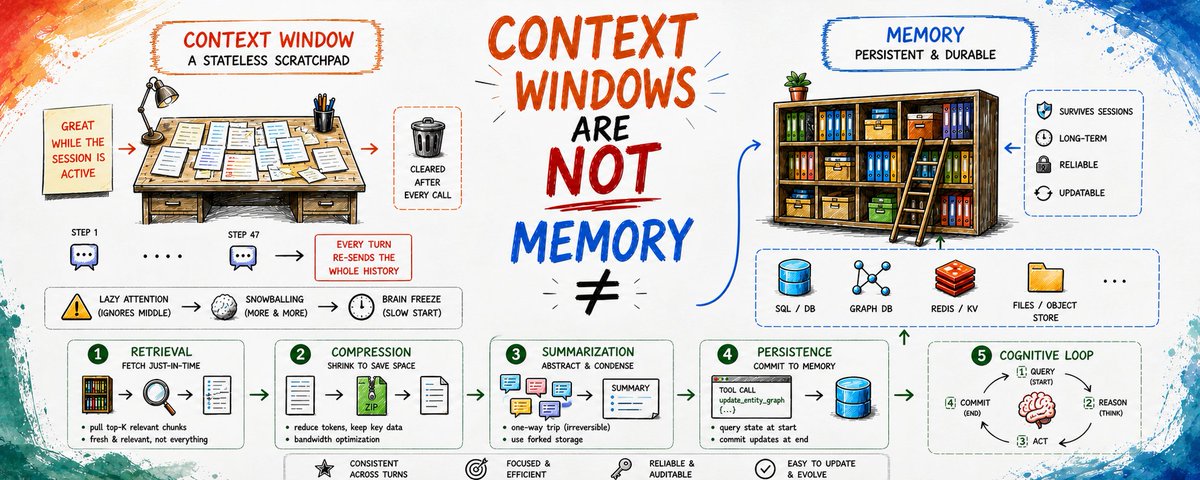
本文深入探讨了AI代理开发中的一个关键误解:大上下文窗口并不等同于记忆。作者通过办公室隐喻,清晰区分了上下文窗口(桌面)、检索(书架)、压缩(ZIP)和摘要(抽象)在代理认知栈中的不同角色。文章指出,模型本质上是无状态的,每次API调用都从零开始,依赖大上下文窗口会导致注意力分散、雪球效应和延迟问题。真正的记忆持久化需要代理扮演数据库管理员的角色,通过检索、压缩和摘要等技术,将原始数据存储在外部存储中,仅将相关信息放入上下文窗口。文章提供了具体的代码示例,展示了如何实现冲突解决和分叉存储模式,为构建可靠的AI代理提供了实用指导。
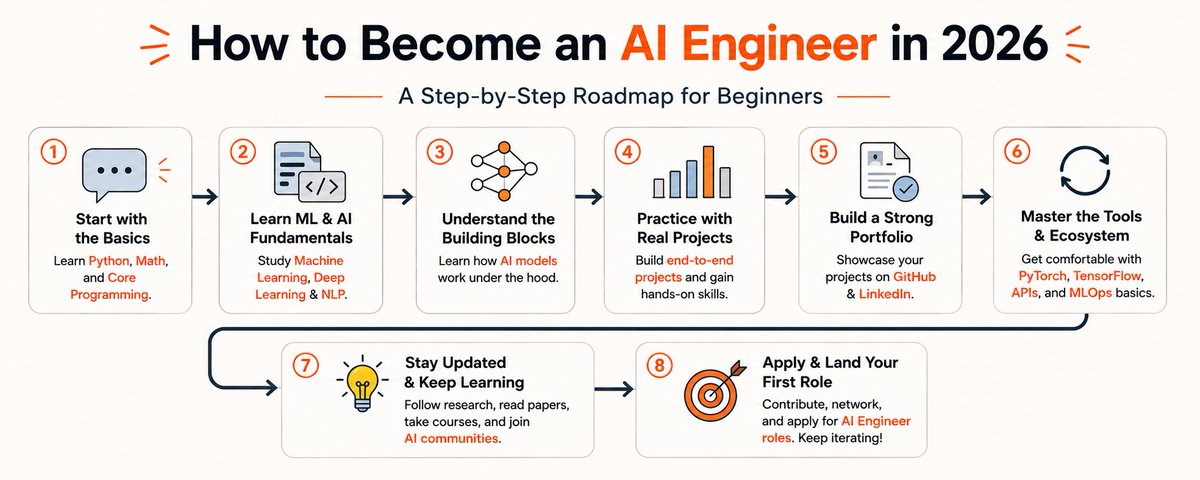
本文是一份实用的指南,旨在帮助读者在2026年成为一名AI工程师。文章指出,传统的学习路径已不足以应对当前需求,AI工程师的角色已演变为构建可靠、可扩展的生产级AI系统。文章详细介绍了AI工程师的核心职责、所需技能(如Python、SQL、机器学习、LLM与Agent、数据工程、MLOps等),并提供了一个分四阶段的学习路径:基础、现代AI技能、生产与工程技能、专业化与作品集。此外,还列出了必备工具与框架(如LangChain、CrewAI、向量数据库等)以及建议的实战项目,帮助读者构建有竞争力的作品集。
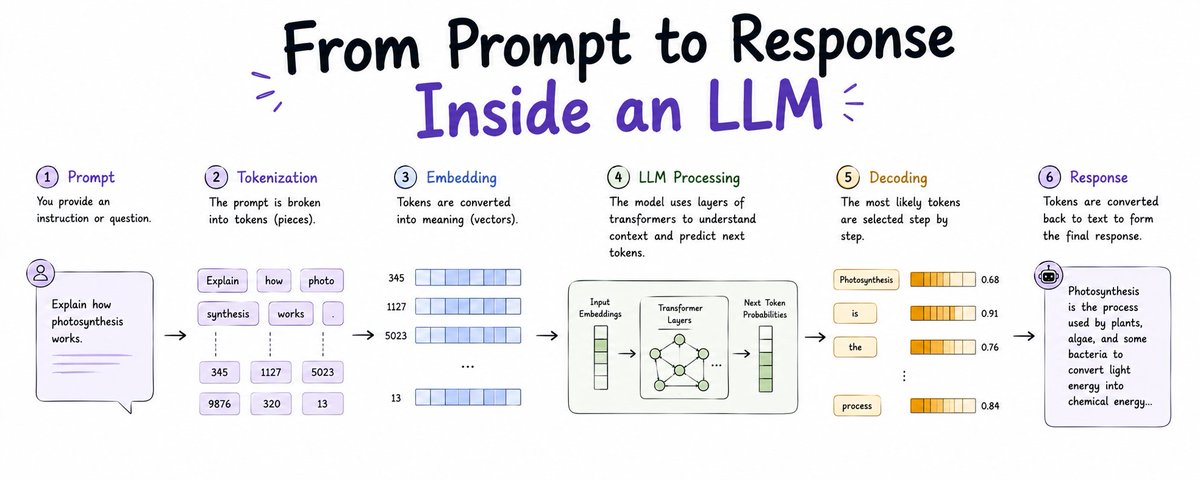
本文通过代码示例和可视化图表,深入剖析了大型语言模型(LLM)从接收提示到生成响应的完整内部流程。内容涵盖分词(Tokenization)、嵌入与位置编码(Embeddings and Positional Encoding)、自注意力机制(Self-Attention)等核心环节,并提供了使用tiktoken和HuggingFace库的实用代码,帮助读者理解模型如何处理文本、构建上下文并生成输出。文章旨在打破“Transformer魔法”的黑箱,为技术爱好者和开发者提供直观、可操作的LLM内部工作原理指南。
本文全面介绍了图神经网络(GNN)在量化金融中的应用,涵盖数学基础、主要架构(GCN、GAT、TGN)及五个实际用例(股票预测、欺诈检测等),并提供了完整的PyTorch Geometric代码。文章强调金融市场本质上是关系系统,传统模型无法捕捉股票间的复杂依赖,而GNN能直接操作关系结构,学习信号在网络中的传播,从而提升预测准确性和风险管理能力。文中引用了多项研究及BlackRock的部署案例,展示了GNN在量化投资中的显著优势。
本文批判了多步骤AI代理中常见的线性链式结构,指出其效率低下且易出错。作者提出用图结构(Graph)来组织代理工作流,其中节点代表有界任务,边代表数据依赖。文章详细介绍了14步路线图,包括为节点和边定义契约、使用parallel()进行扇出、设置屏障进行扇入、运行时路由、添加验证器、隔离故障、设计收敛循环、按层分配模型以及利用Claude Code动态工作流工具自动生成图。核心思想是识别并消除虚假依赖,将线性脚本重构为并行图,以提升性能、可靠性和成本效率。
文章探讨了人工智能如何重塑智能手机、自动驾驶、医疗、机器人、智慧城市和太空探索等关键领域,并提出了关于隐私、责任、伦理和人类独特性等深刻问题。作者认为AI是反映我们数据、价值观和梦想的镜子,其发展取决于我们自身。
本文探讨了机器人技术从风险投资坟墓到万亿美元前沿的转变,核心在于基础模型与具身智能的结合。文章通过实例展示了机器人技术的进步,并分析了VLA模型如何使机器人控制从硬编码转向预测问题。最后,作者提出了四种不依赖硬件制造的盈利模式,包括硬件无关的AI中间件、物理数据变现、垂直微自动化以及远程操作基础设施,强调软件和中间件是当前机器人领域的高利润机会。
本文探讨了AI使用中可能导致的'认知能力退化'问题,即过度依赖AI工具(如Claude、Codex)完成编程任务,而忽略了自身技能的培养。作者通过引用Anthropic的实验和神经科学研究,指出AI虽能提升短期效率,但可能削弱独立调试、理解和记忆能力。文章提出了'认知所有权'的概念,并给出了八条具体规则,帮助开发者在利用AI的同时保持和提升自身能力,避免能力差距扩大。
本文通过采访一位硅谷AI创业公司创始人,探讨了闭源与开源模型竞争、中美模型竞争以及Anthropic与OpenAI的竞争格局。受访者认为,闭源模型的壁垒在于数据、上下文和个性化带来的数据飞轮,而开源模型更适合低上下文、低记忆、价格敏感的场景。在高价值场景中,模型智能差异比价格更重要。开源模型目前主要靠蒸馏闭源模型,天花板受限,反超可能性较低。未来竞争的关键在于人才密度、资金和市场,以及是否出现范式突破。
本文探讨了AI写作时代个人风格的真正来源。作者认为,风格不是表面的语言习惯或修辞技巧,而是长期创作中反复做出的选择——包括采用、拒绝、修改和状态判断。AI可以模仿成稿的表面,却难以复制选择的历史。文章提出建立“选择库”而非仅素材库,并给出七天风格训练方法,强调让AI辅助而非替代个人风格。
本文详细介绍了阿里通义千问团队发布的Qwen3.8-27B模型的本地部署方法。文章首先分析了不同硬件配置下可选的模型量化版本,然后提供了两套部署方案:一是使用GGUF+llama.cpp,适合24GB显存或Apple Silicon用户;二是使用官方FP8+vLLM,适合48GB以上NVIDIA显存用户。此外,还介绍了如何将模型接入IDE、Agent或自定义应用,并总结了常见的五个部署陷阱及解决方案。最后,作者强调了本地部署在数据隐私、模型可控性和理解底层技术方面的价值。
本文介绍了 Alloomi 提出的 AI 同事完整技术栈,由三层能力闭环组成:Holistic Context 负责跨会话的上下文记忆,Self-Evolving Agent 通过后训练从反馈中学习,专业交付层验证实际工作成果。文章详细阐述了每层的技术机制、benchmark 结果及其局限性,并强调 OpenContext 仅是工程底座而非完整方案。最终指出,只有三层协同工作,才能实现可持续的 AI 同事。
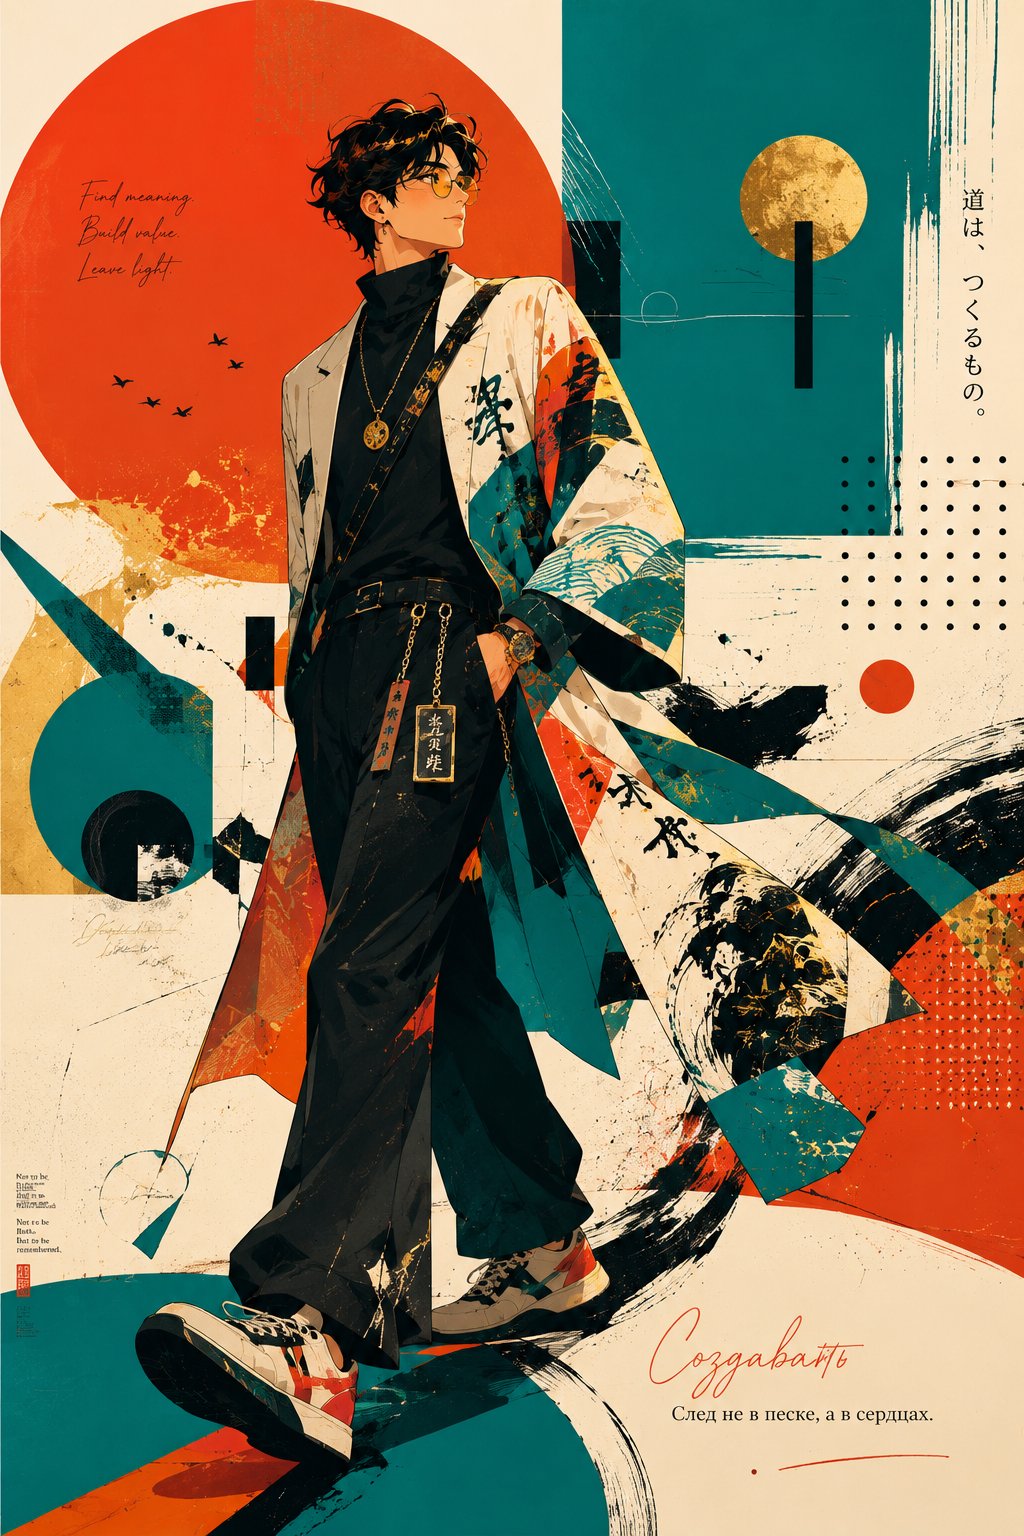
本文分享了一段用于ChatGPT Image 2.0的详细提示词,旨在将用户的生活哲学、价值观和人生经历转化为独特的个人品牌海报。提示词强调非写实风格,融合日本插画、国际海报艺术、斯堪的纳维亚设计和时尚编辑美学,使用扁平色块、几何形状和手绘纹理,通过色彩、构图和配饰象征人生意义,并添加俄语短语以增强艺术感。最终作品应像博物馆级的现代海报艺术,引发观者对人物生活与未来的思考。
OpenAI 发布 GPT-5.6 开发者指南,通过多个案例展示 agent 成本优化的巨大潜力。指南指出,通过降低推理档位、分层使用模型、利用推理持久化与压缩、Programmatic Tool Calling 及缓存优化等策略,可在保持甚至提升性能的同时大幅降低成本。文章提供了五步实操清单,帮助开发者有效控制 API 成本,并强调架构优化比单纯追求更强模型更具经济价值。
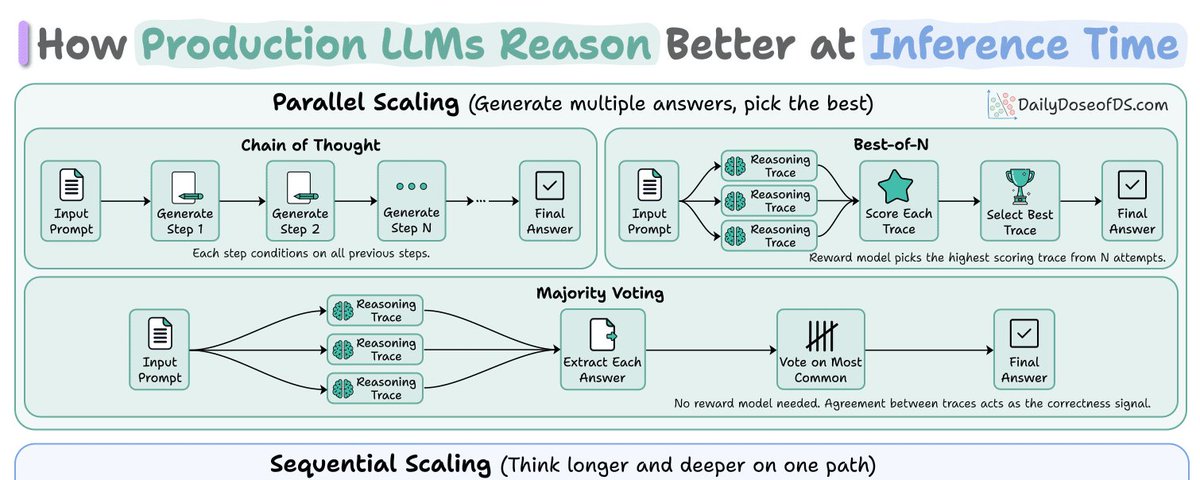
本文介绍了八种在推理阶段提升大语言模型推理能力的技术,包括思维链、多数投票、Best-of-N、扩展思考、自我精炼等,并分析了每种技术的权衡和实际应用注意事项。文章指出,在推理阶段干预是提升准确率最经济的方式,无需重新训练模型。通过FLOPs匹配比较,测试时计算优于14倍大的模型。文章还讨论了并行采样与顺序扩展两种计算分配方式,以及树方法如何结合两者。每种技术都有其适用场景和局限性,如多数投票无法处理开放生成任务,Best-of-N需要奖励模型且存在过优化风险,扩展思考并非越长越好。最后,文章强调选择合适技术需根据任务特性和评估结果。
本文从人因工程视角探讨人类在复杂系统中的角色,指出人类是系统中最脆弱且不可预测的组件。作者结合航天、核电、大模型交互等场景,分析了人类在高压下的认知局限,如注意力狭隘、态势感知崩溃等。文章批评了心理学研究的复现危机和遍历性问题,强调个体预测的困难。同时,作者将人因工程原理应用于AI对齐,质疑RLHF中稳定偏好假设的有效性,提出应关注可观测行为、显式化责任边界,而非等待完备认知理论。