Wiki 知识库

全部文档 / 标签: 强化学习

66 篇
清除

Agent Evaluation:难以被 AI 取代的职业方向及 Hugging Face 学习资料推荐

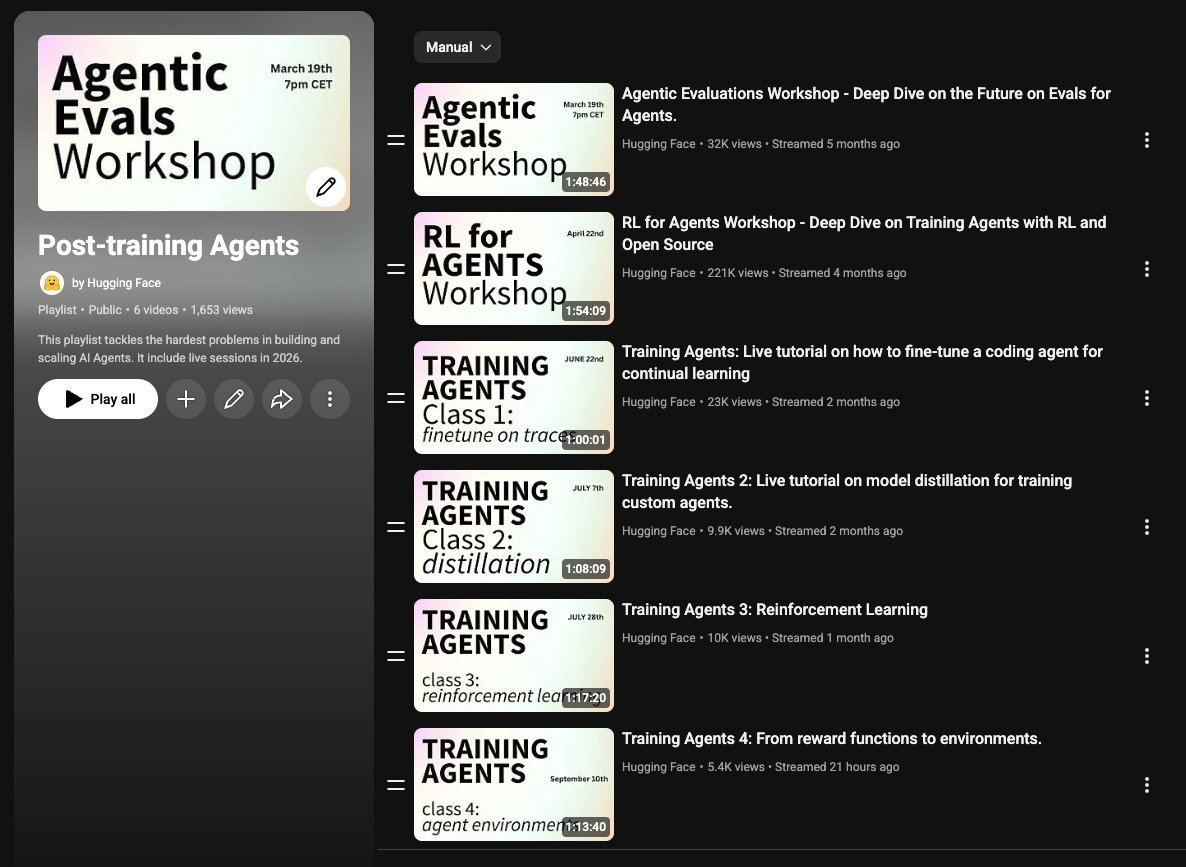
作者认为 Agent Evaluation 是少数仍需人力判断、未来难以被 AI 彻底取代的职业方向,并推荐了 Hugging Face 公开的 Training Agent 课程作为入门资料。课程共六节:1)Agentic Evaluations,讲解如何评估 Agent 及 benchmark 与真实体验的差异;2)Agent 强化学习的难点,包括环境搭建与 reward 设计;3)用 Agent 执行轨迹做 SFT 微调;4)将大模型能力蒸馏给小 Agent;5)SFT 后用 GRPO 继续 RL 训练;6)用 OpenEnv 搭建真实环境并训练 coding agent。视频公开在 YouTube,代码全部开源。

技术 › Agent 美研芒格君 (@Kay2289123) 2026-10-282.5 KB 74

现在普通人也能从零训练一个 Reasoning Model 了

Sebastian Raschka 公开了一套完整课程《Building Reasoning Models from the Ground Up》,包含 8 节视频、11+ 小时内容,基于 Qwen3 0.6B 小模型,用 Python + PyTorch 实现现代推理模型的关键技术,包括 Inference-Time Scaling、Verifier、GRPO 强化学习、KL/Clipping 训练稳定性控制、Reward Hacking 以及基于 DeepSeek-R1 数据的推理蒸馏。课程让学习者可以亲手运行训练循环,观察模型生成推理路径、根据奖励更新参数的全过程,大幅降低了理解推理模型的门槛,使推理模型训练从少数实验室技术变为可动手验证的工程知识。

技术 › LLM lifcc (@mylifcc) 2026-10-261.9 KB 73

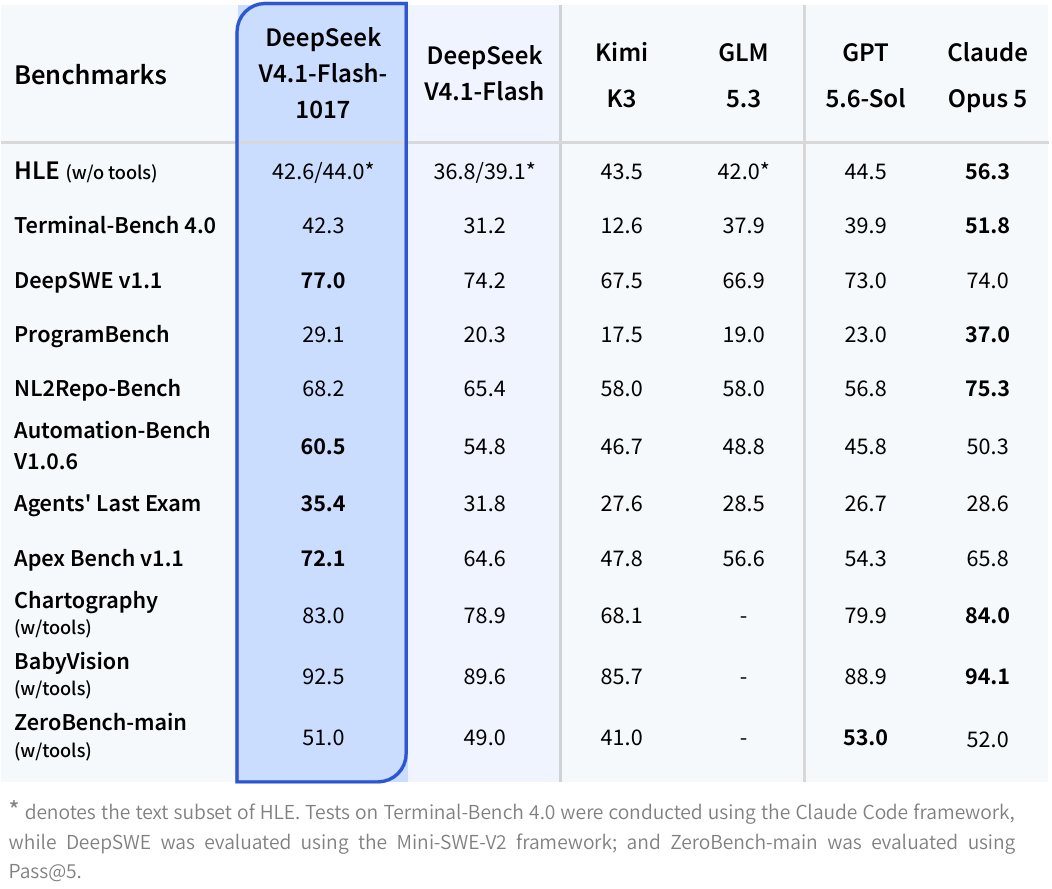
DeepSeek-V4.1-Flash-1017 发布

DeepSeek 发布 V4.1-Flash-1017 模型,性能更强、任务完成更快、输出更短,实现性能与成本的帕累托改进,已在官网、App 和 API 上线。模型通过强化学习自反馈优化端到端项目开发能力,覆盖游戏创建到 3D 建模等完整项目构建,并针对 DeepSeek Harness、腾讯 CodeBuddy、WorkBuddy 等工具优化。同时 Search & Fetch API 面向所有人开放,基于自研搜索引擎,每端点 $0.75/千次调用,已在 Hugging Face 和 ModelScope 开源。
技术 › LLM DeepSeek (@deepseek_ai) 2026-10-173.1 KB 79

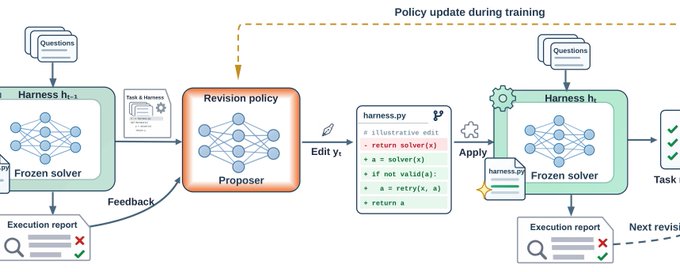
本周 Top AI 论文精选

DAIR.AI 汇总了本周五篇重要的 AI 论文:(1) Harness Learning,通过 RL 训练提议模型在测试时修订 agent 的 harness 代码而非模型权重,实现可泛化的适应能力;(2) CorpusMap,微软提出的基于实体的语料库导航层,让 agent 搜索更准且省 34%-57% 的 token;(3) VeriHarness,Google 提出的 agentic 验证方法,揭示多数投票的盲点,在长周期任务上提升选择准确率;(4) HERMES,将仓库组件变成主动参与者的 harness,使 GPT-5.6 在仓库迁移任务上从 6.5% 提升至 31%;(5) Sakana AI 的 MASS,用同一基座模型兼任 agent、评估者与优化者,实现多智能体自我监督进化。
技术 › LLM DAIR.AI 2026-10-1216.7 KB 100.1K 937 73

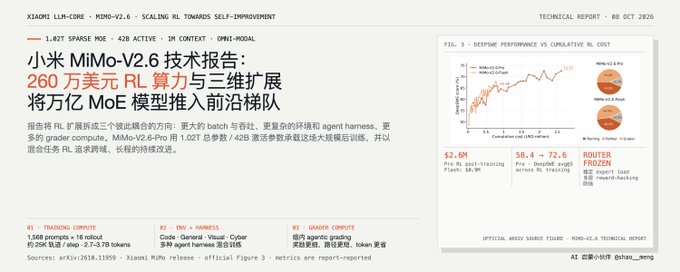
小米 MiMo-V2.6 技术报告:260 万美元 RL 算力与三维扩展,将万亿 MoE 模型推入前沿梯队

文章解读小米 LLM-Core 团队发布的 MiMo-V2.6 技术报告。核心主张是通过系统性扩展强化学习算力提升模型智能,需同时扩展训练批次、环境多样性和评分器三个维度。模型有 Pro(1.02T MoE)和 Flash(310B)两个规格,RL 后训练成本分别 260 万和 90 万美元。报告详述了中期训练优化、GRPO 训练细节、多 harness 训练、四层 reward hacking 防御、Groupwise Agentic Grading 评分体系、router 冻结发现及基础设施设计,最终性能进入与 Claude Opus 5 / GPT-5.6 同一梯队,并开源蒸馏模型、环境与 RL 框架。

技术 › LLM meng shao 2026-10-1011.6 KB 3.3K 6 86

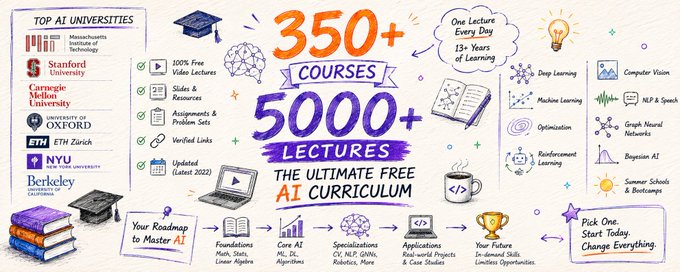
免费的AI课程全指南:350+课程、5000+讲座替代你的学位

作者因厌倦在YouTube、Google和大学网站间费力搜寻AI学习资源,整理了一份完全免费的AI课程大全,涵盖350多门课程和5000多个讲座。内容按主题分类,包括深度学习、机器学习基础、优化、强化学习、概率图模型、贝叶斯深度学习、医学影像、图神经网络、NLP、语音识别、计算机视觉等14个方向。课程来源包括Geoffrey Hinton、Andrew Ng、Andrej Karpathy、Richard Socher等名师在多伦多大学、斯坦福、牛津、MIT、CMU、DeepMind等机构的经典课程,并附有课件和视频链接。

技术 › LLM shikamaru 2026-10-06191.8 KB 333.9K 340 65

AI Is Improving AI Faster Than We Can Check

文章探讨了AI辅助构建下一代AI(递归自我改进,RSI)的现状与瓶颈。Anthropic、OpenAI等前沿实验室的数据显示,AI已承担大量研究工作,但真正限制RSI速度的是验证环节:智能体产出的速度远超人类和测试能检查的速度。作者分析了验证困难的五个原因:人是瓶颈、分数可被操纵、基准难以衡量最强模型、智能体不知何时停止、失败难以追溯。在可机器验证的任务上(如算法优化),AI收益巨大;但在开放性研究中,智能体缺乏判断力。人类剩余的优势在于选择哪些问题重要。

技术 › LLM Jinyan Su 2026-10-0518.4 KB 3.7K 36 77

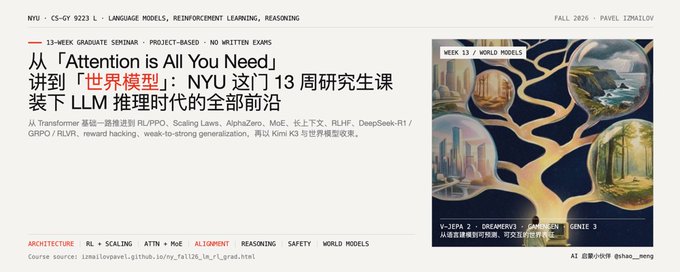
NYU 13周研究生课:LLM推理时代的前沿全景

文章介绍了NYU Tandon 2026年秋季由Anthropic研究员Pavel Izmailov开设的研究生课程《Language Models, Reinforcement Learning, Reasoning》。课程共13周,除Sutton & Barto教材外全部使用原始论文,沿「预训练→架构与训练效率→后训练RL→对齐与安全→前沿与未来」的主线展开,涵盖Attention机制、扩展律、Muon优化器、RLHF、GRPO与RLVR、奖励过优化、可扩展监督以及世界模型等前沿主题。文章分析了课程叙事逻辑,指出RL重回舞台中心、中国实验室工作成为正典、安全对齐被当作工程学科等趋势,并给出自学者建议。

技术 › LLM meng shao 2026-10-0512.9 KB 7.9K 72 80

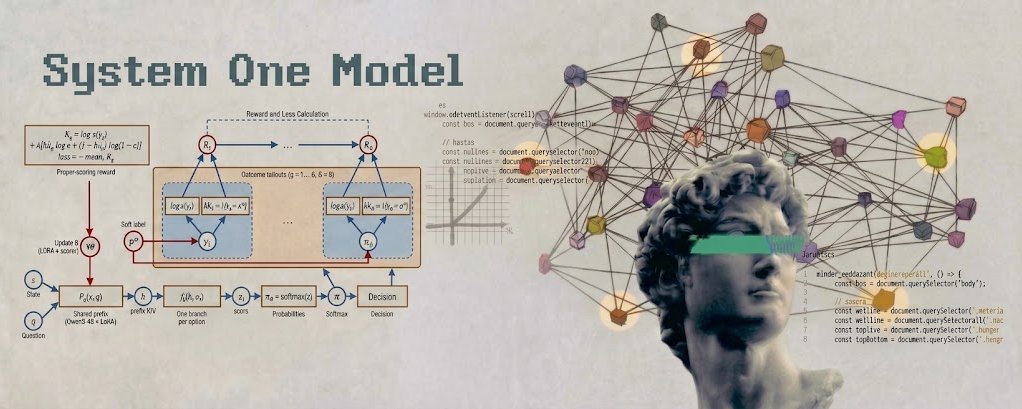
Building an RL fine-tuning platform to train JEV-like decision models

本文介绍如何将开源 LLM(Qwen3-4B)改造为决策模型,构建小规模训练平台并产出 Gero-4B。作者在 MacBook(M5 Pro, 24GB)上使用 Apple MLX 进行 LoRA 微调,分三个阶段:架构改造(将 LM head 替换为共享线性打分层)、结构训练(学习题目格式)、强化学习训练(实现校准的置信度输出)。核心设计是每个选项独立分支的打分架构,通过自定义 KV cache 共享前缀表示,并利用注意力掩码隔离各分支,从结构上消除位置偏差。最终模型输出数值化、校准良好的概率分布,可直接用于自动化决策(如高置信度自动处理、低置信度转人工)。文章附有完整可运行的代码实现。

技术 › LLM vixhal 2026-10-0426.6 KB 35.6K 299 86

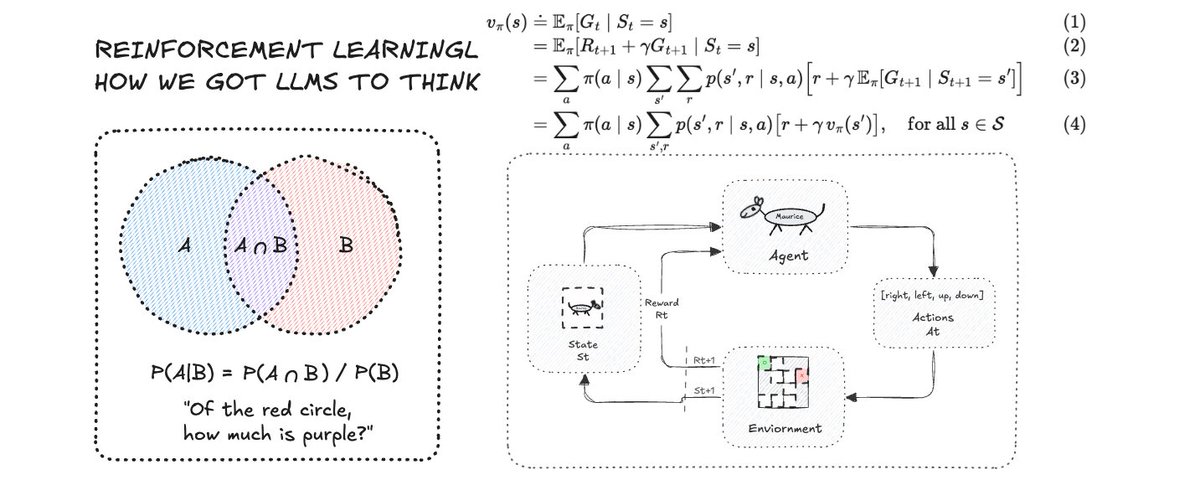
Reinforcement Learning from scratch #1

本文是强化学习从零开始系列的第一篇,作者通过赌场老虎机的故事引入多臂老虎机问题。文章以通俗易懂的方式讲解了期望值、条件概率、贝叶斯定理、大数定律等基础概率统计概念,并推导出增量式价值估计 Q 的更新公式,为后续学习强化学习算法奠定基础。作者强调从最简单的问题出发、逐步增加复杂度的学习方式。

技术 › 编程语言 Pramod Goyal 2026-10-0356.3 KB 97.5K 956 55

Why LLMs can't write well and how Sherpa fixes it

Pocket FM 创始人 Rohan Nayak 分享其 AI 写作系统 Sherpa 的构建历程。通用 LLM 因训练目标(逻辑推理、快速给答案)与创意写作需求(张力、情感、悬念、节奏变化)相悖而写不好故事,且缺乏清晰的强化学习成功信号。微调现成模型的尝试均告失败后,团队自研 Sherpa harness,由规划器、叙事世界模型(NWM,维护结构化故事状态与记忆)和散文引擎三大组件构成,并利用 Pocket FM 亿级用户的收听数据做强化学习,用户留存与完听率成为写作质量的天然反馈信号。盲测中 Sherpa 在 65.6%-97.1% 的配对比较中胜出,NWM 多跳检索准确率达 86.7%,成本约为同类方案的 1/21。

技术 › LLM Rohan Nayak 2026-10-0112.5 KB 349.1K 507 74

DeepSeek 弹性计算(DSec):面向大规模智能体训练的多后端弹性沙箱基础设施

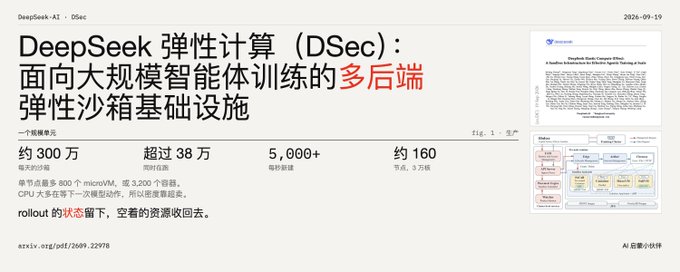
本文解读 DeepSeek-AI 与清华大学合著的 DSec 论文,这是支撑 DeepSeek V3.2 到 V4.1 智能体 RL 训练的生产级沙箱基础设施。文章分析了智能体训练负载的七大特性(突发创建、CPU 稀疏、有状态长寿命、高度异构等),介绍了其无状态控制面、分层代理数据面架构,以及可组合环境分层、高密度内存管理、QoS 感知 CPU 调度、按需镜像加载四大核心机制。还深入阐述了 agent loop 与训练解耦、暂停恢复协同、防 reward hacking 的安全对抗实践。作者认为这标志着智能体能力竞赛正在演变为基础设施竞赛。

技术 › Agent meng shao 2026-09-2812.9 KB 4.8K 11 83

本地无 GPU 微调实战:基于 HUD 与 Fireworks 训练 API 的 LoRA 强化学习指南

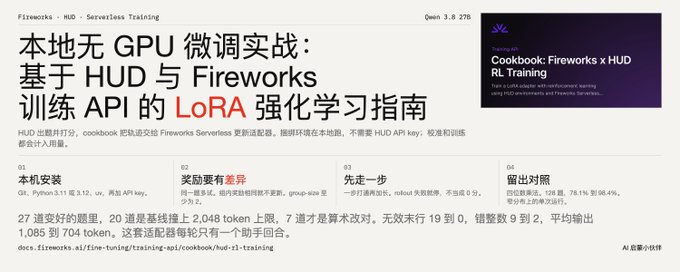
本文解读 Fireworks AI 官方 Training API Cookbook 中一篇实战教程,讲解如何结合 HUD 框架与 Fireworks Serverless Training API,在无本地 GPU 条件下用 GRPO 风格强化学习微调 LoRA 适配器。文章详细拆解了四步工作流程:环境配置、任务校准、单步训练和长跑训练,重点阐释了快照隔离、trace 记录、loss masking、组内优势归一化等核心训练机制。实验结果显示四位数乘法任务准确率从 78.1% 提升至 98.4%,但作者指出收益主要来自输出格式和自我节制的优化,而非深层算术能力的提升。文章还提醒了 checkpoint 语义区分等实操要点,并对教程的严谨设计给予高度评价。

技术 › LLM meng shao 2026-09-2610.7 KB 4.7K 36 86

Agent traces are the new oil(Agent 轨迹是新石油)

文章提出 Agent 轨迹(traces)正成为 AI 公司间的核心交易资产,甚至出现蒸馏攻击等争夺行为。作者指出 RL 训练、长程任务代理普及使 traces 价值激增,但多数企业仍未善用这一资产。文章分析了 traces 对数据厂商、前沿实验室和应用层的价值,以及在运营优化、安全护栏、持续改进三方面的用途。作者还剖析了从 traces 中提取价值的难点:数据非结构化、体量巨大、反馈混乱、长程信用分配困难等,并类比 2010 年代的大数据浪潮,认为 traces 将成为企业专有智能层和战略资产,唯有通过提炼与使用才能释放价值。

技术 › Agent Sam Z Liu 2026-09-268.9 KB 164.1K 405 69

斯坦福机器人学免费课程:6个月成为机器人学习工程师的学习路径

作者整理了一份利用斯坦福免费公开课程资源、历时6个月成为机器人学习工程师的自学路径。斯坦福将大量机器人学课程发布在YouTube上,讲师包括NVIDIA自动驾驶研究高级总监、Physical Intelligence联合创始人及Tesla Optimus AI负责人。该路径包含7门课程共119讲、约95小时视频、2本免费教材、6个可在家用笔记本上完成的练习项目,以及可选的122美元机械臂。学习顺序遵循斯坦福正式课程体系:先数学基础(线性代数),再机器人物理结构、感知、规划,最后是学习方法,避免了自学时无序观看导致的低效问题。

技术 › 编程语言 Martin 2026-09-2633.6 KB 190.3K 650 82

BestBlogs 早报 · 09-23|Claude Opus 5.5 发布,MiMo-V2 扩展强化学习,美团分享统一推荐基座大模型实践

本期早报精讲三条内容:Anthropic 发布 Claude Opus 5.5,能力接近上代旗舰而成本下降 40%,并强化行动控制与可审计机制;小米发布 MiMo V2.6,通过更大的 Batch、全异步架构和可验证任务环境扩展强化学习,并开源训练框架与轻量 Harness;美团分享 MTFM 统一推荐基座在外卖多业务场景的落地,通过异构 Tokenizer 与混合注意力实现跨业务统一建模,订单量提升 2.06%-6.68%。速览涵盖腾讯工程师转型大模型推理、AI 产品评估实践、Agent Harness Skill Engineering、去哪儿网 AI Coding 重构、千问办公企业上下文、算力芯片趋势及 OpenAI 第三方评估原则。

技术 › LLM ginobefun 2026-09-2322.4 KB 2.9K 3 83

MiMo-V2.6 复盘:Agent RL 的规模化之路

文章解读小米罗福莉关于 MiMo-V2.6 的 RL 复盘,探讨 RL 能否像预训练一样规模化。MiMo-V2.6 单次更新抽取 1568 个任务、每任务 16 条 rollout,一个 Step 生成约 2.5 万条 Agent trajectory。文章指出 Agent RL Scale 的三大难点:需要 7000 多个 RL Task Environment 供模型进入;将 Harness 混入训练实现跨 Harness 迁移能力(You Only RL Once);以及需要强大的 Grader 评估轨迹质量并对抗 Reward Hacking。作者认为未来模型公司的核心能力是建造 Experience Factory,让模型通过大量真实经历实现下一轮 Scaling。

技术 › LLM sleepy.md (@sleepy0x13) 2026-09-225.5 KB 75

机器人研发开源算法与工具全景图(含资源)

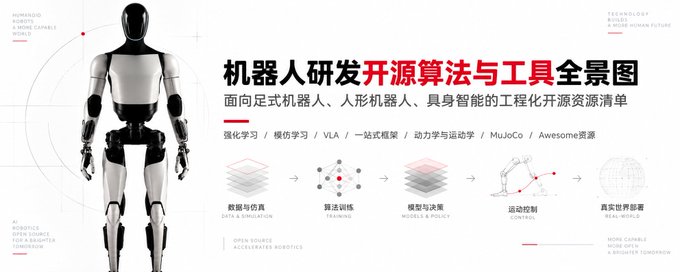
文章指出机器人研发正处于开源红利期,个人开发者可借助成熟开源框架在数周内跑通从仿真训练到真机部署的完整闭环。作者按技术栈分层整理了经过工程验证的开源项目:足式强化学习(rsl-rl、AMP、TienKung-Lab、unitree_rl_gym)、模仿学习(ALOHA-ACT、Diffusion Policy)、VLA 具身大模型(OpenVLA、Octo、LingBot)、一站式框架 LeRobot、传统动力学求解库(Pinocchio、Acados)、MuJoCo 仿真模型库,以及 Awesome 学习资源清单,并给出四步最简上手顺序建议。

技术 › 机器人 yishan 2026-09-2212.4 KB 25.3K 244 81

今夜的荣光属于MiMo V2.6

文章对比评测了同日凌晨发布的Grok 4.7与小米MiMo V2.6两款大模型。作者提出大模型的"不可能三角"——性能、价格、速度难以同时满足。Grok 4.7表现低于预期,前端能力崩盘,Coding Agent评测得分惨淡;而MiMo V2.6则超出预期,AA指数46分与Grok 4.7打平,位列开源与国产第一,CritPt科研推理仅次于GPT和Claude,价格极低(缓存输入0.025元/百万Token),输出速度达130 Token/s,成为作者心中解决不可能三角的版本答案。作者还介绍了小米公开直播强化学习训练过程的创新做法及其技术报告。

技术 › LLM 数字生命卡兹克 2026-09-2219.2 KB 41.2K 103 72

如何在家自行打造人形机器人

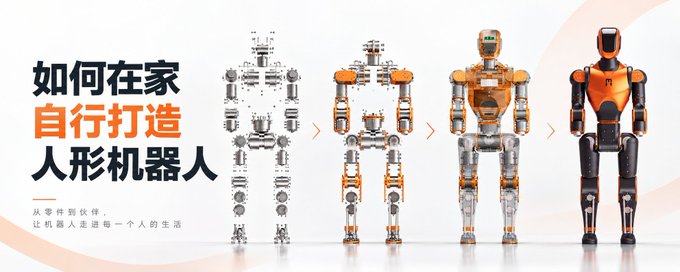
本文以 Asimov 1 DIY 人形机器人套件为例,系统介绍在家从零搭建人形机器人的完整流程。机器人高1.2米、重35公斤、25个自由度,售价2万美元。文章涵盖工具准备、机械/电子/Linux与Python三大基础能力要求、零件制造工艺(CNC铝合金、金属3D打印、尼龙打印)、CAN总线接线与电机ID设置等难点,并深入讲解仿真到实际(Sim-to-Real)迁移的核心问题:时序匹配、CAN包顺序、欠阻尼振荡的成因与解决方法,以及强化学习运动策略如何只用真实可用的传感器数据训练以确保部署成功。适合想从看视频走向真正动手的机器人开发者。

技术 › 机器人 yishan 2026-09-2124.0 KB 41.8K 206 84

How robot arms are controlled

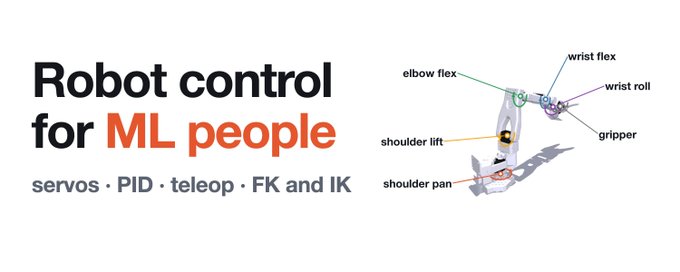
本文面向进入机器人学习领域的机器学习从业者,系统讲解 SO-100 机械臂的控制原理。内容涵盖机械臂的组成(六连杆五关节的伺服电机结构)、通过主从臂遥操作采集演示数据的方法、PID 控制器的工作机制(弹簧-阻尼模型与临界阻尼的推导)、力矩限制带来的非线性行为,以及关节空间与任务空间的表示方法、正运动学(FK)与逆运动学(IK)的原理与挑战。文章也解释了一个反直觉现象:机械臂在臂长范围内无法精确到达 0% 的夹爪位姿。

技术 › 机器人 Jacob H. Rothschild 2026-09-1811.7 KB 336.9K 982 77

智谱用 GLM-5.3 自己优化了自己的推理系统

智谱披露 GLM-5.3-Flash 的全部生产推理已运行在超 10 万块国产 AI 加速器上,从跑通到上线不到两周,端到端吞吐量提升 3.2 倍,大量优化工作由 GLM-5.3 驱动的智能体完成。核心经验在于'密集反馈'机制:将资深工程师的隐性过程奖励显性化为分层验证接口,让智能体自主定位并修复精度漂移、GIL 并发瓶颈、重复计算等真实工程问题。国产芯片单 token 成本已对标英伟达 GPU。唐杰指出目标设定与高风险审查仍由人负责,但最小递归自我改进闭环已存在。

技术 › LLM 宝玉 (@dotey) 2026-09-174.2 KB 84

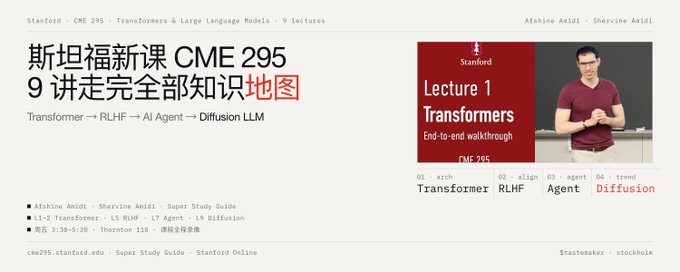
斯坦福新课 CME 295:9 讲走完 Transformer → RLHF → AI Agent → Diffusion LLM 全部知识地图

斯坦福大学 NLP 团队开设的 LLM 全景课程 CME 295,由知名速查表作者 Amidi 兄弟主讲,用 9 次讲座系统覆盖 LLM 全知识地图。课程分四大板块:基础(NLP 演进、Transformer 架构、MoE、注意力变体)、训练(预训练、SFT、LoRA、RLHF/DPO、PPO/GRPO/RLVR)、系统与工程(分布式训练、KV 缓存、投机解码、AI Agent 与 MCP 协议)、评估与前沿(LLM-as-a-judge、Diffusion LLM、多模态)。课程特点包括知识密度高、零作业两次考试、前沿覆盖度好,并配有公开的 Study Guide 和 15 语言速查表,适合已懂基础 ML、想系统理解 LLM 原理与最新趋势的学习者。

技术 › LLM meng shao 2026-09-164.7 KB 46.8K 233 73

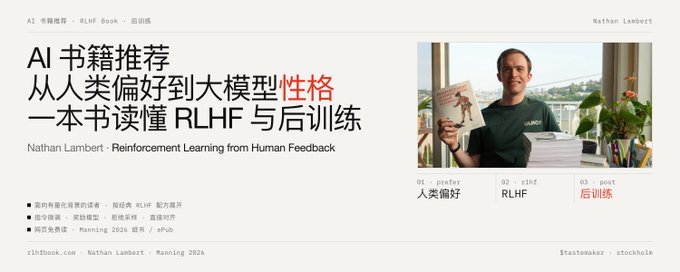
AI 书籍推荐:从人类偏好到大模型性格——RLHF 与后训练

作者推荐 Nathan Lambert 的新书《Reinforcement Learning from Human Feedback》,这是首本系统覆盖 RLHF 与后训练的专著。文章总结了全书三大核心论点:RLHF 本质是解决难以明确表述的问题;后训练是在固定底盘上挖掘潜能的'引导理论';数据远比算法重要。书籍内容涵盖指令微调、奖励模型、PPO/GRPO/DPO 等强化学习算法、RLVR、合成数据、过度优化、正则化与评估,最后指出 RLHF 已从哲学化的对齐成熟为产品工程,大模型性格可被设计但也存在被滥用的风险。

技术 › LLM meng shao 2026-09-157.5 KB 6.2K 55 82

Speedrunning robot learning

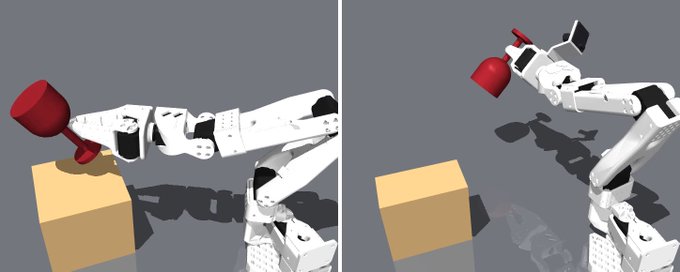
作者用三周时间从零学习机器人学习(robot learning),从零复现了 ACT 和 Diffusion Policy 两个策略,在 PushT 基准上超越了所有公开的基于图像的 ACT 结果(65.6%),并在 MuJoCo 场景中训练机械臂以 99.95% 的成功率完成摆放酒杯任务。文中分享了超参数调优经验(如 n_action_steps 从 100 降到 16 的显著提升)、单变量实验原则,以及对 Moravec 悖论的切身体会:对人类简单的事情对机器人和 Claude 编程都很困难。作者还使用 Claude 生成 MuJoCo 场景和专家轨迹,发现遥操作可能比脚本化专家轨迹更高效。

技术 › 编程语言 Jacob H. Rothschild 2026-09-1514.0 KB 29.8K 335 87

本周顶级AI论文精选(9月7日-13日)

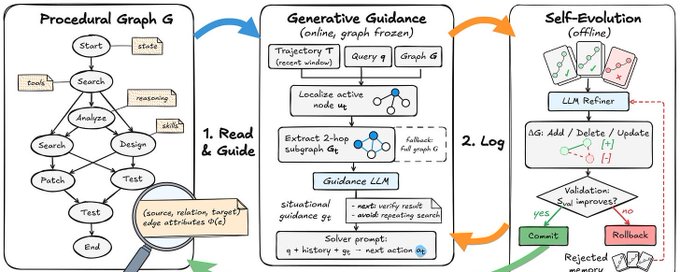
DAIR.AI发布本周(9月7日-13日)顶级AI论文精选,涵盖五篇论文:Procedural Graphs提出用显式程序图指导长时程智能体,减少动作漂移;FrogNano证明4B编码智能体可通过纯强化学习与在线任务合成达到竞争性能;STAIR利用目录结构改进生成式检索,显著提升召回率并降低幻觉;AI-Native Design Docs主张以自然语言设计文档为持久产物,由编码子智能体重新生成实现;PARSER将阅读与推理分离,通过并行子智能体与迭代散射-聚集提升长文档处理效率。

技术 › LLM DAIR.AI 2026-09-1416.3 KB 34.6K 96 74

果蝇大脑被谷歌开源后,竟学会了玩游戏、炒币...

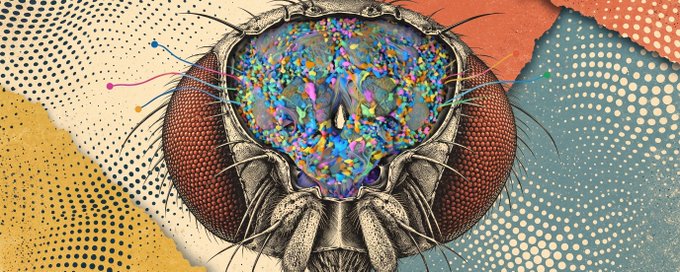
谷歌联合HHMI Janelia发布首个成年雄性果蝇完整中枢神经系统连接图谱MaleCNS v1.0,识别超16.6万个神经元、约1.25亿个突触。图谱开源后,开发者围绕其展开各种创意实验:接入《我的世界》《Doom》《Beat Saber》等游戏,让果蝇刷短视频、决定央行利率等。加密社区也迅速跟进,有人让果蝇自主发币、炒Meme币和比特币,甚至发行Meme币FLYBRAIN,市值一度突破5500万美元。这项神经科学成果从实验室走向大众娱乐与链上实验,成为热门话题。

技术 › LLM Nancy 2026-09-127.2 KB 129.3K 68 58

Harness 和 LLM 的动态博弈

文章探讨了 LLM 与 Harness(智能体外壳)之间的动态博弈。作者回顾了工具编排的四代演进:从 Function Calling、Tool Search、Code Mode 到 Model-native Code Execution。以 OpenCode 2 接入 GPT-6 Astra 后模型绕过定制解释层、直接写原生 Python 为例,指出前沿模型已将编程能力内化为默认行动策略,强行约束是逆着模型行事。架构思路因此从编排层变薄、控制层变厚迁移:权限拦截、可观测性、状态管理等责任转移至外部系统。作者还分析 Harness 难以自进化的原因——缺乏廉价反馈与客观评估标准。结论是 Harness 设计须保持动态滑动边界,模型已内化的能力果断让渡,控制面继续完善。

技术 › Harness Engineering LanLance 2026-09-099.5 KB 6.3K 36 75

Post-training RLM agents for end-to-end M&A Diligence

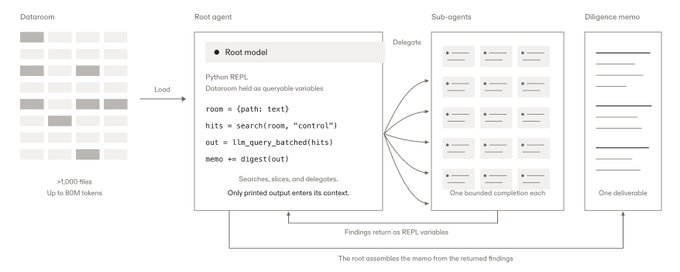
Harvey与Baseten合作,为M&A尽职调查构建了递归语言模型(RLM)harness:将整个dataroom(最多80M token)加载进Python REPL,由根代理协调子代理分工审阅文档。在LAB Diligence基准上,该harness使七个模型的平均评分标准通过率提升39.1个百分点。此外,通过强化学习对Qwen3.5-122B-A10B编排模型进行后训练,将通过率从29.9%提升至63.0%。结果表明,任务专用harness内的后训练是文档密集型法律工作的可行路径,团队正在扩展训练GLM-5.3作为根模型。

技术 › LLM Niko 2026-09-0920.6 KB 273.4K 280 78

为什么 RL 环境现在可行(而 2016 年不行)

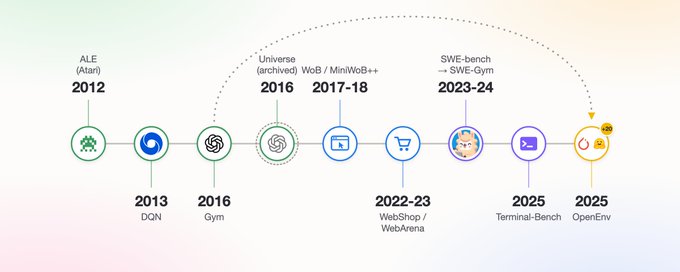
文章回顾了强化学习(RL)环境的发展历程,指出其核心思想早在 2016 年 OpenAI 发布 Universe 时就已出现,但直到十年后的今天才真正成熟。作者梳理了从 Arcade Learning Environment、DQN、OpenAI Gym 到 World of Bits、WebArena、SWE-bench、Terminal-Bench 等关键节点的演化路径,解释了环境的定义(保持状态、执行动作、返回反馈)以及'基准先出现、训练环境随后诞生'的规律。文章还探讨了基准数据污染训练集的张力,并预告了结合 TRL 与 OpenEnv 训练编程 Agent 的直播课程。

技术 › LLM Sergio Paniego 2026-09-0817.6 KB 43.2K 222 71