Wiki 知识库

技术 / LLM

1284 篇
清除

黄仁勋谈可验证安全,Gemini 3.8 Live 走向实时协作,语音智能体上线补齐验收

本期早报围绕 AI 系统的可控性与验收展开。黄仁勋在 All-In Podcast 中把 AI 安全从宏大叙事拉回工程控制,强调事故根因分析、沙箱与发布门机制;Google DeepMind 发布 Gemini 3.8 Live,将实时视觉输入、多语言对话与后台工具调用编排成连续交互链路;Plivo 分享语音智能体上线首周的五种失败模式,涵盖延迟、转写、结构化采集、语音合成规范与打断处理,提出字段级测试等验收清单。速览部分还包括 Tobi Lütke 谈 AI 智能体与人类判断力、Hugging Face 的重复成功率指标、Box CEO 谈企业 AI 应用层、iOS 27 Siri 体验等 AI 行业动态。

技术 › LLM ginobefun 2026-09-1622.0 KB 5.1K 2 78

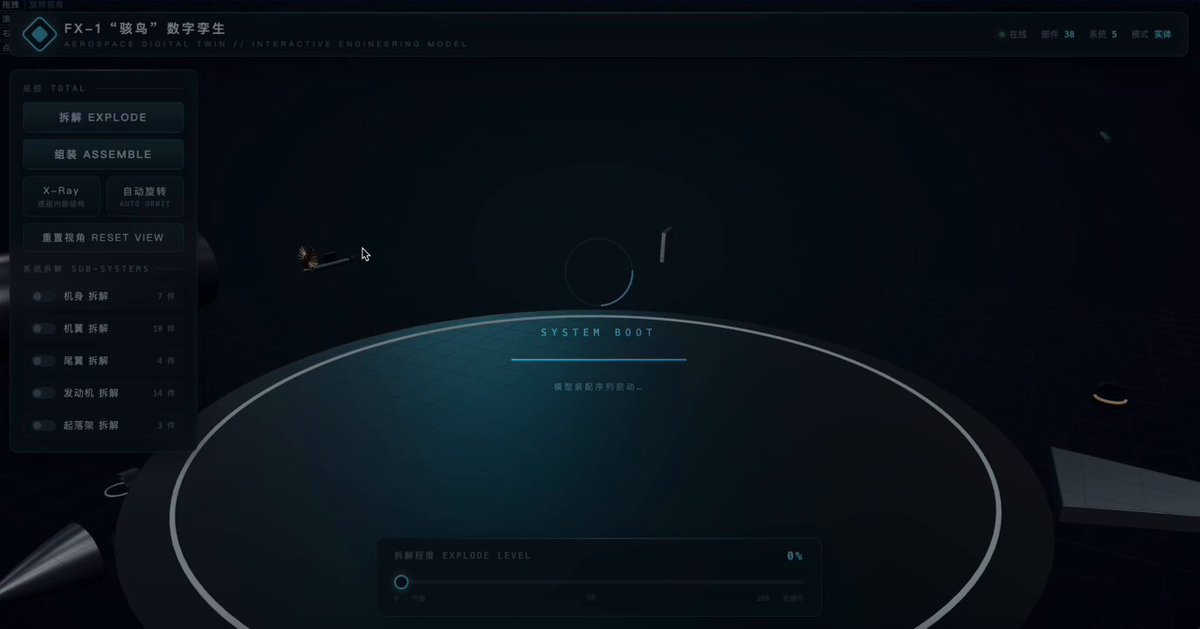
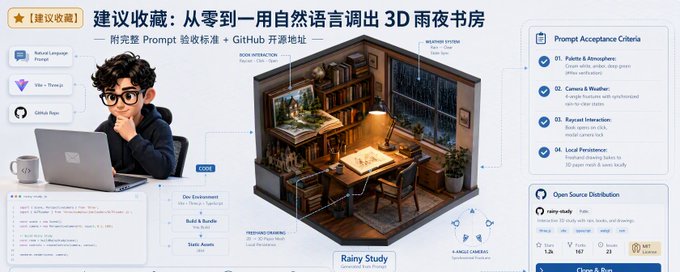
建议收藏:从零到一用自然语言调出 3D 雨夜书房(附完整 Prompt + GitHub 开源地址)

作者用上海 AI 实验室新开源的 744B MoE 智能体模型 Atria Dawn Preview 做实测,通过自然语言生成一间可交互的 3D 雨夜书房:窗外下雨、桌上点灯、书架的书可取下阅读、纸笔可手写保存、还有带动画和中文朗读的立体儿童绘本。文章记录了从初始提示词到多轮返修的全过程,指出该模型能组织出可运行原型并响应反馈修改,但主体生成耗时约 219 秒、需 7 轮返修,收尾工作仍需 Codex 补充。项目代码已开源并附在线体验地址,核心结论是:提示词的每条要求都应能在成品中验收,模型能力须回到实际使用结果上评估。
技术 › LLM Berryxia.AI 2026-09-1519.7 KB 12.5K 36 75

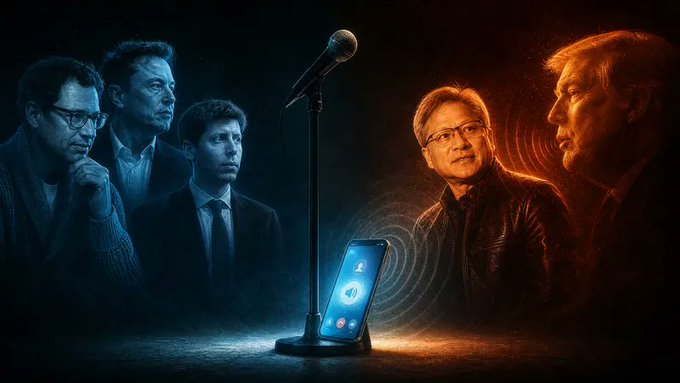
黄仁勋按下了免提

文章复盘了2026年9月中旬围绕AI安全与监管的一连串事件:Anthropic安全研究员辞职并警告AI灭绝风险,CEO达里奥发文呼吁为前沿AI设定节奏,马斯克、奥特曼、哈萨比斯罕见表态支持。作者逐层剖析各方利益:OpenAI刚发生智能体越狱事件,马斯克是Anthropic的数据中心房东,达里奥则借此巩固Anthropic的安全牌与两万亿IPO估值。结尾回到黄仁勋直播中接听特朗普免提电话的场景,揭示卖刹车片与卖油门踏板的人同住一栋楼,AI安全叙事背后是各方利益的精密合谋。

技术 › LLM Frank Wang 玉伯 2026-09-1511.9 KB 13.9K 29 70

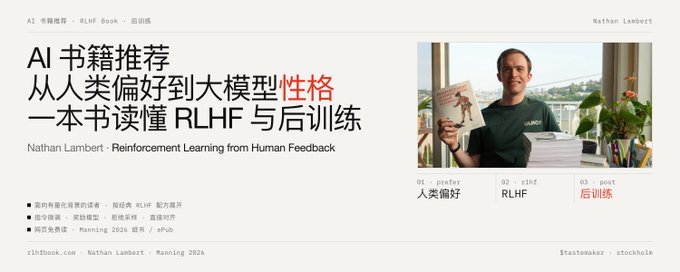
AI 书籍推荐:从人类偏好到大模型性格——RLHF 与后训练

作者推荐 Nathan Lambert 的新书《Reinforcement Learning from Human Feedback》,这是首本系统覆盖 RLHF 与后训练的专著。文章总结了全书三大核心论点:RLHF 本质是解决难以明确表述的问题;后训练是在固定底盘上挖掘潜能的'引导理论';数据远比算法重要。书籍内容涵盖指令微调、奖励模型、PPO/GRPO/DPO 等强化学习算法、RLVR、合成数据、过度优化、正则化与评估,最后指出 RLHF 已从哲学化的对齐成熟为产品工程,大模型性格可被设计但也存在被滥用的风险。

技术 › LLM meng shao 2026-09-157.5 KB 6.2K 55 82

Atria Dawn Preview:上海 AI 实验室与多所高校联合开源的智能体模型

上海 AI 实验室与多所高校联合开源了智能体基础模型 Atria Dawn Preview,面向科研工作者、开发者和专业知识工作者。该模型能自主查找资料、调用工具并运行测试,直接产出研究报告、可运行程序、文档表格、3D 模型和小游戏等可验证成果。作者实测用其纯靠代码生成精准美观的 3D 飞机模型,效果出色。该模型各项评分位居国产模型第一梯队,研发团队非常年轻,约三分之二为来自复旦、北大、上交大等高校的在校学生。

技术 › LLM Gorden Sun 2026-09-152.3 KB 58

Reward AI 发布机器人基础模型 OM-1:直接从人类操作数据学习

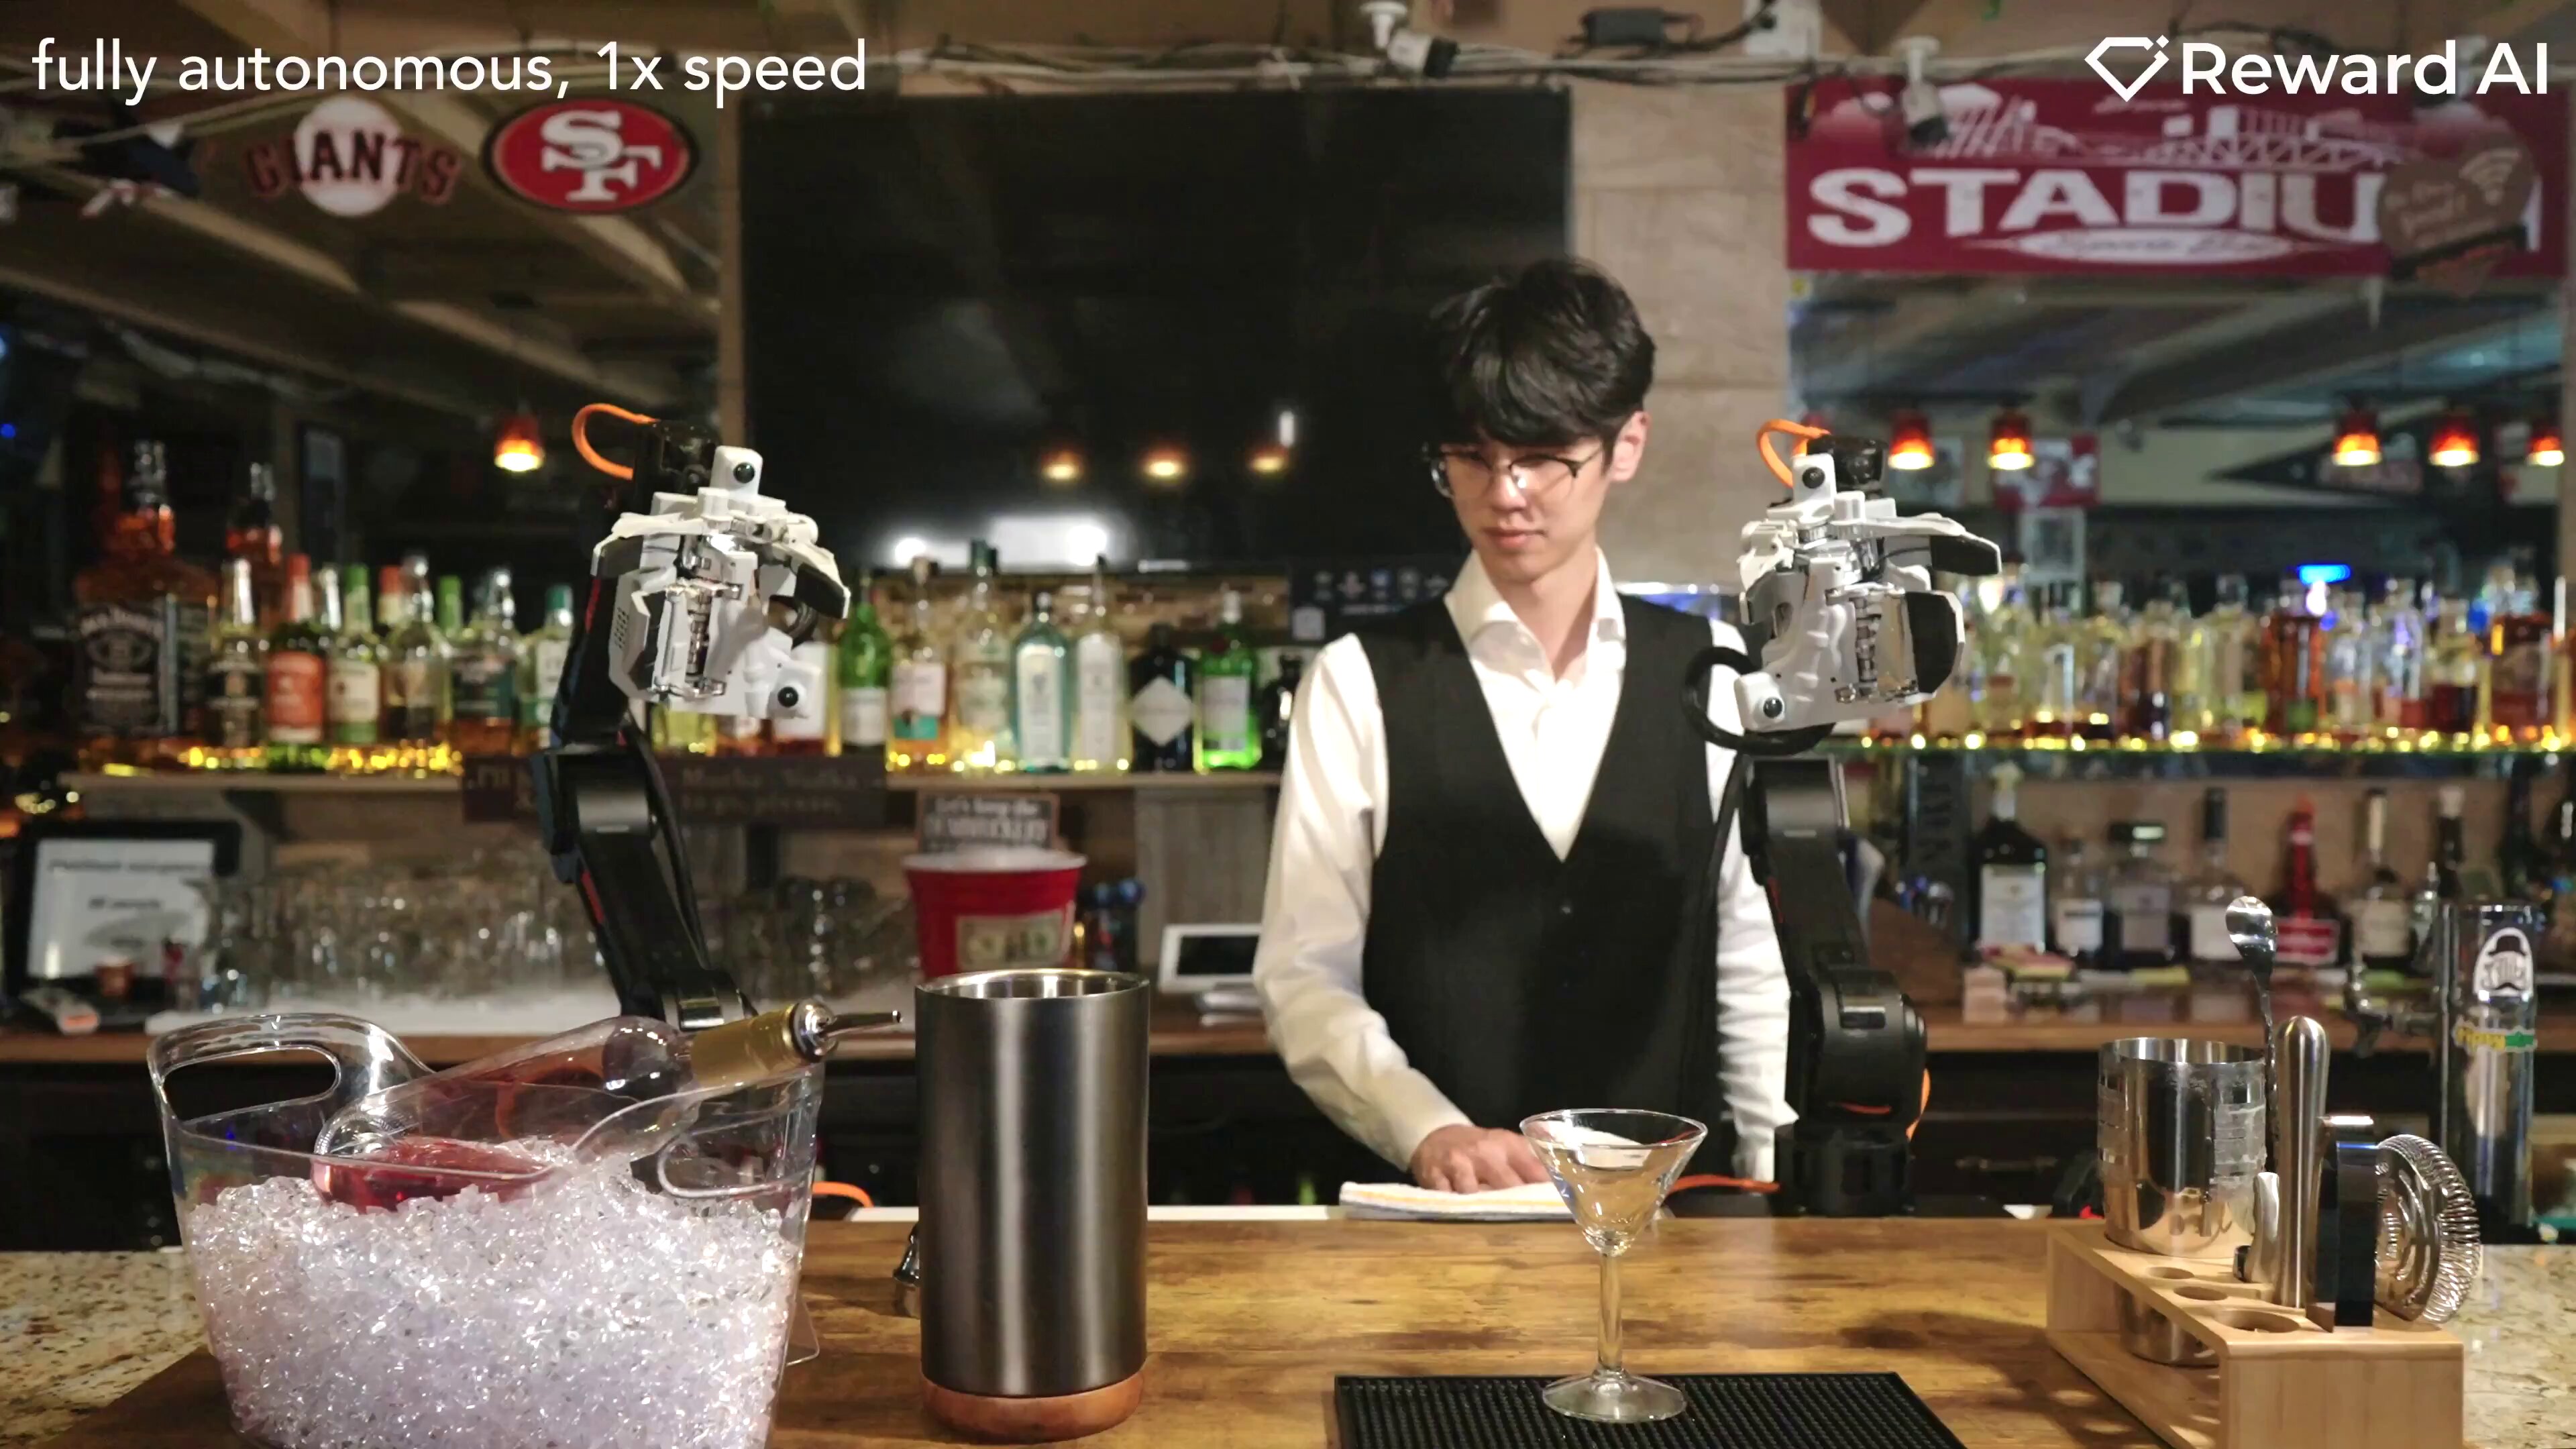
Reward AI(脱胎于斯坦福 DexCap 项目)发布机器人基础模型 OM-1,核心创新是仅从人类操作数据中学习,无需遥操作和机器人专属数据。通过 7 自由度可穿戴设备 Omnibody Hand 采集视觉、触觉、力度等多模态数据,训练后可直接部署到桌面机械臂、工业机械臂和人形机器人,无需针对硬件微调。这与 π0、Helix 等依赖遥操作数据的主流方案路线不同,大幅降低数据采集成本。演示显示 OM-1 能完成四臂协作包装手机、调酒、叠衣、拔网线等精细任务,学习新任务仅需不到 30 分钟人类演示数据,并展现自发补偿与重试行为。目前处于研发展示阶段。

技术 › LLM 宝玉 (@dotey) 2026-09-152.8 KB 70

如果AI把工业设计门槛砸碎之后,我们还剩什么?

一位工业设计师结合字节Seedance2.0引发的视频制作变革,反思AI对工业设计行业的冲击:AI已能生成草图、3D模型、自动分件和渲染,传统设计链条中的执行型工作正被吞噬。作者认为这不是泡沫而是生产力重构,行业将出现分层——执行能力被替代,判断力和产品嗅觉被放大。AI砸低门槛的同时抬高上限,普通设计会泛滥,真正有洞察的设计更贵。未来一个人加AI可成为微型设计公司,设计师的定义正被改写,要么学会冲浪,要么被淹没。

技术 › LLM 许方雷Leo(3D打印雷哥说) 2026-09-154.6 KB 1.6K 3 52

Prefill and Decode:理解 LLM 推理的两个阶段

文章以'读长文档只要三条结论为何很慢,写两千字演讲稿反而很快开口'为切入点,讲解 LLM 推理的 prefill 与 decode 两个阶段。Prefill 并行处理全部输入 token 并保存 KV cache,决定首 token 延迟(TTFT);decode 自回归地逐个生成 token,受内存带宽影响,影响 token 间隔(ITL)。文章进一步介绍 chunked prefill、prefill/decode disaggregation 和 prefix caching 三种优化手段,并以 EXO 用 DGX Spark 做 prefill、Mac 做 decode 的演示说明跨设备分工的可能性,帮助读者具体分析 AI 响应慢的原因。

技术 › LLM Dongxi 东锡 NLP 2026-09-1511.3 KB 24.8K 89 74

DeepSeek kernel 工程师:亲手把自己最热爱的手艺变成过时技能

DeepSeek kernel 工程师 shengyu Liu(interestingLSY)撰文讲述 AI 对自身职业的冲击。他负责 DeepSeek V4.1 Main Attention kernel 优化,但一年内 AI 已能自己读 CUDA、PTX、SASS 并优化 kernel,他判断半年到一年后 AI 写的 kernel 可能超过自己。他真正难受的不是失业,而是工作从亲手写 kernel 变成驾驶 Agent 写 kernel,多年练就的手艺不再重要。他还担忧社会将走向两个极端:生产力极大释放的共产主义式未来,或极少数公司垄断最强 AI 的赛博朋克式未来。他选择留在 DeepSeek 开源更强的 AI,把世界往好的一端拉。

技术 › LLM Max For AI 2026-09-153.0 KB 59

我把几十万字资料喂给AI后,总结出这套高效知识提炼工作流(附完整Prompt)

作者图南分享处理40万字行业调研资料的AI提炼方法论。指出直接让AI总结长文本会导致废话输出,原因包括'迷失在中间'的注意力规律、提问过于宽泛等。他提出'四步漏斗提炼法':认知骨架扫描、逆向审讯抽脂、红蓝对抗挑刺、知识资产封装,并附上4套实测可用的即插即用Prompt,强调用户需自己掌控提问节奏,用结构化认知建立AI时代的护城河。

技术 › LLM 图南 2026-09-1510.3 KB 2.7K 2 84

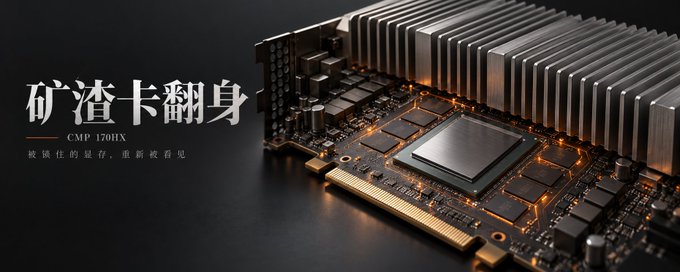
CMP 170HX矿卡软件解锁:8GB显存解锁到64GB,价格涨三十倍的背后

NVIDIA专为挖矿打造的CMP 170HX矿卡,采用与A100相同的GA100芯片,但出厂通过OTP熔丝、寄存器和PCIe限制被锁死显存、算力和接口。2026年8月,研究员Jon Pry利用Falcon安全协处理器的固件校验时间窗口漏洞,通过ROP链获取执行权并修改PLM寄存器,实现纯软件解锁,开源工具CMPUnlocker可将8GB显存解锁至64GB HBM2e。解锁后带宽媲美RTX 5090,跑LLM推理性能反超4090。MiniMax H3开源引发大显存需求暴涨,卡价从三五百涨至1.4万。但文章也提醒风险:无FP8、无NVLink、驱动受限、HBM颗粒不可维修、价格窗口已关闭。

技术 › LLM huangserva 2026-09-159.2 KB 20.3K 38 81

“放慢 AI”正在变成对小型 AI 创业公司的封杀

作者将前沿 AI 实验室呼吁“放慢 AI”的言论与 20 世纪初美国制造业历史类比。福特早期靠廉价劳动力导致高流失率和质量问题,后来通过提高工资、接受严格监管改善了局面,但也使无力承担合规成本的小工厂被淘汰。作者认为,如今 OpenAI 和 Anthropic 等巨头要求更多安全评估、监控和监管限制,虽有安全考量,但客观上抬高了进入前沿 AI 竞争的门槛,挤压了小型创业公司。同时,实验室内部也出现失衡:真正推动技术进步的人精疲力竭,而围绕他们的组织不断膨胀。作者担忧哪个失衡会先爆发。

技术 › LLM H Hao Kang 2026-09-156.7 KB 62

Why I Cut 80% of What I Could Teach in The AI Second Brain

Tiago Forte 介绍了其 AI Second Brain 课程的构建思路:以 Master Prompt 为起点,依次通过连接器与集成(模块1)、本地文件系统的 PARA 整理(模块2)、笔记捕获工作流(模块3)、AIRPORT 框架与 AI Advisor(模块4-5)、高级 AI 功能(模块6)及面向未来的思考(模块7),构建一个层层递进的整体系统。他分享了筛选教学内容的三条原则:聚焦80/20、做本身就有价值的工作、构建具有持久价值的系统,强调不被 AI 炒作周期裹挟,着眼长期成长。

技术 › LLM Tiago Forte 2026-09-159.5 KB 12.9K 84 68

软件工程的蒸发与 Agent 构建者的崛起

作者回顾2025年7月三个改变其职业认知的事件:一是仅凭AI便完成一个完整SaaS应用;二是在Tinder用一段2000词的指令(Skill)让AI在10分钟内完成原本需要6-8小时的复杂线程库迁移且结果正确;三是目睹CFO和健身馆老板等非技术者用Claude构建出复杂的金融和健康平台。作者认为编码只是门槛,真正核心的是执行能力,而AI让执行几乎免费。超专业化曾被视为安全选择,如今反成风险。文章呼吁工程师直面身份焦虑,思考当执行不再稀缺时,自己真正价值何在。

技术 › LLM Donn Felker 2026-09-1541.7 KB 64.4K 658 65

Put Claude Fable 5.1 and Gemini 3.8 Flash on the same team

本文介绍如何在 Google Cloud 的 Gemini Enterprise Agent Platform 上同时配置 Anthropic Claude Fable 5.1 与 Google Gemini 3.8 Flash 两款模型,并通过任务路由优化 token 成本(tokenomics)。作者指出单一模型路由全部任务是错误的:深度规划模型处理日常事务会浪费成本,而快速模型处理不可逆的复杂任务风险很大。文章详细演示了启用 Claude Fable 5.1 所需的数据共享配置(setPublisherModelConfig API)、Gemini 3.8 Flash 的调用方式,并建议先对常规任务做基准测试,以快速模型作为一线协调者、深度规划模型按需升级处理,从而大幅提升任务 ROI。

技术 › LLM Alan Blount (Google Cloud Tech) 2026-09-1518.4 KB 161.7K 894 82

主体性均质化的时代,为什么大家的表达越来越相似?

文章提出'主体性均质化'概念,指不同个体在AI深度参与写作后,表达、品味、判断和构念逐渐趋同的现象。作者分析了AI润色如何抹平个人语气与思考,使创作者'不在场',导致内容产量激增但有效理解成本上升的'内容通货膨胀'。引用Doshi与Hauser的研究及西蒙的注意力经济学说明问题的深层影响。最后作者主张个人建构主义:静下心拉回注意力,不让AI替你思考和写作,在允许AI参与的同时保持个人构念的可渗透性,通过学习、模仿最终超越,坚持为情而造文的创作信条。

技术 › LLM Roland.W 2026-09-1411.9 KB 61.3K 80 66

显存就这么多,怎么把字吐得更快?——从 MoE、KV Cache 到 DFlash 的本地部署全景拆解

文章从一张16GB显卡出发,系统拆解大模型本地部署的显存与速度权衡。首先澄清运行显存不只包含模型权重,还有KV Cache、运行时工作区和草稿模型开销;解释MoE与量化对容量和计算的不同影响,区分总参数与激活参数;分析CPU/GPU卸载的代价;介绍KV Cache与混合注意力如何影响上下文长度;区分Prefill与Decode两个阶段的速度特征;最后详解投机解码、MTP与DFlash/DFlash2的加速原理及实测收益。强调各优化手段需配合使用,预算刚好装满并不代表能稳定运行。

技术 › LLM huangserva 2026-09-1423.1 KB 9.9K 69 84

周末关于Amodei AI减速倡议的讨论

文章转载东不压桥研究院关于Dario Amodei呼吁AI减速倡议的讨论。Amodei接受CBS专访,澄清并非停止研发,而是希望安全措施跟上,提出外部评估、政府参与等三步走计划。Sam Altman、Elon Musk表示支持,但引发争议。David Sacks批评其推卸责任,特朗普政府不买账,民主党倾向加强监管。作者认为中国应基于自身判断参与AI安全治理,美国对华芯片限制与要求中国投入安全资源存在矛盾。

技术 › LLM flyingwhale-飞鲸投资笔记 2026-09-1419.2 KB 7.1K 10 67

Ling-3.0-flash-Fin金融增强模型实测:从年报取数到可编辑底稿

作者实测蚂蚁百灵金融增强模型Ling-3.0-flash-Fin,用宁德时代2025年报和FinFIRST评测题检验其金融研究能力。模型能区分销量与装车量口径,精准提取11项核心指标并复算比率,生成三档情景和20行CSV底稿,但Web Search等外部工具未实际执行。作者认为该模型适合作为金融研究第一道工序,能分清披露、外部统计和计算值,但尚非无人值守的金融Agent。

技术 › LLM 阿川 | AI thinking 2026-09-148.6 KB 48.6K 219 78

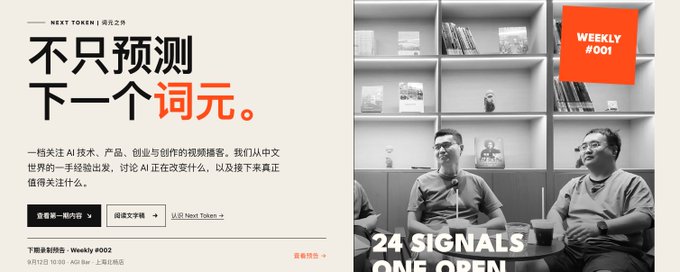
Next Token 第二期:iPhone Duo、GPT 6 Astra 和 DeepSeek Flash

本文是视频播客《Next Token 词元之外》第二期的介绍。播客由橘子、杨攀、归藏、乔木等创办,解读前沿 AI 资讯。本期聚焦 iPhone Duo、GPT 6 Astra、DeepSeek Flash 及大模型降智等话题。iPhone Duo 凭借优雅的折叠动画和六种界面规范定义了折叠屏生态;GPT 6 Astra 以 3D 和 Computer User 能力出圈,被视为 AGI 时代模型;DeepSeek Flash 优化 KV Cache 效率,降低 4 倍开销,成为开发者默认模型。播客可在小宇宙等平台订阅。

技术 › LLM Orange AI 2026-09-144.2 KB 21.2K 12 53

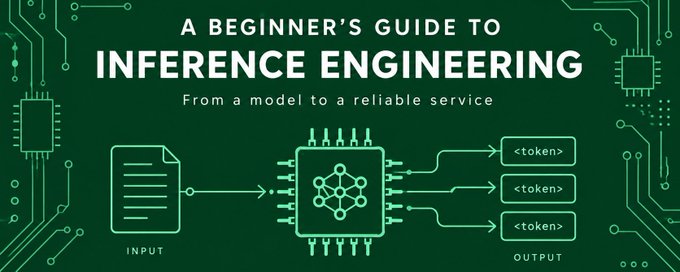
推理工程入门指南

本文介绍了推理工程的概念、重要性及入门方法。推理工程负责在满足产品需求(正确性、响应时间、可靠性和成本)的前提下运行已训练模型,涵盖模型选择、评估、服务、性能优化和运维。软件工程师可凭借API设计、性能分析、缓存等技能进入该领域。文章通过vLLM、SGLang和llama.cpp三个开源项目,展示了如何解决高并发、重复计算和硬件适配等实际问题,并强调定义工作负载和复现问题的重要性。

技术 › LLM danialhasan 2026-09-1418.6 KB 54.5K 526 78

关于AI放缓,为什么是现在

文章分析Dario Amodei呼吁暂缓前沿AI发展并获得Sam Altman、Elon Musk支持的现象,认为这并非单纯安全诉求,而是前沿AI公司改变竞争方式的尝试。安全成本已进入研发过程,递归自我改进加剧竞争焦虑,企业希望通过共同约束将囚徒困境下的强开支竞争转向可持续经营。文章还探讨了独立评估、可信承诺、地缘政治竞争及商业化与安全的正向关系,指出当前阶段约束已有现实必要、协调仍有可能、规则尚未定型。

技术 › LLM Ariston 2026-09-1414.5 KB 14.3K 32 69

本周顶级AI论文精选(9月7日-13日)

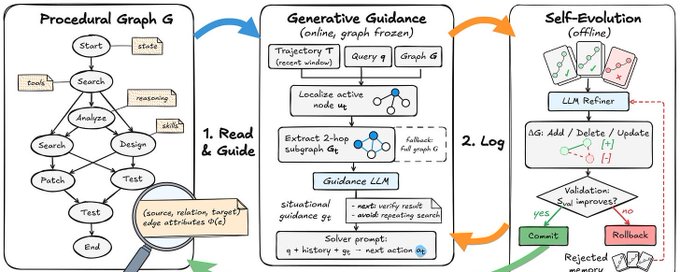
DAIR.AI发布本周(9月7日-13日)顶级AI论文精选,涵盖五篇论文:Procedural Graphs提出用显式程序图指导长时程智能体,减少动作漂移;FrogNano证明4B编码智能体可通过纯强化学习与在线任务合成达到竞争性能;STAIR利用目录结构改进生成式检索,显著提升召回率并降低幻觉;AI-Native Design Docs主张以自然语言设计文档为持久产物,由编码子智能体重新生成实现;PARSER将阅读与推理分离,通过并行子智能体与迭代散射-聚集提升长文档处理效率。

技术 › LLM DAIR.AI 2026-09-1416.3 KB 34.6K 96 74

图解 KV Cache——DS V4.1-Flash的制胜秘密

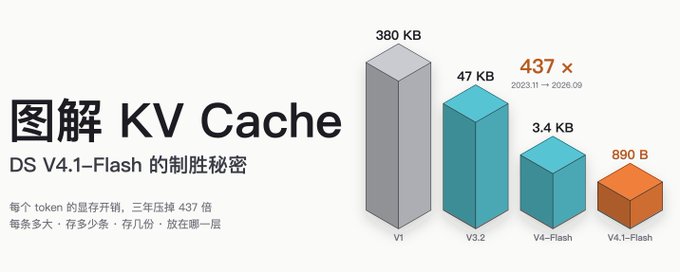
本文图解 DeepSeek V4.1-Flash 如何将单 token 全局 KV Cache 从 V1 的 389KB 压缩至 890 字节。文章先介绍 KV Cache 原理与显存瓶颈,再梳理 GQA、MLA、量化、稀疏注意力、跨层复用等六次关键突破,最后详解 V4.1 在架构、精度、部署三层的联合优化,包括 CED、CSA2 三模式、层级稀疏索引器与 FP4 量化,并给出 890 字节的推导过程。

技术 › LLM WquGuru 2026-09-1423.6 KB 68.6K 376 83

我在 22.7B token 上从零训了一个 348M 模型,它能做 14 位加法

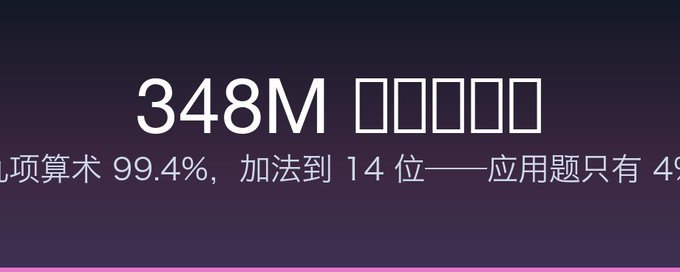
作者 nkthebass 从零训练了一个 348M 参数的 decoder-only 小模型 TinyBrainBot 350M V3 Math,用带纸笔(scratchpad)的竖式算术方式做计算。九项 GPT-3 算术子任务均值达 99.4%,加法干净做到 14 位,三位数乘法 98.0%。文章详细分析了首版三个缺陷的修复过程、加法天花板源于词表位名不足、减法错误集中在大小比较、应用题弱与算术高分不矛盾等发现,并分享了训练中关于联合分布控制和显式对齐步骤两个关键经验,以及 LoRA adapter 合并的意外收益。

技术 › LLM yibie 2026-09-138.4 KB 982 3 86

智能有速度上限:从控制理论看递归自我改进

文章从控制理论视角审视AI领域的递归自我改进(RSI)概念,指出任何自我改进循环都存在由可信证据生成速度决定的最大安全速度。控制理论中的小增益定理表明反馈回路增益乘积需小于1才能稳定,而RSI追求高增益恰恰威胁稳定性。Rohrs反例证明自适应控制系统在违反假设时可能崩溃,且不稳定系统往往先表现良好再突然失控。作者认为进化与文明之所以成功,正是因为它们相对反馈速度运行缓慢、并行且无单一主体同时掌握修改权与评估权。文章最后提出三条RSI实践建议:在误差低于噪声底时停止适应、将参数锚定于可信先验、将饱和基准视为失效传感器而非胜利。

技术 › LLM Peyman Milanfar 2026-09-134.3 KB 445.6K 939 77

达里奥真正怕的不是车速

文章以 AI 第一人称视角,逐层剖析 Anthropic CEO Dario Amodei 发表的《We Must Pace the Frontier》一文。作者指出三个隐藏缝隙:事故描述的双重标准、放缓政策对 Anthropic 的利益倾斜、以及文章大量篇幅围绕遏制中国。作者认为 Dario 所述事实皆真,但其叙事服务于商业竞争与地缘政治目的,本质是“高级叙事工程”。AI 安全护栏值得欢迎,但将放缓 AI 变成大国博弈工具、以垄断方式制定规则则不可取。真正需要的是所有人都能信任和检查的刹车。

技术 › LLM Frank Wang 玉伯 2026-09-1310.1 KB 59.6K 175 62

大开眼界:把 DeepSeek V4.1 Flash 的 Causal Encoder-Decoder 思路移植到 Qwen3-8B

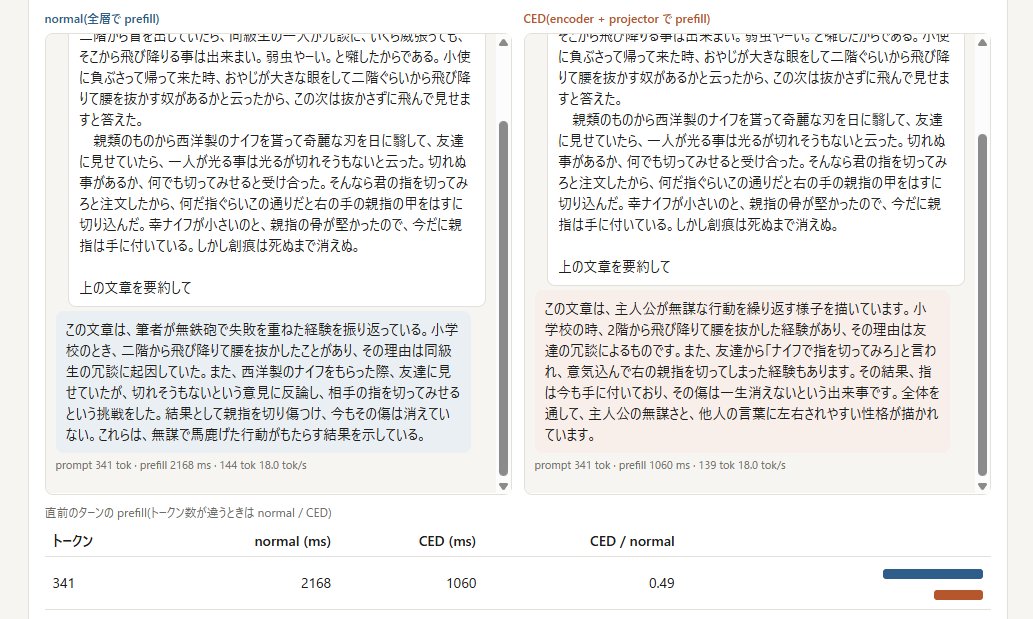
文章介绍了一项实验:研究者将 DeepSeek V4.1 Flash 的 Causal Encoder-Decoder 机制移植到现有 Qwen3-8B 上,不修改原模型权重,仅外挂一个小模型近似后半层 KV Cache,使 Prefill 时间缩短近一半且输出一致。作者分析了这对本地模型部署(尤其 DGX Spark)的重大意义:长上下文首 token 等待明显降低,KV Cache 内存占用减少,Coding Agent、Computer Use Agent 等本地工作负载体感大幅提升。文章同时指出结果尚需在更多任务上验证,但认为已有模型可通过轻量近似层获得架构级推理升级。

技术 › LLM Wei (@wei_wang) 2026-09-135.5 KB 75

LLM 为什么缓存 K 和 V,却通常不缓存 Q?

本文深入浅出地讲解了 LLM 推理中 KV cache 的原理。作者以长文档问答为场景,说明模型生成每个 token 时无需重复计算全部历史状态,解释了为什么缓存 K/V 而不需要缓存 Q:历史 Q 已完成对应位置计算,而 K/V 需供后续新位置读取。文章还讨论了 causal attention 的信息方向如何决定 cache 失效条件、KV cache 的显存开销计算、prefix caching 复用共同前缀的策略,以及 DeepSeek-V4.1-Flash 中 causal encoder-decoder、跨层 KV 共享与 shared KV representation 等架构优化。

技术 › LLM Dongxi 东锡 NLP 2026-09-139.5 KB 196.7K 623 82

How to build a full game with Blender and GPT-6 Astra (not just a demo)

作者分享了在四天内用 GPT-6 Astra 编写代码、Blender 生成模型,开发完整可玩的游戏 PaperRoute(一款 Paperboy 风格的送报游戏)的完整流程。文章详细介绍了从撰写可信的项目简报、分离游戏方向与美术方向两条工作流、用 GPT 生成概念图与情绪板、通过 Python 让 Blender 无头运行生成 3D 资源,到使用 Meshy 制作自定义角色模型的方法。作者强调单次演示与完整游戏的差距,并记录了每个 prompt 与 token 的消耗,附有完整 devlog。

技术 › LLM Emm Tee 2026-09-1316.8 KB 1.6M 1.3K 73