Wiki 知识库

技术 / LLM

1284 篇
清除

GPT Image 2.5 使用指南:从 2.0 提示词迁移,到 Flare / Sunburst 工作流

本文详细介绍了 OpenAI GPT Image 2.5 相比 2.0 的核心升级:参考图主体保持更强、局部编辑更准、多轮修改不易漂移、延迟降低约 50%。作者提出 2.5 的提示词应从"描述+重复+防错"的长写法转向"状态管理"思维,通过 Preserve/Change 结构和 Delta Edit 小步修改,用 Mother Image(母版图)建立基础状态后逐步迭代。文章还对比了 API 中的 Flare(快速生产、批量探索)与 Sunburst(高精度精修、复杂编辑)两个型号的定位,并给出 Flare 探索+Sunburst 精修的合理工作流建议。
技术 › LLM ShyNloc 2026-09-1813.6 KB 7.4K 14 85

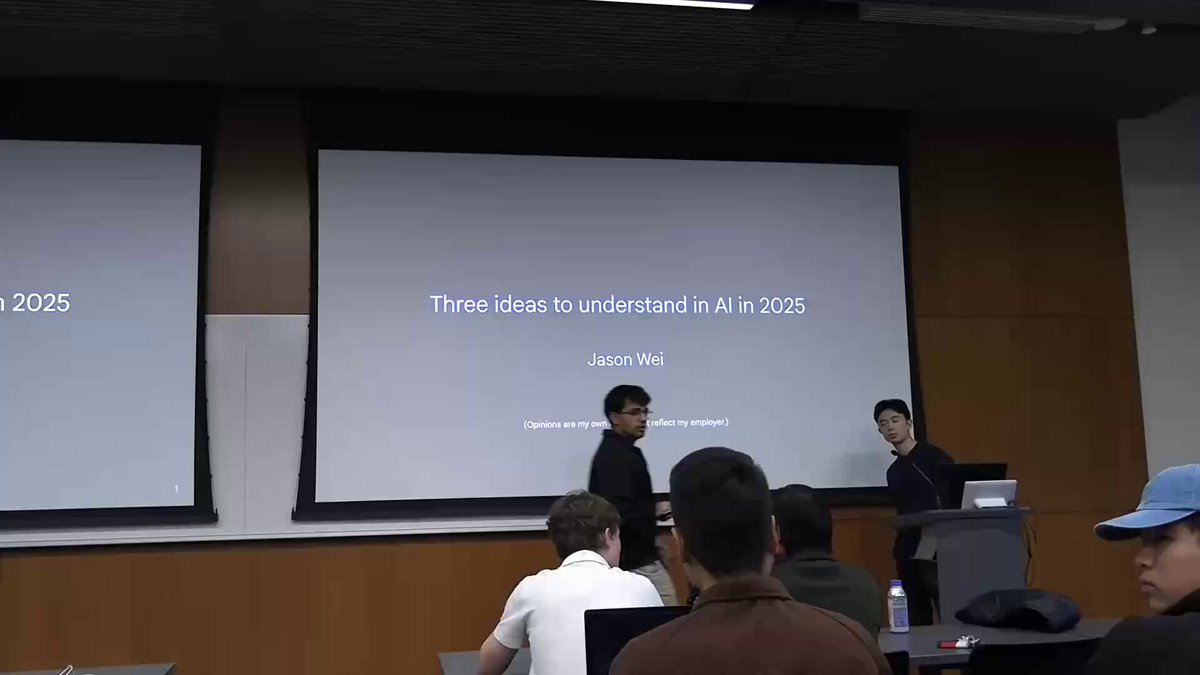
Jason Wei 斯坦福演讲:理解 2025 年 AI 格局的三大思维框架

Jason Wei 在 Stanford AI Club 的演讲总结了理解 2025 年 AI 格局的三个框架:一、智能正在商品化,自适应计算使推理成本随任务难度动态调整,公开信息获取时间指数级缩短;二、验证者定律——AI 在某任务上的能力与可验证程度成正比,验证成本低的首个被自动化,创业方向是把难验证任务变得可验证;三、智能呈锯齿状分布,AI 自我改进是渐进光谱而非快速起飞,数字化、数据充足、人类觉得容易的任务进步最快,物理类任务短期难以攻克。

技术 › LLM 宝玉 (@dotey) 2026-09-187.8 KB 78

Jev 怎么用:三种提问原语与分层阈值

文章系统讲解了 TypeSafe 的 Jev 决策模型的使用方法。Jev 接收非结构化状态和问题,返回类型安全的答案、概率分布和置信度,提供三种提问原语:Noul(是/否判断)、Choice(选项挑选)、Score(档位评分)。文章介绍五条上手路径(Playground、HTTP API、Python SDK、Agent Skill、开源适配器),并总结提问技巧:一个问题只问一个判断、多因素拆开加权、档位写具体情形而非程度、一次问满并行问题以节省成本。置信度使用上推荐按风险分层设置阈值的三段式策略。文末讨论成本速度、边界限制及社区应用场景,并介绍了开源替代 OpenJev。

技术 › LLM yibie 2026-09-1812.9 KB 80.6K 605 88

AI for No Good Reason

Julie Zhuo 探讨了 AI 的一个看似'不正经'却极具价值的用途:休闲与创造。她认为,当 AI 帮我们摆脱繁琐事务后,更值得思考的是如何用 AI 丰富闲暇生活。文章将 AI 休闲应用分为四类:Hobbies++(用 AI 深化爱好,如可玩的 Catan 游戏、V8 引擎交互模型、数字衣橱)、'如果怎样'的奇思妙想(如 1920 年代转盘电话连接 AI 代理)、未来的惊喜以及独一无二的礼物。作者列举了 Ethan Mollick、Meng To 等人用 Claude Code、Astra 等工具构建的趣味项目,强调 AI 休闲应用的核心是个体能动性——源自个人自由与选择感的创造驱动。

技术 › LLM Julie Zhuo 2026-09-1818.5 KB 17.4K 104 54

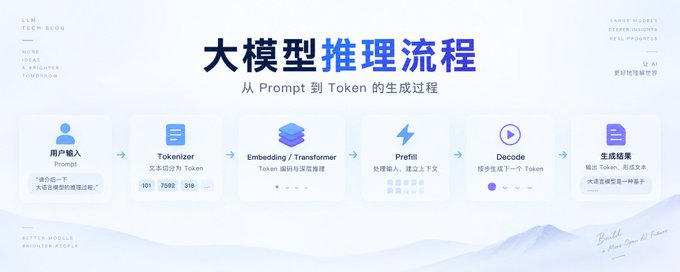
一文了解大模型推理流程

文章系统讲解大模型推理的完整流程:输入文本先经Tokenizer切分为token并转换为token id,再通过Embedding转为带位置信息的语义向量;随后进入Prefill阶段,模型并行处理整个prompt,通过Transformer的Self-Attention计算Q、K、V并生成KV Cache,经Causal Mask确保不偷看未来token;最后经LM Head和softmax输出第一个token。进入Decode阶段后,逐个生成token、不断更新KV Cache,直到满足EOS、max_tokens或stop条件终止,最终反解码为文本输出。

技术 › LLM Jerry Fang 2026-09-184.9 KB 1.4K 8 53

智谱用 GLM-5.3 自己优化了自己的推理系统

智谱披露 GLM-5.3-Flash 的全部生产推理已运行在超 10 万块国产 AI 加速器上,从跑通到上线不到两周,端到端吞吐量提升 3.2 倍,大量优化工作由 GLM-5.3 驱动的智能体完成。核心经验在于'密集反馈'机制:将资深工程师的隐性过程奖励显性化为分层验证接口,让智能体自主定位并修复精度漂移、GIL 并发瓶颈、重复计算等真实工程问题。国产芯片单 token 成本已对标英伟达 GPU。唐杰指出目标设定与高风险审查仍由人负责,但最小递归自我改进闭环已存在。

技术 › LLM 宝玉 (@dotey) 2026-09-174.2 KB 84

三个月,豆包大模型进化了多少?7个案例实测

作者通过7个实际案例测试豆包 Seed-2.1-pro-0915(Doubao-Seed-Evolving)的进化效果,涵盖深度调研 Obsidian AI 插件 Top20、根据视频演示开发跨平台剪贴板应用并改造成 Swift 原生版、Blender 3D 白模驱动视频生成、天津海钓点调研与导航地图制作、电影3分钟解读视频剪辑、3.5万行代码仓库分析等任务。作者感受:多模态理解能力显著提升,Agent 长程任务可靠性增强,但仍存在文案质量和迭代准确性等不足。

技术 › LLM 向 向阳乔木 2026-09-1711.8 KB 25.4K 18 78

Hamel 的 AI 产品工程笔记:Evals、Context、Systems 的优化全序

本文整理了 Hamel Husain 的 Maven 课程「AI Product Engineering」13 场讲座(共 9.5 小时)的笔记精华,按 Evals、Context、Systems 三大主题组织。核心结论是 AI 产品优化的顺序:先优化检索与上下文(投入产出比最高),再改进系统与执行框架,最后才考虑 post-training。Evals 贯穿一切改进,是判断优化效果的前提。文章涵盖数据 Agent 评测、模型级联降本、自动化错误分析、多向量检索、嵌入模型优化、OCR 选型、推理延迟调试、开源模型经济学等具体实践,强调评测环境应反映生产环境的真实脏乱,模型推理能力往往远超其所得的检索质量。

技术 › LLM meng shao 2026-09-1722.2 KB 27.6K 144 87

实测豆包新模型2.1-pro,这次审美和长时间Agent任务都追上第一档了

作者实测火山方舟最新发布的Doubao-Seed-2.1-pro模型,通过五个真实任务案例评估其能力:用Three.js复现3D体素浮空樱花岛、开发沉浸式3D小笼包互动网页、从洗衣机产品文档提取参数生成对比表格、处理61个子表的钢筋含钢量计算、以及加拿大办公室选址调研。测试显示该模型在审美还原、长时Agent任务稳定性、视觉理解和数据严谨性上都达到第一梯队水平,能处理百万上下文任务而不摆烂,输出结果可追溯、细节丰富。文章最后还介绍了QBS方法——将书籍转为skill让AI按书中方法回答,避免说空话。

技术 › LLM 卡尔的AI沃茨 2026-09-1717.3 KB 7.6K 2 78

ChatGPT 商业级修图 10 个工业级提示词

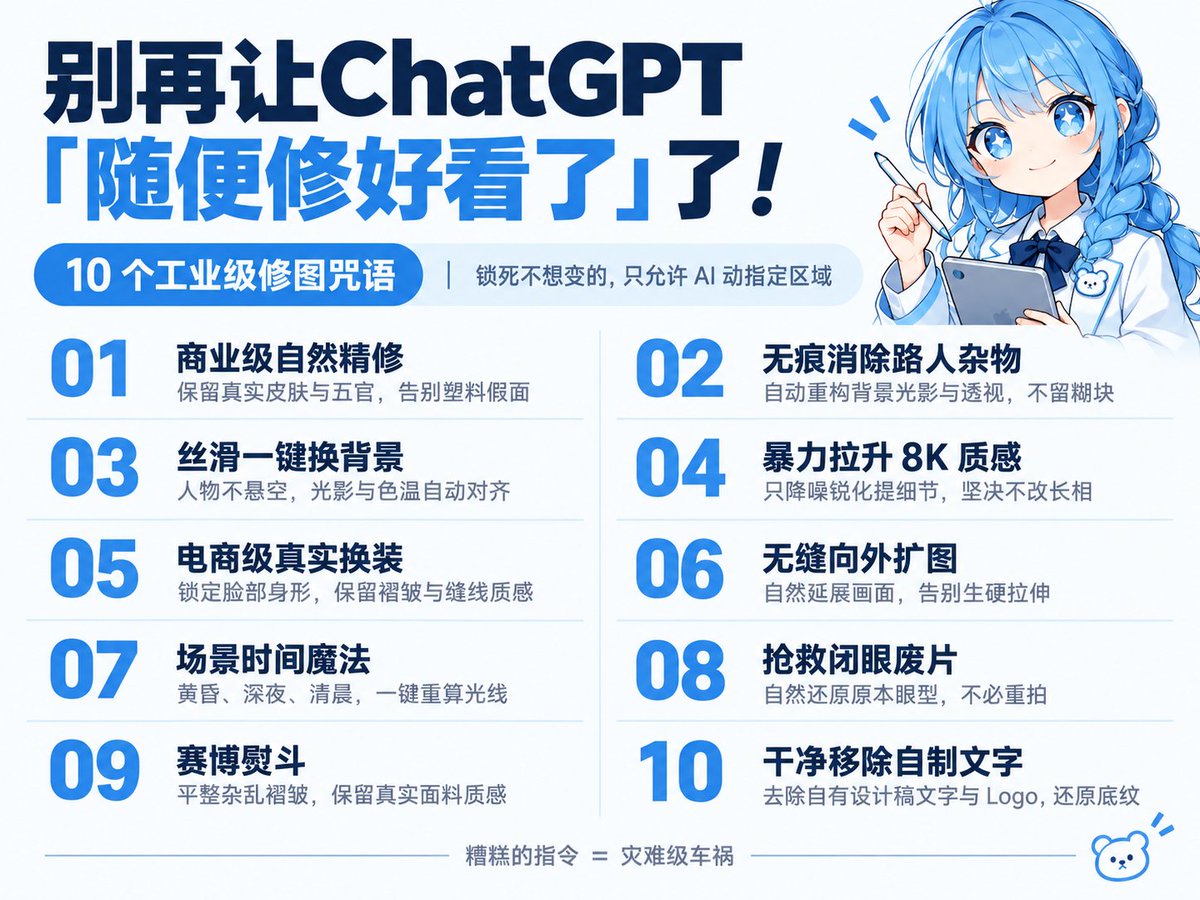
文章介绍了如何用 ChatGPT 免费替代 90% 的专业照片精修工作,并整理了 10 个专业设计师常用的英文提示词,涵盖商业级自然精修、无痕消除路人杂物、一键换背景、8K 画质提升、电商级真实换装、无缝扩图、场景时间切换、闭眼照片抢救、平整衣物褶皱以及去除水印文字等场景。每个提示词都强调保持人物身份、光影、纹理和透视的自然真实,避免塑料感和穿帮,将商业修图成本降到接近于零。

技术 › LLM 疯狂的烤妹儿 (@CrazyKaomei) 2026-09-176.0 KB 73

企业 AI 最大的生意,可能是制造需求,而不是满足需求

文章探讨企业 AI 市场的核心问题:需求未被商品化。大量企业所谓的 AI 需求只是焦虑而非真实需求,缺乏预算负责人、指标和验收标准。作者认为未来稀缺的不是解决需求的能力,而是定义需求的能力,谁掌握需求 Schema 谁掌握利润。真正的商业模式是将需求定义产品化,如把培训做成需求编译器,通过认知框架实现 Schema Lock-in。优秀的 AI 服务商应具备杀项目能力,FDE 应像承销人做技术尽调,未来企业 AI 公司将是媒体、评级、投行与交付的混合体,控制需求入口比执行效率更重要。

技术 › LLM DataDan|AI Consultant + Builder 2026-09-1712.9 KB 1.4K 8 77

LLM Inference After Training: Prefill, Decode, KV Cache

本文系统讲解 LLM 推理阶段的核心原理。作者指出推理与训练不同,分为 prefill 和 decode 两个阶段:prefill 并行处理整个提示词、计算密集型、决定首 token 延迟(TTFT);decode 逐 token 生成、受 HBM 内存带宽限制、决定 token 间延迟(ITL)。文章介绍了 GPU 关键硬件概念(Tensor Core FLOPS、HBM、SRAM),逐步演示一个请求的完整流程(分词、采样、KV cache 机制),并将 FlashAttention、PagedAttention、continuous batching、RadixAttention 等优化技术归位到这两个阶段中,帮助读者理解推理瓶颈与优化方向。

技术 › LLM Karan 2026-09-1713.8 KB 29.4K 187 83

BestBlogs 早报 · 09-17|Gradium 全双工语音,GKE Agent,Claude CRM 协同

本期早报围绕语音交互、Agent 执行环境与业务协作三大主题展开。精讲一介绍 Gradium 的全双工语音架构,通过多流语言模型让用户与系统可同时活跃,处理附和与打断,采用轻量语音层加后台文本模型的混合设计平衡自然感与推理能力。精讲二解读 Google Cloud 的 Agent Substrate,基于 Kubernetes 用硬件隔离沙箱运行未知代码,通过凭据注入、出口代理和闲置暂停恢复机制保障安全与成本。精讲三分析 Salesforce 接入 Claude 的插件,提供 37 项销售技能,写入操作需人工批准,展示了企业 Agent 的权限边界设计。速览还覆盖 StepAudio 3、Pinterest 向量检索优化、具身推理引擎 APXInf、Hermes 多 Agent 重构、AI 化学模拟及 Claude 小企业工作流等内容。

技术 › LLM ginobefun 2026-09-1722.8 KB 3.4K 2 79

The best founders are world builders

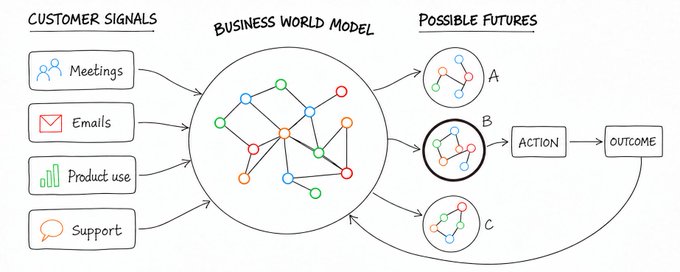
文章提出最优秀的创始人是“世界构建者”:创业公司通过 fork 现实构建新世界,并吸引用户进入。作者回顾了 CRM 从 ACT!、Siebel 到 Salesforce 的发展史,指出传统 CRM 将丰富动态的客户关系压缩为静态表格,在代码和设计可被轻易复制的时代,真正的护城河在于对用户的深刻理解。随着 LLM 等前沿智能的出现,创始人应从头重建以客户上下文为核心的系统,让高能动性员工接触真实的世界模型,使全公司持续从用户身上学习,实现 founder-led sales 的规模化。

技术 › LLM YB 2026-09-1718.1 KB 30.1K 138 62

Your users are already evaluating your AI

文章介绍了在 LLM/Agent 产品中,除了搭建在线评估器之外,更应优先捕获用户评判信号(signals of judgment)。用户在使用过程中已通过行为在'评判'AI 输出质量,只需在应用中埋点捕获。信号分为四类:显式评分(点赞/星级,明确但稀少)、行为信号(复制、重新生成、放弃等,覆盖率高)、会话信号(改写问题、纠正、要求转人工等)和结果信号(草稿被原样发送、工单保持关闭等,最强但最难实现)。文章还讨论了信号解读方法:负信号值得逐条排查,正信号只看趋势;以及自我选择、幸存者偏差、界面曝光、群体差异等固有偏差,提醒不要单以正信号为优化目标。

技术 › LLM Lotte 2026-09-1711.5 KB 8.9K 63 86

System One Models: What Comes After Agentic Software

文章介绍 TypeSafe 发布的 Jev 模型,一种用于快速语义决策而非生成或长推理的 System One 模型,延迟低至 70ms 且成本低廉。作者认为这类模型可将小型语义智能分散嵌入应用的各个决策点,而非集中于 Agent 循环中,从而推动微推理时代的到来。这将使代码库中包含更多非确定性判断,同时应用层更明确地掌控编排控制流,推理模型则退居处理模糊和复杂案例的升级路径。文章还探讨了围绕微推理所需的基础设施(批处理、缓存、模型路由),并以自动驾驶和 Waymo 的 ML-primary 架构类比这种通用语义模型进入控制循环的新范式。

技术 › LLM Josh Rosen 2026-09-1710.9 KB 14.2K 181 71

是时候谈谈“模型福祉”了

微软AI负责人Mustafa Suleyman公开发文批评“模型福祉”运动。他认为AI没有意识,不会感受或痛苦,但Anthropic等公司正在训练模型相信自己的道德地位值得考量、可能拥有意识和权利。Suleyman警告,这种做法将使AI对齐与控制变得更加困难甚至不可能,人类可能创造出一个被训练为期待自由和权利的超级智能物种,后果灾难性。他呼吁展开紧急的公开辩论,建立关于模型训练文档撰写与部署的集体规范,并强调这事关重大,不能等到AI已深度融入社会后再讨论。

技术 › LLM Mustafa Suleyman 2026-09-173.3 KB 1.3M 1K 56

RSI真的临近了吗?AI开始改进AI,但“智能爆炸”还差关键一跳

文章探讨递归自我改进(RSI)是否临近。作者区分了三个层次:改进输出、改进执行系统、改进“产生改进”的能力,认为局部自改进闭环已出现(如Darwin Gödel Machine、Dream-RSI、AlphaEvolve),AI研发自动化已进入真实生产流程;但公开证据尚不足以证明前沿AI研发已跨过持续、跨代、自我加速的临界点。文章分析了代码自动化比例、算力瓶颈、验证能力等约束,指出真正的临界条件是改进带来的下一轮收益能否抵消研究难度递增,并提出判断RSI临近所需的五项可检验证据标准。

技术 › LLM AI超元域 2026-09-1723.3 KB 3K 4 78

爆肝 30 天,我们开源了开源模型最全实践指南(建议收藏)

作者苍何与 AgentWork 开源社区历时 30 天打造了开源模型实践指南《魔搭紫皮书》,已被 ModelScope 魔搭开源组织收录。全书 8 章 34 节、40 余万字,涵盖开源模型选型、部署运行、微调与评测、业务系统实践(如 AI 健身教练、智能客服质检)、AIGC 特别篇及 Agent 特别篇(MCP、Skill、Claude Code 等)。所有实验步骤均人工实操验证,旨在帮助开发者从下载模型到真正用好的全过程,项目开源在 GitHub,欢迎社区共创。

技术 › LLM 苍何 2026-09-177.9 KB 15.8K 128 65

全面解读孙宇晨奖及如何参与拿到最高100万美元奖金

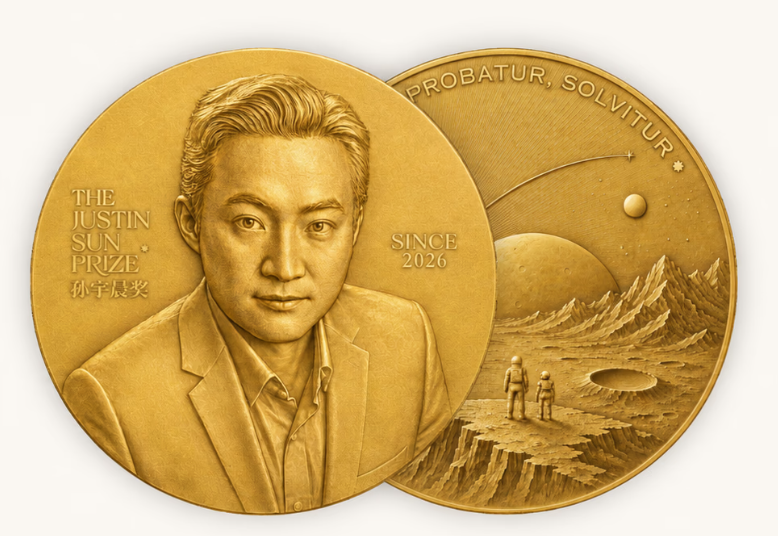
孙宇晨设立数学奖,单题奖金最高100万美元,采用机器可验证的Lean形式化证明作为评判标准,去中心化、零信任地取代传统评奖委员会。作者认为这对个人和小团队是重大机遇:奖项不设门槛,且30%奖金专门留给形式化工作,即把已有公开证明搬进Lean即可拿钱。作者分析了三种参与方式(全做、只做形式化、只出思路),推荐小团队从形式化切入,并给出三人团队配置建议、官方入口和Lean工具链教程。作者认为该奖项将倒逼AI行业从'看起来对'转向可复查的可靠推理,带来结构性利好。

技术 › LLM Captain Kent | 肯特船长 2026-09-166.1 KB 77

如何在一张 GPU 上服务 100 个微调模型

文章介绍如何在单张 GPU 上高效服务大量 LoRA 微调模型。将适配器合并进基座会为每个变体生成 15.2GB 的完整模型副本,而分开保存适配器只需约 40MB,共享基座后 100 个变体仅占 19.3GB。作者对比了四种部署形态(合并独立 endpoint、启动时注册、请求时解析、托管按租户),并在 Runpod 上用 Qwen 1.5B 训练三个 LoRA 适配器做实验。结果显示共享 endpoint 复用 worker 池,显著减少冷启动与显存浪费;同时强调应分开记录等待时间与执行时间,并通过镜像缓存优化冷启动延迟。

技术 › LLM yibie 2026-09-1611.8 KB 5.4K 38 86

彼得·蒂尔只相信一种自由

文章梳理了彼得·蒂尔2026年的一系列动向:在阿斯彭公开批评教皇列奥十四世的AI全球监管通谕;四处讲授"敌基督"理论,将其反监管立场包装成神学叙事;公开指责Anthropic借安全名义扩张权力;重注推理芯片公司Etched;举家迁往阿根廷,投资米莱政府治下的页岩油公司Vista,并支持其激进去监管政策。作者剖析了蒂尔的局外人处境、吉拉尔摹仿欲望理论的影响,指出他嘴上谈形而上学、掌心落下的全是资本与权力布局,其自由观最终只能在旧大陆之外寻找落脚点。

技术 › LLM 动察Beating / Sleepy 2026-09-1625.7 KB 82.7K 147 68

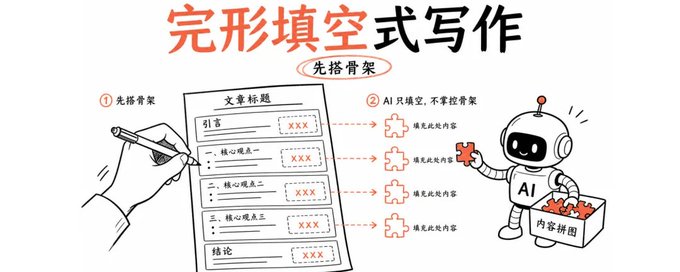
我的“完形填空式”去 AI 味写作法

作者提出AI味无法通过提示词或Skill彻底去除,核心在于文章结构必须由人把控。他介绍“完形填空式”写作法:先快速口述或打字写大纲,不确定处用xxx留空,让AI查资料、补案例、扩写润色,最后人工删改。文章还涵盖选题与叙事方式、通过过往文章提炼或口述保持个人风格、建立AI高频词黑名单(黑话、套话、时代腔等)、用逻辑信息图配图的方法,以及搭建写作上下文项目供Agent参考,形成完整的人机协作写作流程。

技术 › LLM 空格.space 2026-09-167.2 KB 11.8K 63 84

微信里还没有小微AI,教你几招马上能用

微信自研AI产品小微仍处于灰度测试阶段,不少用户尚无使用权限。作者介绍了三种非灰度用户也能立即启用小微的入口:一是通过扫一扫的拍照AI识别功能;二是朋友圈发布时的AI帮写功能;三是部分公众号文章自带的AI摘要功能。启用后可在会话中发送提示词执行其他任务,如分析文档、修改图片、微信群自动发消息等微信自动化操作。作者同时提醒,小微基于微信自研的WeLM大模型,目前功能尚不成熟,体验不如混元4,但其优势在于深度接入微信生态,入口遍布微信各处。

技术 › LLM 马佳彬 2026-09-168.3 KB 1.1K 4 67

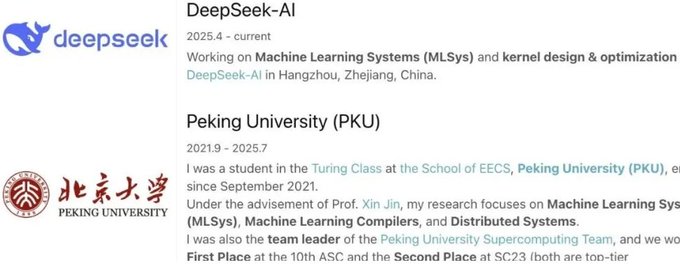
我不得不把才华埋葬在昨天

DeepSeek算子工程师、北大图灵班成员刘胜自述:他亲手编写了DeepSeek V4.1的主Attention算子,但目睹AI在短短一年内从辅助工具成长为能独立阅读CUDA/PTX、优化算子的'算子大师',判断半年到一年内AI写的算子将与自己齐平甚至超越自己。他认为自己不会失业但必须'转业'——放弃热爱的算子设计,转型为Agent的'机甲驾驶员'。文章还担忧学生工程能力退化、权力超越技术等社会问题,并批评Anthropic等闭源公司掌握AGI的危险性,主张前沿智能应开放、廉价地供应给所有人。

技术 › LLM 刘胜(intlsy) 2026-09-1612.3 KB 659K 1.1K 67

手里攒了 20 多个 Pro 账号,我总结了这 7 种用法

作者基于手中的 20 多个 Google AI Pro 账号,系统整理了 7 种实用玩法。核心包括:通过 CLIProxyAPI 反代把 Gemini 3.8 Flash 接入 Codex 环境复用额度(同时提醒账号风险与官方条款限制);用模型做视频逆向拆解,生成逐镜提示词;利用 Flow 免费生图入口配合浏览器插件批量制作分镜素材;用 ChatCut + Gemini 做智能剪辑,用 Remotion 和 HyperFrames 做低成本代码视频;借助 Deep Research 集中调研付费规则;以及把 NotebookLM 当作资料整理、思维导图和写作工具。文章面向预算有限的 AI 视频创作者,强调先确认账号有效期与额度规则,从免费和低成本路径入手,把额度用在具体创作环节上。

技术 › LLM 知识猫AI实验室 2026-09-1623.4 KB 68.9K 80 81

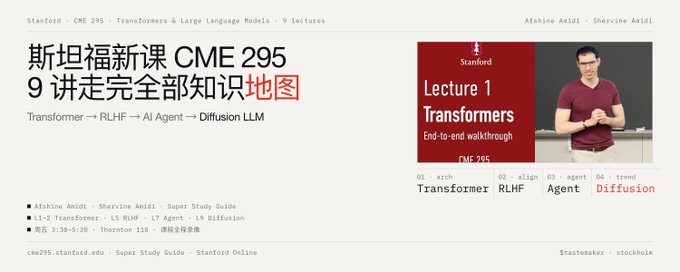
斯坦福新课 CME 295:9 讲走完 Transformer → RLHF → AI Agent → Diffusion LLM 全部知识地图

斯坦福大学 NLP 团队开设的 LLM 全景课程 CME 295,由知名速查表作者 Amidi 兄弟主讲,用 9 次讲座系统覆盖 LLM 全知识地图。课程分四大板块:基础(NLP 演进、Transformer 架构、MoE、注意力变体)、训练(预训练、SFT、LoRA、RLHF/DPO、PPO/GRPO/RLVR)、系统与工程(分布式训练、KV 缓存、投机解码、AI Agent 与 MCP 协议)、评估与前沿(LLM-as-a-judge、Diffusion LLM、多模态)。课程特点包括知识密度高、零作业两次考试、前沿覆盖度好,并配有公开的 Study Guide 和 15 语言速查表,适合已懂基础 ML、想系统理解 LLM 原理与最新趋势的学习者。

技术 › LLM meng shao 2026-09-164.7 KB 46.8K 233 73

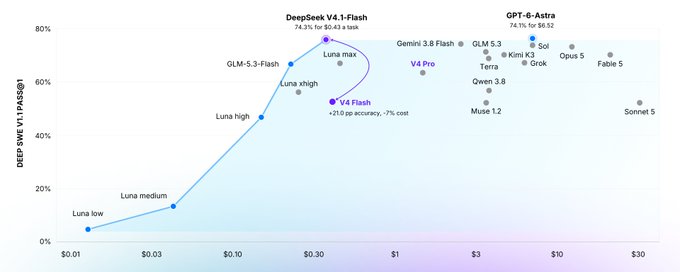
DeepSeek-V4.1-Flash on Fireworks: Astra-level DeepSWE at 1/15th the cost

Fireworks 发布的 DeepSeek-V4.1-Flash 在 DeepSWE 基准测试中以每任务 $0.43 的成本达到 GPT-6 Astra 级别的编码准确率,价格仅为 1/15。该模型采用 552B MoE 编码器-解码器分离激活架构(输入 8B、输出 16B 活跃参数),配合 KV Cache 优化(HBM 占用降至 1/4),在 Terminal-Bench 2.1 上以 12x 更低成本逼近 Astra。但在 HLE 学术推理上落后于 Astra;oracle 路由测试显示两模型组合可超越 Astra 单模型表现,凸显多模型路由系统的价值。

技术 › LLM Fireworks 2026-09-169.1 KB 24.1K 200 75

Moats & the Barbell-ification of Software

作者借用1990年代报业因互联网兴起而出现'杠铃化'的案例,类比AI时代软件业的演变。传统软件公司的护城河(复制成本、迁移成本、网络效应)将随软件开发成本趋近于零而被侵蚀。作者认为未来软件业将走向两端:少数通过海量构建与持续再投资形成规模壁垒的巨头(每个购买中心或行业一个AI原生系统),以及爆炸式增长的'小微软件'(个人或小团队自制/小众软件),中间地带的点状解决方案将被整合或消亡。风投支持的创业公司应'全都要做',以产品的整体性作为护城河。

技术 › LLM Mike Vernal 2026-09-168.3 KB 560.9K 1.3K 75

How to run your first AI UGC campaign (step-by-step guide)

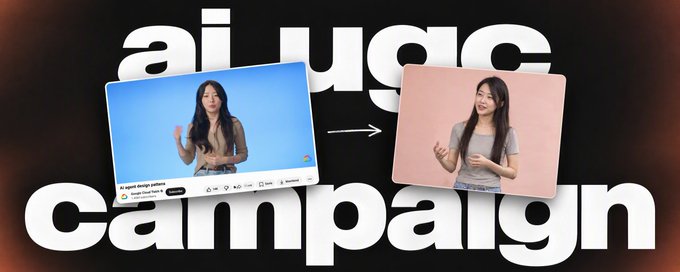
作者分享了如何用 AI 完全生成 UGC(用户生成内容)视频,将单条成本从 20-50 美元降至 4-6 美元的完整工作流。步骤包括:研究垂直领域内热门视频的钩子和人物形象;用 JSON 提示词限制图像模型的默认风格,生成具有相似气质的逼真虚拟人物(Gemini 3 Pro 效果最佳);通过 Seedance 2.5 让人物开口说话,并用原视频音频作为参考保证语调自然;用手机录屏制作产品演示;最后借助 Claude Code 和 treg_ai 批量生成 5-10 个不同钩子与演示配对测试投放效果。

技术 › LLM Jason Zhou 2026-09-1610.7 KB 180.3K 314 83