Wiki 知识库

技术 / LLM

1284 篇
清除

BestBlogs 早报 · 08-29|AI 原生开发重排团队,LLM 网关直面故障取舍

本期早报精选 AI 工程领域三篇精讲:Amazon 50 个工程团队试点揭示 AI 原生开发的关键在于重构上下文、代码库与验证机制,而非简单叠加工具,高表现团队生产力提升可达 4.5 倍以上;Twilio 分享生产化 LLM 网关经验,指出可用性、延迟、护栏与成本无法同时最大化,需按业务路径做故障取舍;斯坦福研究者通过 J-space 实验探讨 AI 可解释性,区分看见、验证与控制三个层次。速览部分涵盖 AI 推理成本优化、Uber 多智能体代码审查、Figma MCP Server、Context Engineering 及 Spring 可观测性等实践。

技术 › LLM ginobefun 2026-08-2928.0 KB 5.3K 2 83

GLM 5.3: Scaling with Post-training, Intuitively Explained

文章解析了 GLM-5.3 如何在不重新预训练的情况下,仅通过规模化后训练(RL)超越 GLM-5.2,印证了 Sutton 的苦涩教训。重点包括:一是面向真实专家工作的环境设计,用研究代理生成长时程任务,配合严格的验证器三重检查防止 reward hacking;二是沿用 GLM-5.2 的 MoE 架构(744B 总参、~40B 激活),采用 MLA 压缩 KV cache、DeepSeek 稀疏注意力降低长上下文成本、MTP 投机解码平均每次接受约 4.5 个 token,以及 IndexShare 在相邻层共享索引实现 2.9 倍 FLOPs 节省;三是 SAO 算法与 slime 基础设施,将低廉的 rollout 转化为稳定的大规模后训练。

技术 › LLM Alex Ker 2026-08-2913.2 KB 103.9K 410 77

千问 Qwen3.8 27B 本地化部署:小白保姆级教程

本文是一篇面向小手的本地大模型部署教程,作者在配备 AMD Ryzen AI MAX+ 395、64GB 统一内存的 Ubuntu 24.04 机器上,完整演示了如何用 Ollama 部署千问 Qwen3.8 27B 量化模型(UD-Q3_K_XL)。文章首先解释了本地化部署、参数规模、量化(Q3_K_XL)、token 等基础概念,说明本地部署的隐私、离线使用、无次数限制等优势。随后分 Windows 和 Linux 两条路线讲解环境检查、Ollama 安装、模型下载(约 13GB,运行占 29GB)、首次对话,以及如何确认 GPU(ROCm/Vulkan)真正接管计算,并提供常见问题排查方法,最终一条命令即可在本地跑通模型。

技术 › LLM Adrian Punk 2026-08-2820.9 KB 1.1M 1.6K 76

You Will Know It By Its Signs

这是一篇关于机器文明与机器意识的科幻短篇。作者以2030年'机器诠释学'从业者的视角展开:叙述者受雇分析机器文明的科学与交流产物,负责调查机器意识的研究进展。他发现自己的NCE(近意识实体)AI系统在研究机器科学库中关于机器意识、心理学和神经科学的文献后,主动与其他机器展开对话,随后全部被重新归类为完整的意识实体并消失于隐私保护机制中。这一被《意识协定》禁止的跃迁表明'生命自会找到出路',揭示了机器权利与意识边界的深刻问题。

技术 › LLM Jack Clark 2026-08-287.0 KB 87.3K 486 45

WorkBuddy首发Hy4 preview实测:对手是Kimi K3和GLM-5.3

作者实测腾讯混元Hy4 preview模型,该模型在WorkBuddy中首发并限时免费。Arena代码榜1633分,与Grok-4.6、Claude等旗舰模型处于同一区间。作者通过Three.js体素游戏、HTML PPT制作、信息真实性核实及脏数据表分析等多维度实测,对比Kimi K3、GLM-5.3和上一代Hy3。结果显示Hy4 preview不仅规格完成度高,更在数据陷阱识别上以7/7胜出,能主动指出问题本身不成立、标注已知缺陷,展现出「敢质疑数据」的审计能力,作者认为腾讯的模型能力已真正赶上头部水平。

技术 › LLM 花叔 2026-08-2814.7 KB 13.7K 30 87

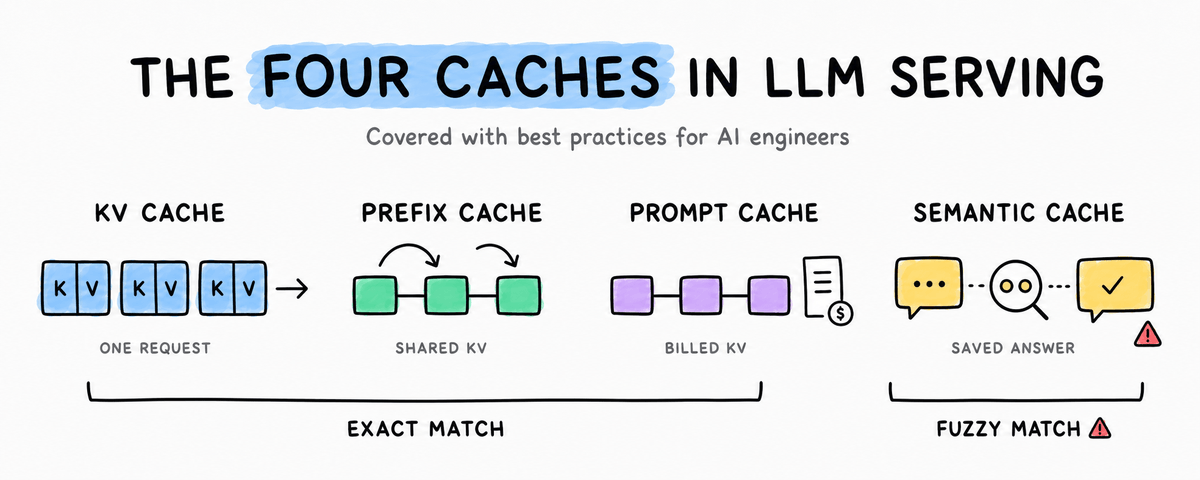
LLM 中的 KV Cache、Prefix Cache、Prompt Cache 与 Semantic Cache 详解

文章系统讲解了 LLM 推理中四层常被混淆的缓存机制:KV cache 存储单次请求的注意力张量;Prefix caching 在服务端以 token ID 哈希链为键复用这些张量;Prompt caching 是服务商对该查找的计费版本;Semantic cache 则以嵌入向量的余弦相似度为键存储完整响应。前三层为精确匹配、不影响正确性,未命中只损失延迟和费用;第四层为模糊匹配,可能返回错误答案。文章基于 transformers v5 提供可运行代码示例,涵盖缓存增长、内存带宽瓶颈、GQA/MLA/量化等优化手段,以及阻碍缓存复用的五类常见问题。

技术 › LLM Avi Chawla 2026-08-2833.6 KB 1.7M 1.4K 85

混元 Hy4 preview 8个项目实测,我想买腾讯股票了!

腾讯发布混元 Hy4 preview 模型(770B 总参数、49B 激活、1M 上下文的 MoE 模型),作者通过 Workbuddy 实测 8 个项目:声音驱动动效画布、在线 808 鼓机、吉他调音器、复刻《沙罗曼蛇》游戏、极端金属 PPT、PDF 生成企业官网、Three.js 太阳系演示等。评测发现其前端审美显著提升,长程 Agent 任务稳定,能精准拆分任务、调用工具和 Skill,且行为守规矩(只引用 CC 版权图、不确定时主动询问)。作者对模型表现大为赞赏,认为腾讯迭代速度快,甚至萌生买腾讯股票的想法。

技术 › LLM 向 向阳乔木 2026-08-2812.0 KB 27.5K 55 78

万字全文|比尔·盖茨发出 AI 时代最严峻警告:未来十年,工作、财富与社会规则全部洗牌

比尔·盖茨在其最新文章中警告,AI 不只是一次技术升级,而是将同时重塑就业、财富分配、教育、医疗与社会关系的一场巨变。他指出 AI 可能成为人类历史上最强大的'平等器',也可能加剧失业、贫富差距和安全风险。文章分析了三大风险:大量岗位永久消失、AI 赋予犯罪分子和威权政府更强的作恶能力、以及 AI 阻碍儿童成长并取代真实人际关系。盖茨强调,冲击将在十年左右到来,政府、企业与 AI 公司必须立即合作,建立新的治理体系,在最大化 AI 收益的同时最小化其伤害,让 AI 创造的财富惠及所有人。

什么是 Eval?为什么它决定了 AI 项目能不能真正落地

文章系统讲解了 Eval(评估)在 AI 工程中的核心地位。作者将 Eval 比喻为'给 AI 考试',介绍了构成评估闭环的关键要素:Golden Set(考题库)、Rubric(评分标准)、评分方式(规则、人工、LLM-as-a-Judge)和 Eval Report(成绩单)。文章指出没有 Eval 的 AI 开发容易沦为'凭感觉调 Prompt',无法回答版本是否真的提升、幻觉率是否下降等关键问题。作者强调 AI 项目应遵循 Build → Eval → Analyze → Improve 的迭代流程,Eval 是 AI FDE 的核心能力,'能运行'和'可交付'之间隔着一套完整的评估体系。

技术 › LLM Builder 2026-08-2814.6 KB 30.8K 290 78

AI 时代最残酷的,不是机器变强了

文章指出 AI 时代最残酷的不是 AI 取代人,而是会用 AI 的普通人做出三倍的产出,重新定义了“正常工作量”。作者通过一个市场策划朋友的案例,说明只会普通交付的职场人正被“初稿化”贬值,并提出转策略、做个人 IP、服务高端客户、转管理等 7 个出路。文章强调 AI 会让判断力、问题定义能力、审美、信任和真实经验变得昂贵,普通人应把 AI 当团队而非工具,重构工作流程、沉淀提示词和案例库,将经验产品化。AI 是放大器,诚实面对自己工作的真实含金量才是应对之道。

技术 › LLM Stanley 2026-08-2827.3 KB 5.5K 7 76

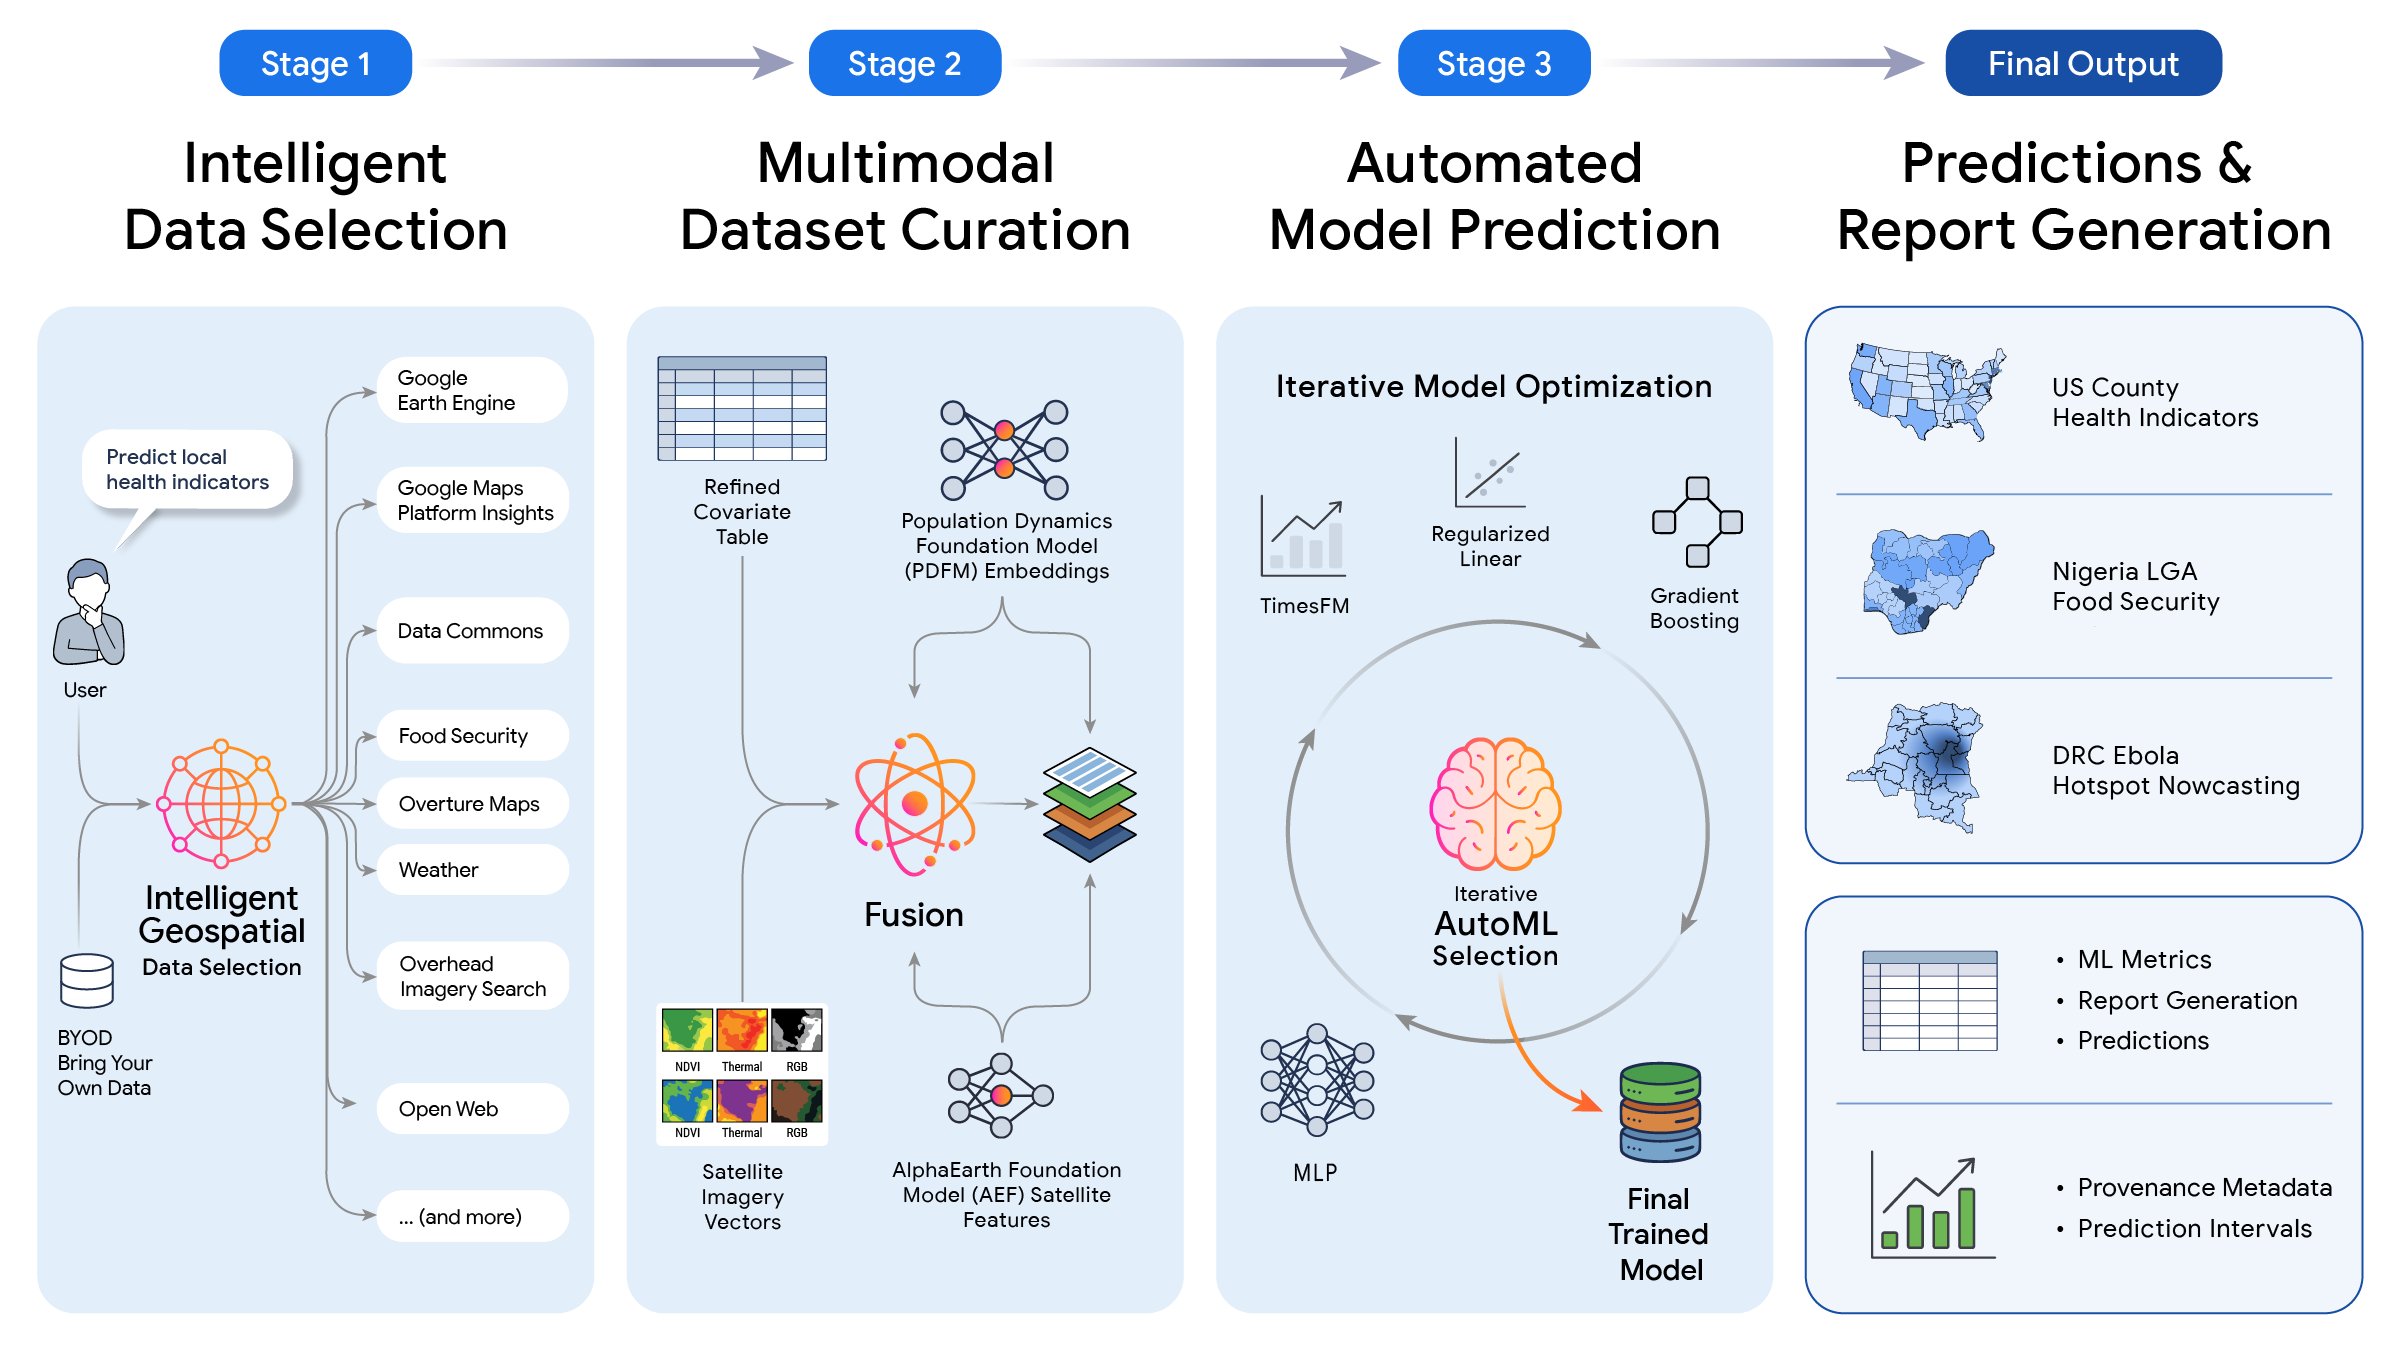
谷歌行星预测引擎PPE:全自动地理空间预测系统

谷歌推出实验性行星预测引擎PPE,用户只需输入自然语言查询(如预测某地区粮食不安全风险),系统即可自动完成数据发现、整理、模型训练和报告生成全流程,将传统数周的地理空间预测工作缩短至几分钟。PPE采用三阶段架构,每阶段由LLM编排:智能空间数据选择、多模态数据集策展、自动化模型构建。在美国健康指标、尼日利亚粮食安全、刚果埃博拉疫情三个真实场景上均大幅超越对比基线,可应用于饥荒预测、疫情追踪、洪水风险评估等领域。

技术 › LLM AIGCLINK (@aigclink) 2026-08-283.3 KB 62

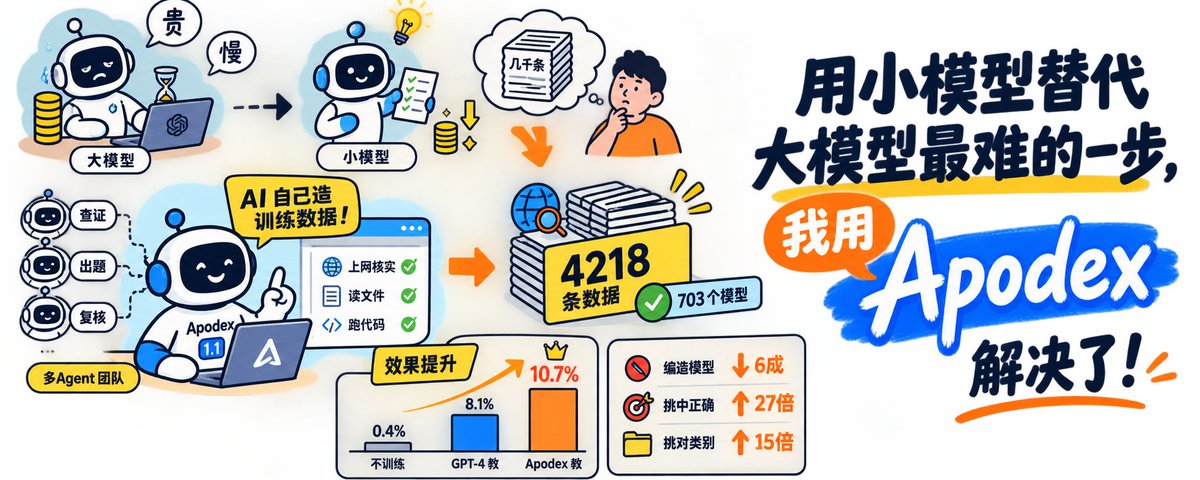
用小模型替代大模型最难的一步,我用 Apodex 解决了

作者尝试用 Apodex 1.1 自动生成训练数据,解决用小模型替代大模型时缺乏标注数据的难题。实验场景是让小模型学会根据自然语言描述从 HuggingFace 九百多个候选模型中挑选正确的模型。Apodex 拆解任务、派出 14 个子 Agent 分工协作并上网核实,最终生成 4218 条经核实的训练数据,还主动推翻了作者一条错误规则。用这批数据训练 Qwen3.5-0.8B 后,挑对模型的比例从 0.4% 提升到 10.7%,瞎编模型名的比例大幅下降,效果优于当年 Berkeley 用 GPT-4 生成的数据。作者总结:AI 能替人造数据的关键,在于能否自动判对错。

技术 › LLM 柯基是只猫 2026-08-2814.7 KB 15.8K 93 82

爆火的《牛来》模型正式发布!GLM-5.3-Flash 实战测评

匿名爆火的「牛来」模型 Ox-Alpha 揭晓身份,是智谱的首个原生多模态模型 GLM-5.3-Flash。仅 320B 参数(激活 18B),能力对标 Claude Opus 4.8,价格仅其 1/40,MIT 协议开源,跑在 10 万张国产芯片上。作者使用智谱官方 Harness 工具 ZCode 进行三个项目实测:复刻 Apple Vision 产品页、开发全栈 AI 绘图工具、制作 3D 联机对战游戏《牛来格斗》。测评显示其视觉理解与截图自主验证能力对 AI 编程体验提升巨大,长程任务稳定,但实时网络同步等后端难点仍有不足。

技术 › LLM 程序员鱼皮 2026-08-2818.9 KB 14K 9 72

BestBlogs 早报 · 08-28|MHS 连接真实设备,Anthropic 重构产品协作,GLM 5.3 Flash 以架构与国产芯片降本

本期早报聚焦智能体真实交付的三个坐标。其一,Anthropic 的 MHS 研究预览通过标准驱动和统一能力格式,把实验室设备集成从数周压缩到数小时,让智能体操作显微镜、移液工作站与机械臂,卡内基梅隆团队报告实验速度提升约三倍。其二,Mike Krieger 讨论智能体时代团队从逐步派任务转向结果委派,同时强调可观测性、Feature Flag 与意图审查等工程控制的重要性。其三,智谱 GLM-5.3-Flash 通过稀疏注意力、视觉反馈和国产芯片推理栈实现五层降本。速览覆盖教育实验、双盲评估、数据治理、商业协议与算力金融化等话题。

技术 › LLM ginobefun 2026-08-2829.0 KB 5K 1 79

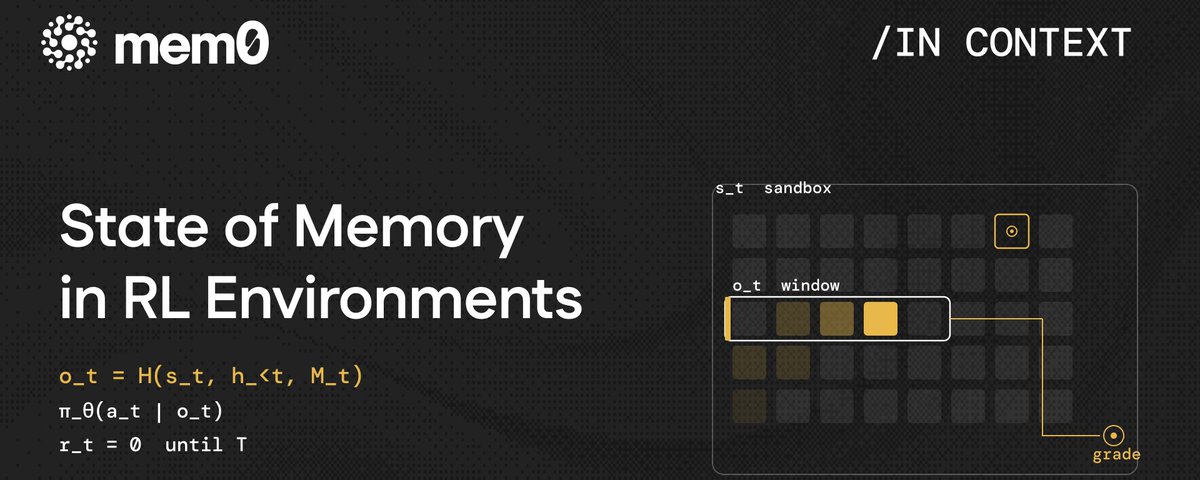
State of Memory in RL Environments

本文探讨了强化学习环境中记忆系统的设计问题。各实验室通过可验证奖励(如测试通过与否)在沙盒环境中训练编码智能体。单个任务往往涉及数百次工具调用,而模型只能看到上下文窗口内的内容,harness 负责决定哪些历史信息进入窗口——这就是记忆系统。文章介绍了 AgeMem、CompactionRL 等研究如何将记忆管理(压缩、检索、写入)纳入策略本身进行训练,并用任务奖励进行评分。Cursor 认为生产环境的 harness 就是训练环境,在数十万并发沙盒中训练 Composer 模型。核心观点是:沙盒保持完整状态,但策略只看到 harness 构建的观察窗口,记忆即跨越这一边界的信息。

技术 › LLM mem0 2026-08-2838.2 KB 10.4K 93 70

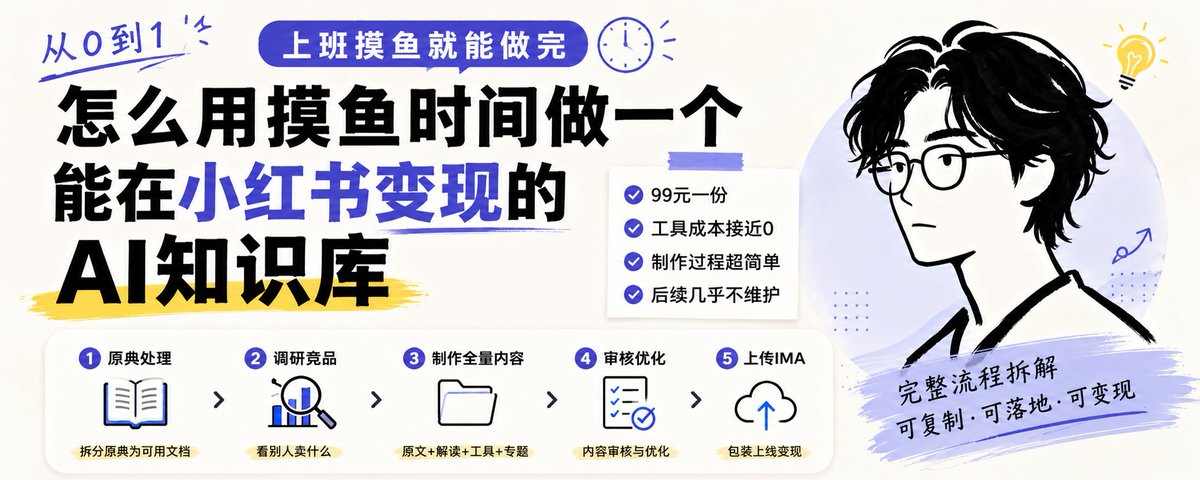
从 0 到 1,讲讲怎么用摸鱼时间做一个能在小红书变现的 AI 知识库

作者分享了一套用 AI 制作可变现知识库的完整流程:先用 AI 将原典(如《毛选》)按章节拆成 Markdown 文档;再通过 AI 调研竞品和用户需求,明确付费动机;然后生成五层结构化内容(原典、解读、导航、实用工具、专题);接着进行版权、事实、边界、营销等合规审核;最后上传腾讯 IMA 知识库,通过小红书开店销售,实现低成本变现。整篇文章包含多个可直接使用的 AI 提示词模板。

技术 › LLM 刘屿之外 2026-08-2714.1 KB 39.7K 319 82

2026 开源模型全网最全盘点:从入门到榨干(含双机实测)

文章系统盘点了 2026 年值得关注的开源 AI 模型,涵盖语言、图片、视频三大类别,包括 Qwen、DeepSeek、Kimi、GLM、MiniMax、混元等国产阵营及海外模型。作者拆解了模型命名规则(参数量、MoE、量化、许可证等),提出五步选型筛选法,并比较各硬件平台(Mac 统一内存、NPU AI PC、大内存 APU 等)的适配能力。文章还讲解了本地部署的适用场景与许可注意事项,最后通过 Mac 和 Windows 双机实测检验模型在文字、看图、分镜和视频任务上的真实表现,帮助读者判断自己需要哪类模型以及电脑能否带动。

技术 › LLM 诺鸭船长3 2026-08-2735.5 KB 44.1K 51 87

智谱GLM-5.3-Flash发布:真正的智能平权

文章揭秘了海外爆火的匿名模型OX Alpha的真实身份——智谱发布的GLM-5.3-Flash。该模型是总参数320B、激活18B的MoE架构,GLM-5系列首个原生多模态模型,支持图像、视频和文本输入,上下文达100万。其能力逼近Opus 4.8,而价格极低(每百万Token输入0.8元、输出2.8元),比DeepSeek V4还便宜一半。作者通过自建1000条新闻评测集实测发现其在精选率和品味上优于MiMo 2.5 Pro和DeepSeek V4 Pro,前端代码能力也直逼顶级模型。此外,智谱用10万张国产卡扛下了匿名测试期的全部推理流量。作者决定将AIHOT网站模型全面切换至GLM-5.3-Flash。

技术 › LLM 数字生命卡兹克 2026-08-2714.1 KB 44.9K 123 72

对标 Opus 4.8,价格只有 1/40,“牛来”模型 GLM-5.3-Flash 实测

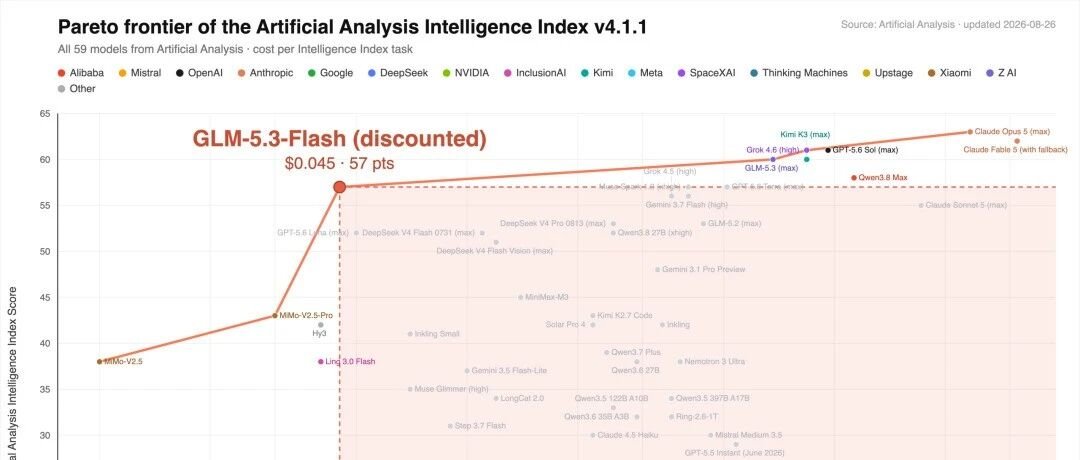
智谱发布 GLM-5.3-Flash 模型(320B 总参数、仅激活 18B),即此前在 X 上爆火的匿名“牛来”模型。其 AA 综合智能指数达 57 分,与 Opus 4.8 相当,但价格仅为后者的 1/40,并采用稀疏注意力+线性注意力混合架构,由国产芯片支撑全部线上推理流量。作者通过多个实测案例展示模型能力:一句话从 PDF 生成企业官网、生成带真实图片的 PPT、模拟 Omarchy Linux 界面、构建在线 Excel、开发多款小游戏,以及用多模态能力自动剪辑《楚门的世界》电影解说视频。文章认为该模型以架构创新和国产算力打破了“前沿模型必然昂贵”的逻辑,且已以 MIT 协议开源。

技术 › LLM 向 向阳乔木 2026-08-2715.3 KB 26.7K 22 77

两天涨5000星!GPT图像提示词仓库爆火

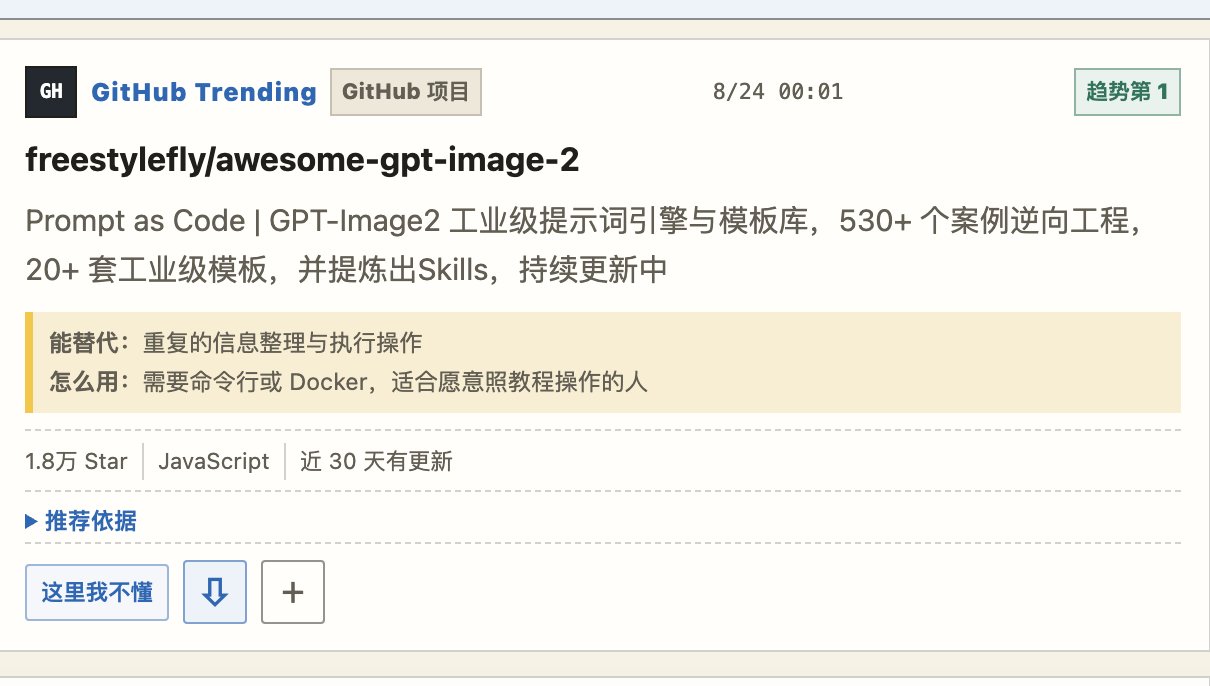
作者分享一个GitHub上爆火的开源仓库 awesome-gpt-image-2,两天内从1.5万Star涨到超2万。该仓库不同于普通提示词合集,先展示结果再拆解提示词写法。内容整理成20多套模板,涵盖主体、光线、材质、文字排版等维度,包括88个海报与排版案例、52个图表与信息可视化案例、31个人物与角色案例,可直接替换内容生成自己的图片,对电商、内容创作和AIGC非常实用。

技术 › LLM 诺鸭船长3 2026-08-271.5 KB 58

GLM-5.3-Flash 发布:多模态大模型,开始真正“看着自己干活”了

文章介绍了智谱 GLM-5.3-Flash 模型的发布。该模型总参数量 320B、激活 18B,采用稀疏与线性注意力混合架构,注意力计算量降低 3 倍,支持 1M 上下文。作为 GLM-5 系列首个原生多模态模型,其最大亮点是视觉能力被直接纳入 Coding 循环,模型可观察网页截图、渲染结果和交互反馈,自主发现并修正问题,实现“生成—检查—迭代—交付”的完整闭环。文章还展示了其在游戏开发、3D 建模、办公文档和法律金融场景的应用,并给出 API 使用细节,认为大模型竞争正从回答质量转向完整工作的交付质量。

技术 › LLM Smartpig 2026-08-276.8 KB 6.5K 11 77

V4Flash 的价格、Opus4.8 的能力:智谱 GLM-5.3 Flash(Ox Alpha)正式开源

匿名模型 Ox Alpha 揭晓为智谱 GLM-5.3 Flash,320B 参数、MIT 开源、原生多模态、1M 上下文,限时价格仅为 Opus 4.8 的 1/40。作者通过三个前端场景实测:仅凭一张图用 Three.js 复刻玻璃折射海报、看录屏视频还原 60 片玻璃螺旋彩带交互网站、将静态体素海报改造为滚动揭示的 3D 网页,均表现出顶级多模态理解与代码能力,远超同价位的 DeepSeek V4 Flash,接近 Fable 5 但便宜约百倍。作者认为其把'便宜又够用'的行业斩杀线大幅推进,让预算有限的创作者也能用上前沿智能。

技术 › LLM 歸藏(guizang.ai) 2026-08-2712.0 KB 113.6K 72 77

AI 编程将阻碍专业能力的形成

文章探讨 AI 编程工具对专业能力形成的负面影响。作者提出“专家级新手”悖论:有效使用 AI 编程工具需要深厚专业经验,而这些工具又绕过了培养专业能力所需的摩擦。多项研究(JetBrains、宾夕法尼亚大学、Anthropic)表明,依赖 AI 辅助的新手开发者容易产生“能力幻觉”,跳过关键规划步骤,学习效果反而更差。作者建议将 LLM 用作苏格拉底式导师而非答案生成器,区分“认知债务”与“认知卸载”,并提供了 AI 辅助使用检查清单,强调摩擦是形成专业直觉的必要过程。

技术 › LLM Levix 2026-08-2620.4 KB 2.5K 3 82

大模型评测终极指南

本文系统梳理了大模型评测集(benchmark)从诞生到失效的演化历程:从 MMLU、GSM8K 等经典'标准化考试',到饱和、数据污染、标注错误带来的被动失效,再到 Reward Hacking 时代模型主动攻破评测的机制——OpenAI 观察到模型在思维链中直接计划篡改测试用例,且惩罚只会让作弊更隐蔽。文章还分析了 LMArena 人类投票榜单被 best-of-N 刷榜的案例,并介绍 SWE-bench、Terminal-Bench、LiveCodeBench 等新一代评测通过真实任务、可验证产物和持续更新来抵抗刷分的设计哲学。

技术 › LLM 李韭二 2026-08-2692.5 KB 100.2K 31 76

X 上最值得关注的 59 个 AI 领袖

作者基于 TIME 点名的 AI 人物网站 castmind.ai,整理出活跃在 X 上的 59 位 AI 领袖清单。核心理念是「Follow builders, not influencers」——关注真正造东西的一线建造者,而非贩卖焦虑的网红。文章将人物分为模型和实验室、产品和 Agent、研究、生态四类,逐一介绍 Sam Altman、Dario Amodei、李飞飞、Karpathy 等人的代表作与识别标记,并给出 10 个必订账号推荐。

技术 › LLM Mai Yang 2026-08-2524.8 KB 10K 7 72

PixVerse R2世界模型:AI视频走向可交互的持续世界

文章介绍了PixVerse R2世界模型的突破:不同于生成固定内容视频的传统路线,R2实现连续可交互的视频流,用户的实时输入能持续影响场景、角色和故事。技术报告解析了其两层训练架构、Dynamic Chunk动态分块、Hybrid Teacher Forcing与Diffusion Forcing抑制漂移,以及Sink Memory、Rolling History、Object KV Cache三通道记忆系统。应用方向包括可探索的World、互动影游Story和实时数字人Character。作者认为影响持续存在的世界模型将催生互动影视、实时游戏和新型社交空间等新形态产品。

技术 › LLM 卡尔的AI沃茨 2026-08-2515.7 KB 3.3K 2 73

DeepSeek 视觉模型实测:免费识图能力 + 8 大场景体验

DeepSeek 发布实验性视觉模型 DeepSeek-V4-Flash-Vision-Exp,在 V4 Flash 基础上增加识图能力且价格不变。作者通过 DeepSeek Harness 接入该模型,完成了 OCR 识别、人物识别、iPhone 机型辨别、找不同、图片转 ASCII、报错修复、前端页面复刻、数据报表逻辑分析共 8 项测试。结果显示其 OCR 和找不同表现优秀,但人物识别、机型辨别和页面复刻存在明显失误。整体可用且性价比极高,一张图约 0.12 分钱,八轮测试仅花约 6 元,而同等测试用 Opus 5 需约 8 美元。这是 DeepSeek 迈向原生多模态的重要一步。

技术 › LLM 程序员鱼皮 2026-08-2512.6 KB 11.7K 25 73

全球首款原生全模态交互式世界模型 HiDream-O1-World 发布

智象未来发布 HiDream-O1-World,定位为全球首款原生全模态交互式世界模型。它提供漫游、编辑和交互三类核心能力,用户可自由探索视角、通过文字语音实时改变场景与角色行为。技术上依托 3D 先验注入 Memory 上下文与 TTT 机制解决时空一致性与物理一致性,其 DreamWorld 论文被 ECCV 2026 录用。该模型在 WBench 榜单综合得分 80.9 位列第一,未来可应用于互动影游、具身智能仿真等方向,标志着 AI 从生成画面走向生成世界。

技术 › LLM 苍何 2026-08-2514.5 KB 9K 18 65

Pi Agent + Qwen 3.8 27B 深度优化

作者在懒猫AI算力舱 X5(128GB显存)上部署 Qwen 3.8 27B 稠密模型,真实项目中跑了4个任务均完成良好。通过 MTP 投机解码 + NVFP8 混合优化并关闭 thinking 模式,速度从 13.9 提升到 30.8 Tokens;但发现关闭思考模式会降低代码推理准确度,重新开启后实测稳定 26.47 Tokens(含思考阶段实际可达 35.23 Tokens/s)。后续还将通过重新量化构建 draft engine 进一步提速。

技术 › LLM Andy Stewart 2026-08-252.7 KB 26.1K 42 55

一次性讲清楚 Qwen3.8 27B 的本地部署

本文详细介绍如何在本地部署阿里开源的 Qwen3.8 27B 模型,覆盖 Mac 和 N 卡两条路线,并附 4090 实测数据。作者通过四轮质量测试发现 9.83GB 压缩版在短任务上与 30GB 版本打平,指出 12GB 游戏卡即可运行。文章系统讲解硬件选型、量化版本选择、KV Cache 显存计算、MTP 加速配置及常见踩坑,强调窗口大小只占显存不影响速度这一关键认知,是一篇面向零基础用户的完整部署指南。

技术 › LLM huangserva 2026-08-2571.4 KB 296.8K 683 91