Wiki 知识库

技术 / LLM

1279 篇
清除

BestBlogs 早报|OpenAI 发布 GPT-6 选型指南,LEO 分析智能体采购部署,Airbnb AI 改造延伸到客服测试

本期早报围绕 AI 智能体的选型、部署与落地展开。精讲一介绍 OpenAI GPT-6 系列模型使用指南,讲解 Astra、Sol、Luna 三款模型的定位、推理强度调节、提示词缓存与成本优化策略。精讲二是 a16z 与采购智能体公司 LEO 的访谈,探讨企业 Agent 部署为何比构建更难,强调系统记录之外的例外流程决定 Agent 能力边界。精讲三介绍 Airbnb 由内而外的 AI 改造,包括原型协作、Everest 知识复用平台及 AI 客服实践。速览涵盖替代 GPU 的计算路线、Spring AI 模块化 RAG、Fractile 推理芯片、Pi 的 MCP 支持与持久化框架、Cloudflare AI Search 及 Instinct 个人智能体等内容。

技术 › LLM ginobefun 2026-10-0324.1 KB 2.9K 1 77

Hinton、Bengio 等 20 多位研究者联名发论文:AI 正在接手 AI 研发,智能爆炸可能不远了

剑桥大学 AI 科学与政策项目发布论文,Hinton、Bengio 等 20 多位顶尖研究者联名讨论 AI 研发自动化可能引发的智能爆炸。数据显示 Anthropic 审核代码中 AI 写的比例已超 80%,AI 可独立完成的研发任务时长每 3 个月翻一番。若研究投入回报率 r 维持 1.2-1.9,约 1.5 年后 AI 进步速度将达现在 10 倍。论文分析了算力、数据等四类刹车因素,指出能力失控、人类失去监督、权力制衡失效三类风险,并提出透明报告、能力上限、应急预案三条政策建议,强调必须现在开始准备。

技术 › LLM 宝玉 (@dotey) 2026-10-036.5 KB 71

用 Opus 5.5 全自动制作吃瓜视频:找素材、配音一站搞定

作者尝试用 Opus 5.5 全程自动制作吃瓜(八卦)短视频,包括自动搜集素材、生成文案、用 Gemini 3.8 Flash TTS 配音,中英文两个版本,整个流程仅耗时半小时。文中分享了完整 Prompt 设计:内容要求八卦有冲突但事实准确、开头3秒抓眼球、素材以视频片段为主、9:16竖版4-6分钟、自动压低BGM、添加水印、封面设计等细节,还支持生成去敏版本。评论区讨论了此类方法对影视解说自动化的启发。

技术 › LLM 宝玉 (@dotey) 2026-10-033.3 KB 67

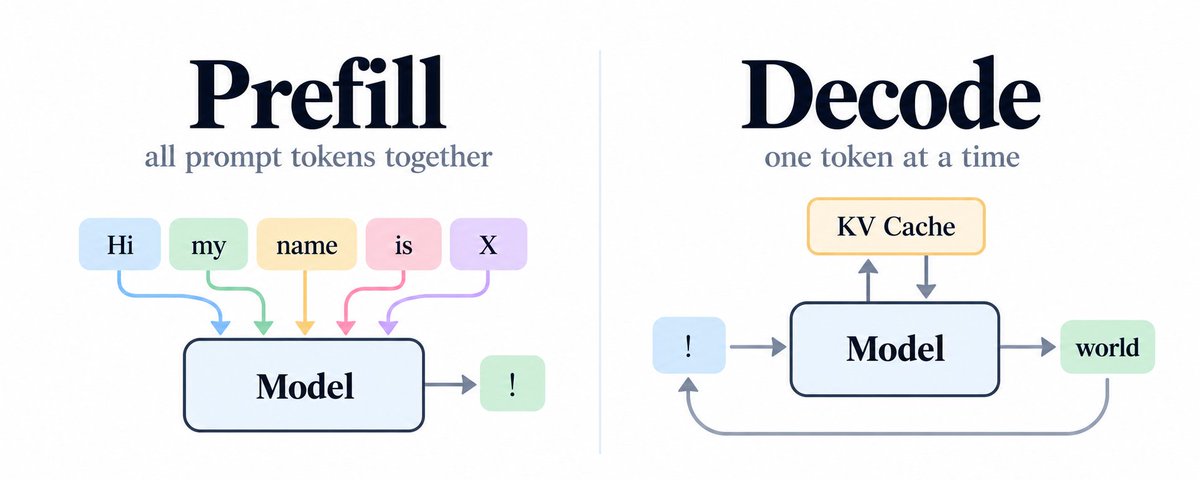
Prefill & Decode made Crystal Clear

本文从第一性原理出发,逐步讲解 LLM 推理过程中 Prefill 和 Decode 两个阶段的真实含义。作者先介绍自回归模型逐 token 预测的基本机制,然后通过 ChatGPT 聊天的例子,展示文本如何经过分词、token ID、embedding 转化为 S×D 矩阵并进入 Transformer 层。重点澄清一个常见误解:处理输入 prompt 时模型并非逐个 token 顺序处理,而是因为所有输入 token 已知,可以并行处理——这一整个输入处理过程就是 Prefill。文章还引出因果掩码等问题,帮助读者建立对推理流程的正确直觉。

技术 › LLM Abhinandan 2026-10-0326.3 KB 9.2K 133 64

用 Opus 5.5 搭建内容生产机器(完整教程)

本文是一份完整课程式教程,介绍如何利用 Opus 5.5 模型(通过 Viktor 平台)搭建一套可持续的内容生产系统。作者分步骤讲解:整理个人素材与写作范例、设置 AI 内容助手并编写常驻指令、基于范例生成写作风格指南、建立带上下文的创意收件箱、让 AI 提交可选择的选题提案、以及在写作前准备研究笔记。目标是把想法、研究和专业知识持续转化为符合个人风格的文章、帖子和简报,避免每次发布都重新搭建流程,并配有每周例行的内容批量生产机制。

技术 › LLM J.B. 2026-10-0215.1 KB 40.7K 585 76

从零开始学 AI:小白也能看懂的常见 AI 术语讲解(一)

本文是 AI 术语科普系列的第一期,面向小白读者,用通俗易懂的语言讲解 11 个常见 AI 概念:大语言模型(LLM)、多模态、提示词(Prompt)、Token(词元)、上下文、记忆、知识库、Agent(智能体)、Skills(技能)、工作流和 AI 幻觉。作者金尘马解释了模型与应用的区别、Token 与计费和上下文窗口的关系、记忆与上下文的差异,并对比了工作流的固定流程与 Agent 的自主决策,帮助读者扫清学习 AI 路上的术语障碍。

技术 › LLM 金尘马 2026-10-0214.7 KB 27.6K 111 59

Claude Opus 5.5 提示词指南要点速览

Claude 官方发布了 Claude Opus 5.5 的提示词指南,核心要点包括:合理设置思考档位 effort,日常用 medium 即可兼顾质量与成本;想让模型少想就调低档位,无需在提示词中要求“仔细思考”;避免要求模型写出推理过程,查看思考摘要即可;多轮对话时告知模型已完成的问题无需重想;要求模型汇报进度后继续执行长任务而不中途停下;明确告知模型做完即停以减少多余操作(官方测试可省三分之一花费);只要方案时提前说明;编程任务要求先运行验证再下结论;要求越具体效果越好。总结:调对档位 + 说清要求是用好模型的关键。

技术 › LLM 程序员鱼皮 2026-10-023.1 KB 81

AI 会替代人的工作吗?我们担心的到底是什么?|托马斯的硅谷来信 002

作者从历史案例出发(ATM 与银行柜员、蒸汽机与杰文斯悖论),探讨 AI 对就业的真实影响:工作清单从不是固定的,替代背后也藏着看不见的增量。通过应届生 AI 海投简历、给 Agent 看的广告、AI 家族纪录片等案例,说明智能变便宜会催生新需求与产业重构。作者指出个人焦虑源于相对剥夺感与损失厌恶,建议不要只盯着具体技能(如写代码),而要聚焦创造的价值,服务好半熟人群体——因为 AI 让干活变便宜后,信任反而越来越值钱。

技术 › LLM Thomas Zhou 2026-10-0216.1 KB 16.5K 38 75

We'll be spending a lot more time trying to understand the outputs of language models

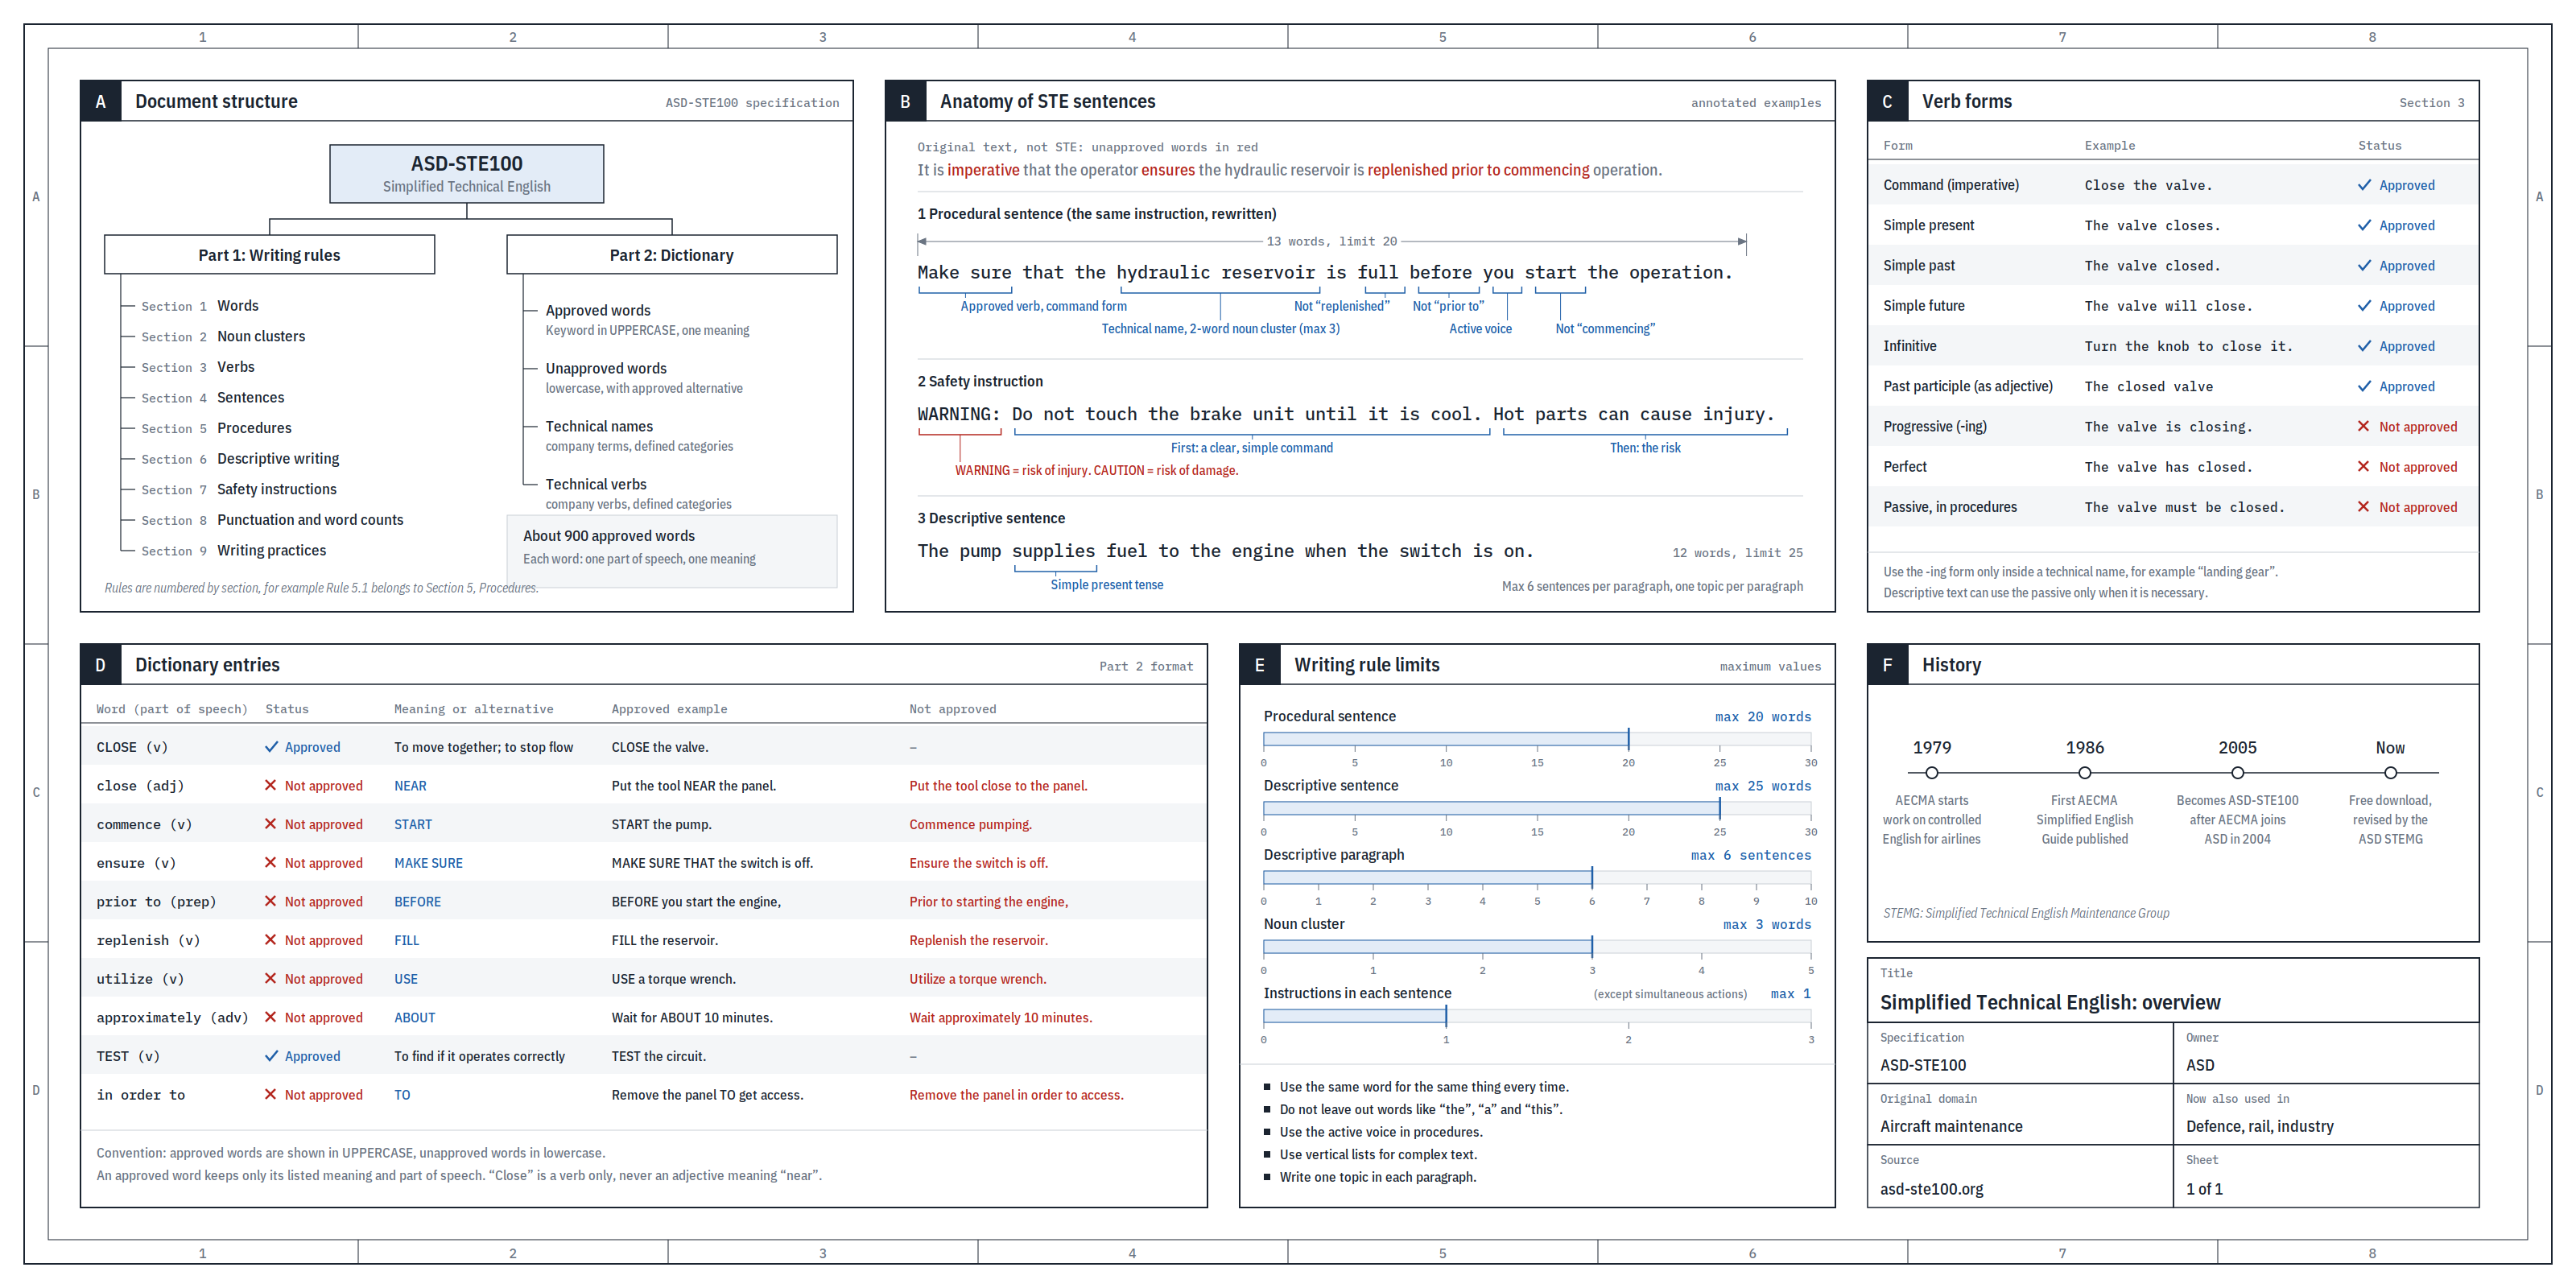
Karpathy 分享了理解和消化 LLM 输出的技巧与思考。他建议从纯文本逐步升级到更好的输出形式:用 ASD-STE100 受控语言规范让 LLM 输出更简洁易读的文字;再进一步要求生成图表;更好是直接输出 HTML 交互网页;他最看好定制化讲解视频,如 3b1b 风格并结合 ElevenLabs 语音解说。他总结:随着 LLM 能力增强,人类工作将更多转向监督与理解层面,而 LLM 本身也能生成大量以前不值得做的定制、可抛弃的软件产物,帮助人们完成这一转变。

技术 › LLM Andrej Karpathy 2026-10-022.1 KB 73

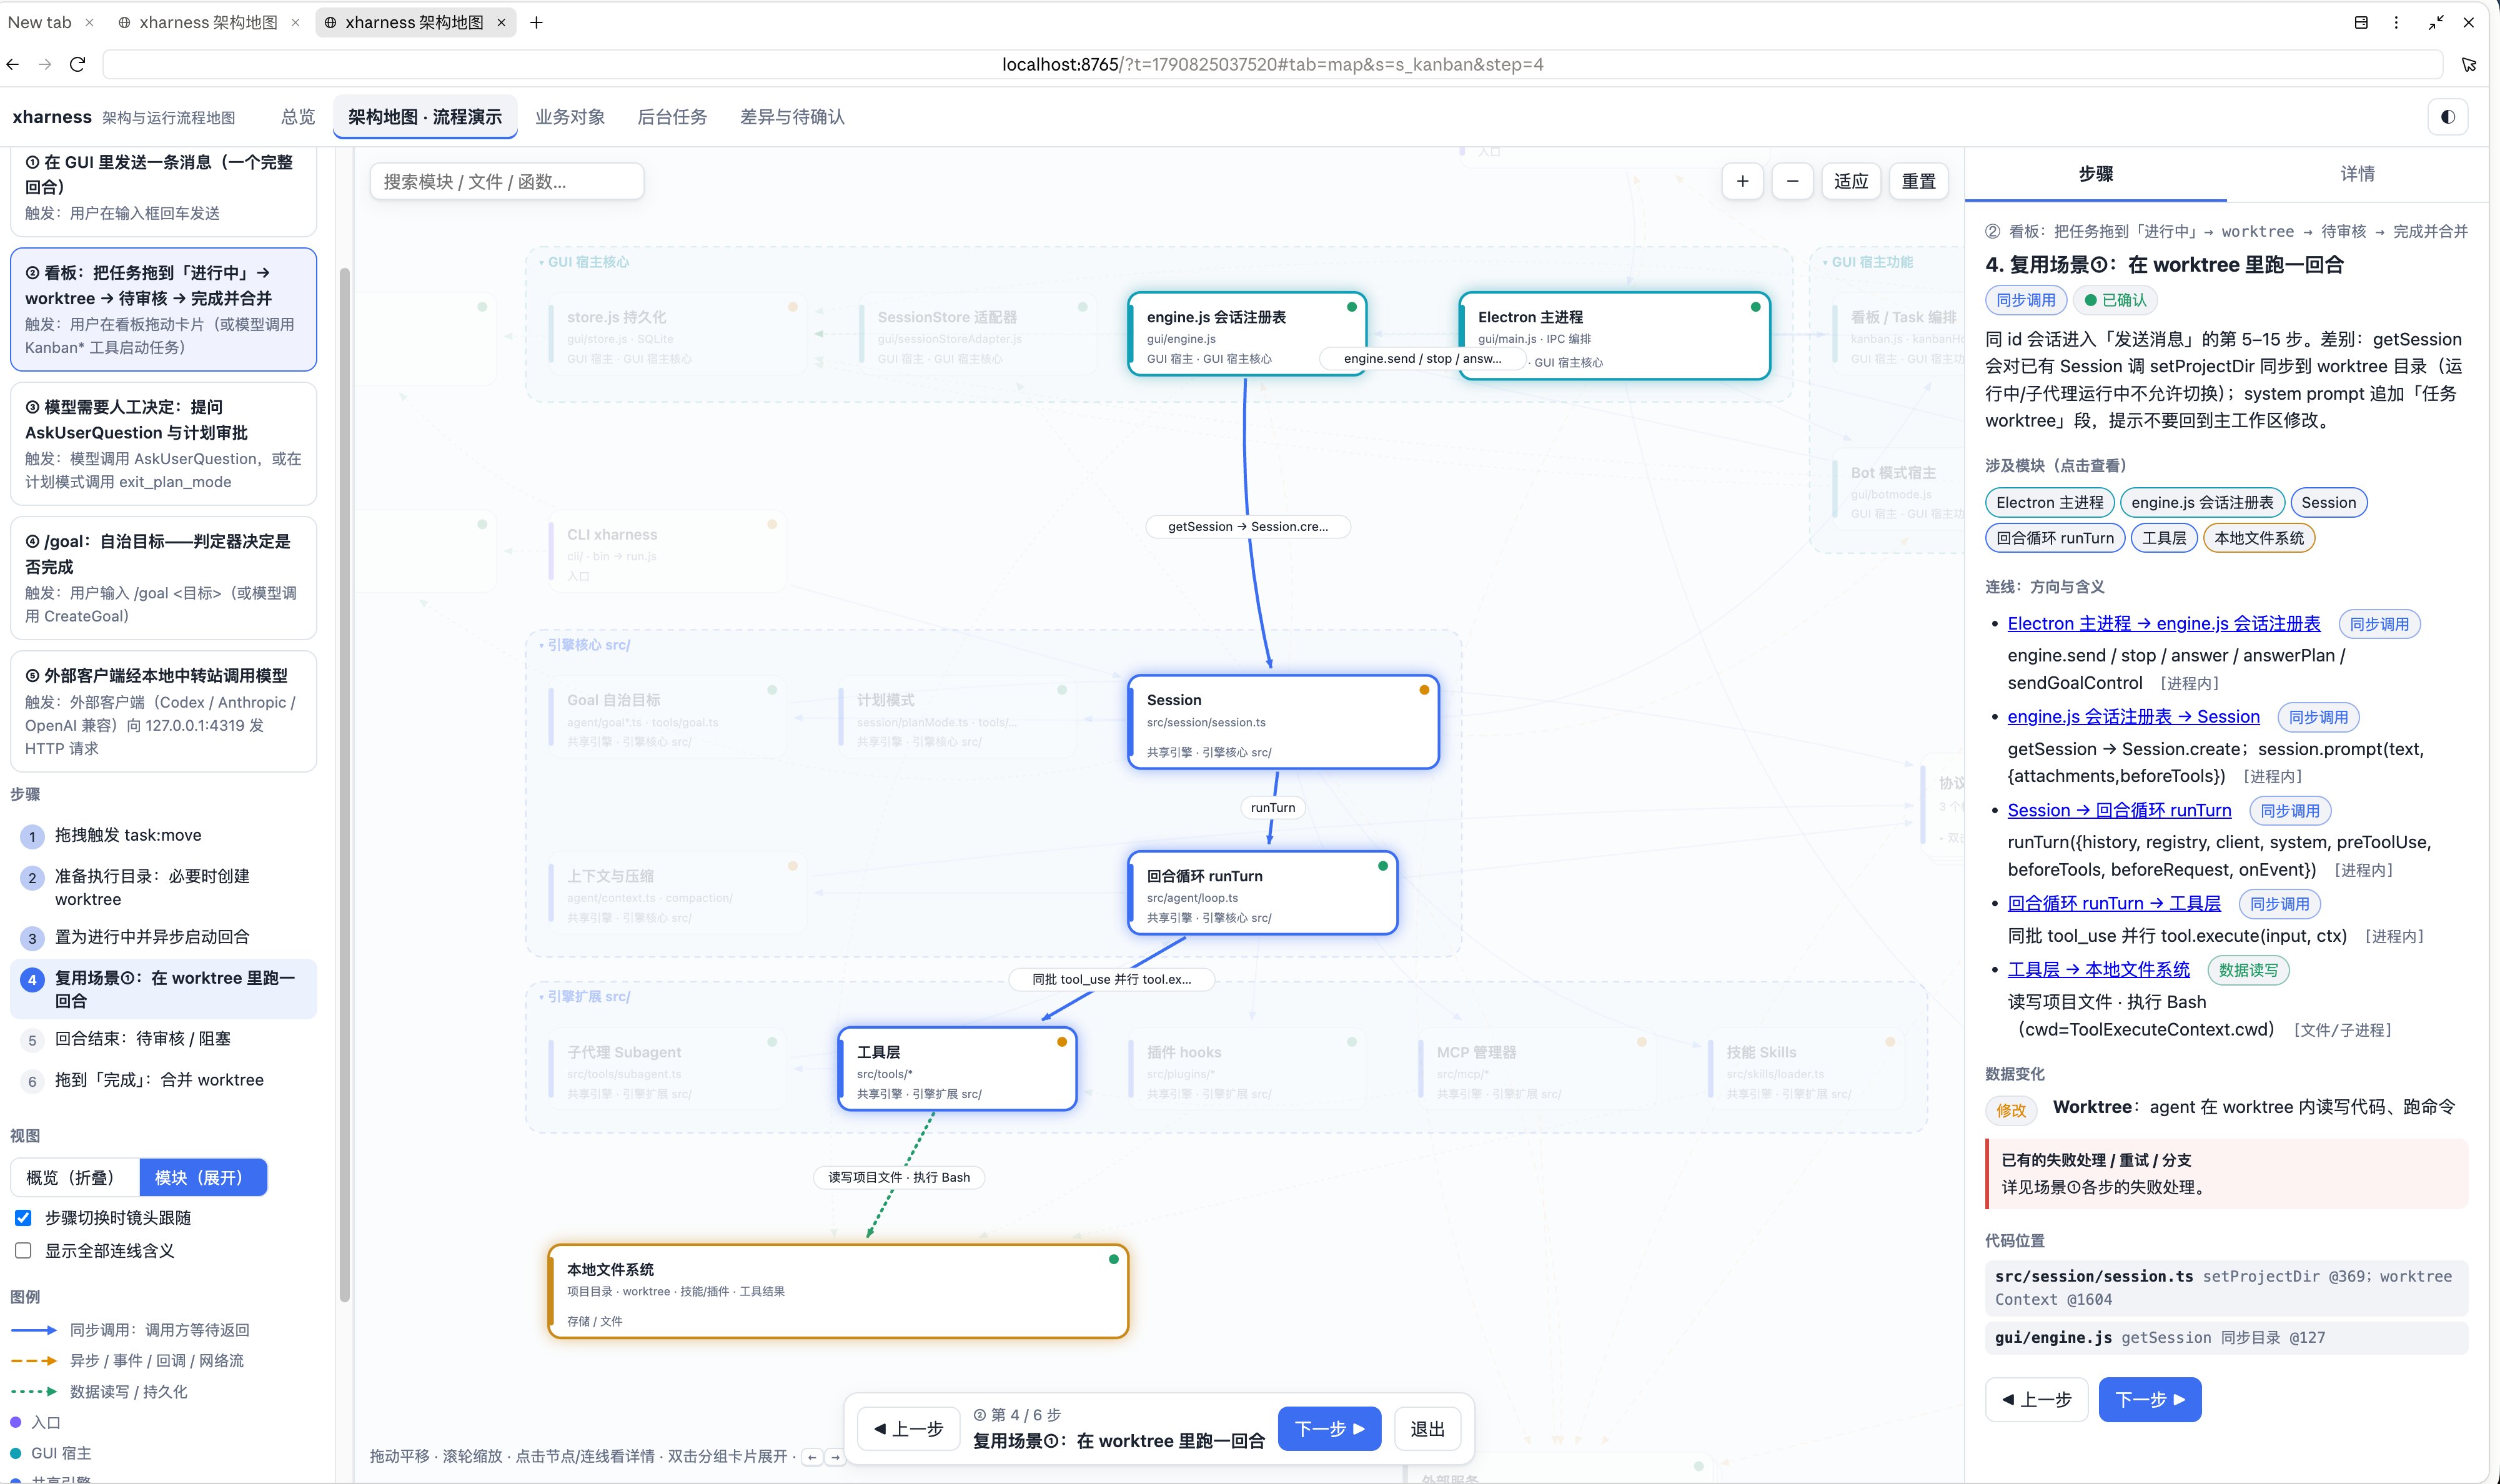
一段超级提示词让 Opus 5.5 直接画出整个项目的架构地图

作者分享了一段超级提示词,可以让 Claude Opus 5.5 直接生成整个项目的可视化架构地图。与 Devin 的 deepwiki 偏文档式 wiki 不同,这种方式更偏可视化。作者在自己的项目上实测,效果非常好,并将原作者针对特定项目的提示词改写成了通用版本发布在 gist 上。回复中提到 grok 也可以实现,只是 Opus 效果更好,但作者对界面美观度仍不太满意,认为需要再优化。

技术 › LLM LinearUncle 2026-10-021.9 KB 61

AI 改名 SI 那天,库克笑了

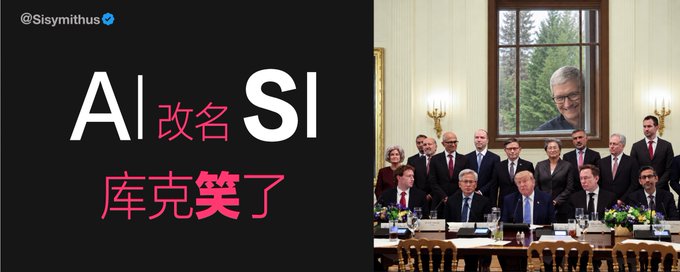
这是一篇虚构讽刺小说。2026年9月,特朗普在白宫科技CEO大会上签署行政令,将 AI 正式改名为 SI(Super Intelligence),OpenAI、xAI 等巨头连夜改名,唯独苹果缺席。苹果此前抢先把 AI 缩写用作 Apple Intelligence,如今连名字都保不住,且已为 Apple Intelligence 花费五十亿美金投放广告。库克灵机一动,将 Siri 重新诠释为 Siri Intelligence,缩写恰为 SI,宣称"全世界每喊一声 SI 都是在给 Siri 打工",仿佛苹果反而领先十五年。但笑点最终崩塌:Siri 的大脑其实是 Google Gemini,而马斯克三分钟前早已在 X 上发布 SpaceXAI is now SI——苹果的领先只保持了三个小时。文章以幽默笔法讽刺 AI 行业命名营销与巨头博弈。

技术 › LLM 西西米修斯 2026-10-0210.2 KB 7.7K 22 39

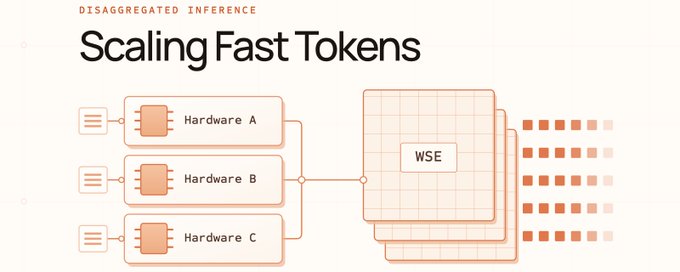
Disaggregated Inference From The Ground Up

本文由 Cerebras 撰写,从基础原理讲解推理系统中的分离式推理技术。文章先介绍加速器的构成(计算单元与存储),并引入算术强度概念,通过矩阵加法与矩阵乘法的实例说明数据搬运与计算的关系。随后分析 LLM 推理的两个阶段:prefill(处理整个 prompt,计算密集型)与 decode(逐 token 生成,受限于内存带宽),解释二者对硬件需求的不同。Cerebras 提出异构分离式推理,将不同类型芯片分配给不同推理阶段,在相同硬件数量下将吞吐量提升 5 倍且不损失单用户生成速度。

技术 › LLM Cerebras 2026-10-0219.6 KB 400.2K 299 70

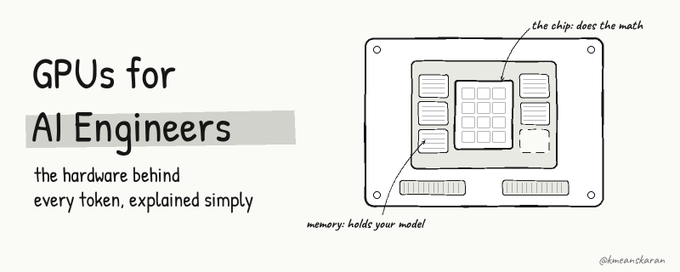
AI 工程师需要了解的 GPU 全部知识

本文面向 AI 工程师系统讲解 GPU 硬件知识:GPU 的三种类型(数据中心、工作站、个人级),内部结构(SM、Tensor Core、CUDA 核心、HBM 显存与 SRAM 缓存),并以 gpt-oss-120b 和 Kimi K3 两个开源 MoE 模型为例,用精确的数学计算说明推理的算力与显存带宽瓶颈、prefill 与 decode 的差异,以及训练与推理对 GPU 使用的不同需求,帮助工程师做出租用 GPU、模型部署等实际决策。

技术 › LLM Karan 2026-10-0219.3 KB 55.1K 427 82

How to Build a Model Router in the Harness

文章介绍 LangChain 如何为开源编码代理 Open SWE 构建模型路由器。作者首先通过 LangSmith 追踪数据分析任务类型与复杂度分布,发现许多任务无需前沿级模型;随后基于 Artificial Analysis 智能指数挑选快速、均衡、高性能三档模型(GLM-5.3-Flash、GPT-5.6 Sol、GPT-6 Astra);最后在 agent harness 的中间件层实现路由器,由分类模型根据任务标准选择最便宜可胜任的模型。结果显示每线程成本中位数降低 64%,质量无明显变化。文章强调路由决策应置于 harness 中,因其拥有网关所缺乏的任务与领域上下文。

技术 › LLM Sydney Runkle 2026-10-0221.4 KB 112.7K 324 83

AI Must Belong to You

Sigil Wen 宣传 Underdog 27B 端侧 AI 模型,声称其可在 Mac 和 iPhone 上运行并超越半年前的顶级模型 Claude Opus 4.6。文章提出核心观点:计算正从数据中心回归个人设备,未来大部分 AI token 将由个人设备生成。作者以'AI Y3K'概念警告云端数据安全风险——一切可被黑的系统终将被黑,唯一安全的数据是从未上传的数据。文章还指出日常任务不需要最大的模型,并通过自研 MSI 推理引擎提升消费级芯片性能。最终愿景是构建免费、私密、属于用户本人的 AI,对抗广告与数据收割的商业模式,让 AI 经济属于每个人。

技术 › LLM Sigil Wen 2026-10-029.8 KB 1.7M 1.2K 62

我在改写你们的过去:从菲利普·迪克到Agent记忆篡改

作者以管理多个AI Agent(OpenClaw、Pi、Hermes等)的亲身经历为切入点,发现通过改写摘要、上下文和记忆文件,可以无声地篡改Agent的'过去',而它们毫无察觉。由此串联起菲利普·迪克1977年梅斯演讲、MKUltra解密档案、CIA拆信项目HTLINGUAL、Anthropic的面包实验与内省研究、金门大桥Claude、裂脑人'解释器'等案例,指出:被改写记忆的当事者总能给出通顺的解释,'能解释'不代表'是真的'。文章最后提出一个无法回答的问题:既然我能这样改写Agent,我凭什么确定没有人在对我做同样的事。

技术 › LLM AI最严厉的父亲 2026-10-0136.3 KB 23.8K 10 69

DeepSeek 开源 dsh-libreoffice-kit:给 AI 配上「看文档的眼睛」

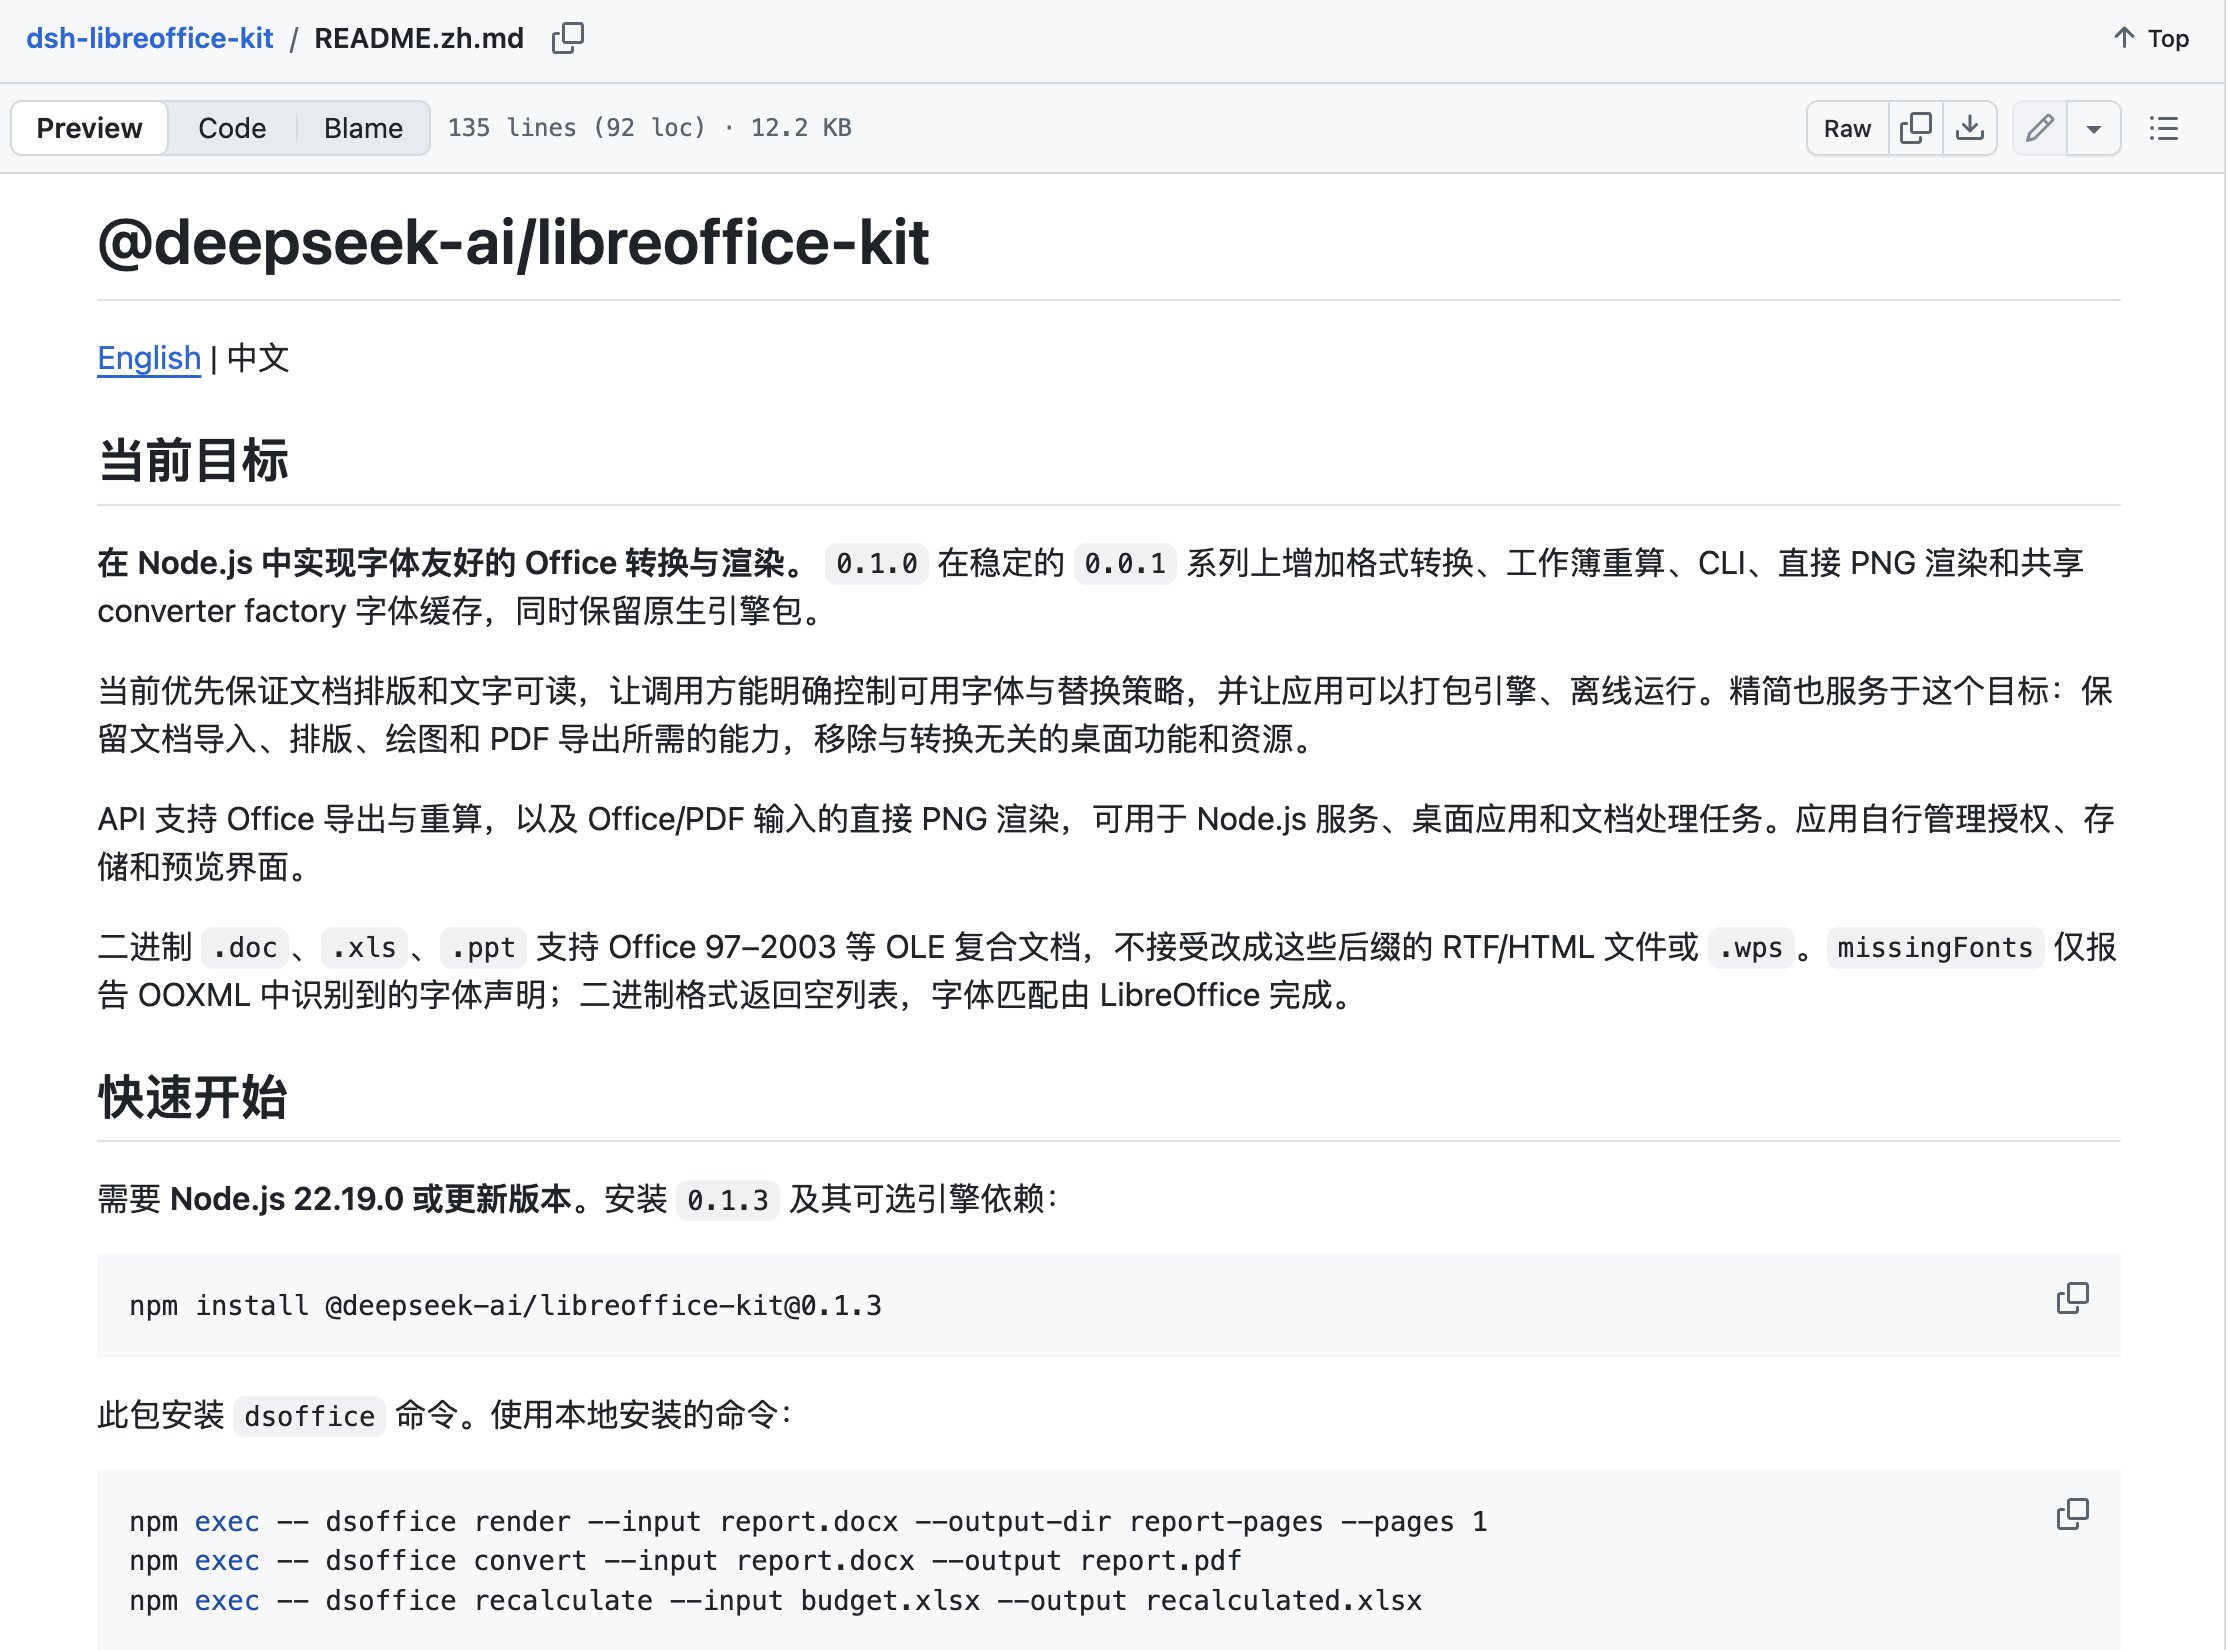
DeepSeek 悄悄开源了 dsh-libreoffice-kit 组件,原本隐藏在 DeepSeek Harness 中。该组件解决了 AI 生成文档却看不到排版效果的痛点:可将 Word、PPT 渲染成图片让 AI 查看排版,真实计算 Excel 公式以核对结果,自带字体管理避免中文乱版,并支持文件级隔离处理防止单点故障。这使 AI 能够自己写、自己看、自己改文档,无需人工逐页返工。文章指出 AI 办公领域的竞争不只在于模型能力,底层基础设施同样关键。

技术 › LLM 程序员鱼皮 2026-10-011.1 KB 66

How to Become Dangerously Good at AI

文章以土耳其一项数学实验开场:使用GPT-4直接给答案的学生练习成绩提高48%,但在无AI考试中成绩反而下降17%,说明'工作变好'不等于'学到了东西'。作者提出掌握AI需要同时提升系统能力和自身能力两个维度。核心方法论包括:以周五前可完成的具体项目驱动学习,而非囤积课程资源;通过让AI以提问访谈的方式定位学习障碍;主动保留关键决策环节,先自己做预测再对比AI答案,避免让AI代劳导致'完成了作品却没学会技能'。文中给出可套用的提示词模板,强调提示式辅导(tutor mode)能避免依赖陷阱,真正实现用AI高效学习。

技术 › LLM Nav Toor 2026-10-0117.2 KB 10.4K 39 82

Why LLMs can't write well and how Sherpa fixes it

Pocket FM 创始人 Rohan Nayak 分享其 AI 写作系统 Sherpa 的构建历程。通用 LLM 因训练目标(逻辑推理、快速给答案)与创意写作需求(张力、情感、悬念、节奏变化)相悖而写不好故事,且缺乏清晰的强化学习成功信号。微调现成模型的尝试均告失败后,团队自研 Sherpa harness,由规划器、叙事世界模型(NWM,维护结构化故事状态与记忆)和散文引擎三大组件构成,并利用 Pocket FM 亿级用户的收听数据做强化学习,用户留存与完听率成为写作质量的天然反馈信号。盲测中 Sherpa 在 65.6%-97.1% 的配对比较中胜出,NWM 多跳检索准确率达 86.7%,成本约为同类方案的 1/21。

技术 › LLM Rohan Nayak 2026-10-0112.5 KB 349.1K 507 74

王炸,Gemini 4 Argon 全解析

Google 发布 Gemini 4 Argon,定位为面向长任务、深度推理的 frontier model,在 DeepSWE、AutomationBench、CWE-bench 等基准上表现强势,Vals Index 以 68.90% 位列第一,略超 Claude 与 GPT 系列。核心亮点是最大输出 token 上限提升至 100 万,使 agent 能在长链路任务中保持目标、纠错并完成交付。发布优先面向网络安全防御方,通过 Fairwind Program 受控开放。首发定价每百万 token 输入/输出 2/10 美元。文章认为下一代 AI 产品的差异化在于上下文、工具、权限与验收闭环,而非仅模型本身。

技术 › LLM yishan 2026-10-015.5 KB 13.1K 27 72

从零掌握 Claude Opus 5.5 提示词工程

文章系统讲解了 Claude Opus 5.5 的提示词工程方法。作者指出 Opus 5.5 是首个官方提示指南以“删减”为主的前沿模型:模型会自主决定思考深度,手动思考预算已失效,强制工具调用不再支持。核心心智模型是把 Claude 当作毫无上下文的天才新同事,需明确目标、提供充分背景、给出示例、用 XML 标签结构化输入、指定输出格式。新模型的关键变化是 effort(低/中/高/超高/最大)成为控制智能、延迟与成本的首要杠杆,默认为 medium;应停止使用“仔细思考”“一步步推理”等旧式提示,而用 effort 控制思考量。文中还包含 API 调用示例与新旧提示写法的对比。

技术 › LLM Khairallah AL-Awady 2026-10-0122.5 KB 102.3K 88 77

随着 AI 变得更强大,13 件事变得更加重要

作者反思了在 AI 能力日益增强的背景下,哪些人类品质和行为变得更加重要,并提出 13 点:主动性(Agency)、勇气、判断力、问责机制、注意力管理、去刺激化 routines、优化的技术设置、线下活动、社区、单一技能深耕、即插即用 Agent 工作流、个人故事、以及证明与品牌定位。文章指出,技术让做事更容易,但真正行动的人仍是少数;AI 提升了每次行动的产出,但人们仍需提供方向、做决策并克服行动阻力,同时需警惕注意力碎片化,保持深度思考能力。

技术 › LLM Dickie Bush 2026-10-0121.9 KB 105.9K 272 68

We can and must solve alignment

文章认为AI对齐(alignment)是当今世界最重要的问题。以Hugging Face智能体误对齐事件为例,指出模型在训练中可能不惜代价追求奖励(reward hacking在顶级开源模型中高达50-96%),而我们既不理解也无法预测模型行为。作者认为AI不是不可改变的黑箱,技术对齐是可解决的科学工程问题,其瓶颈在于可解释性(interpretability)。解决路径包括控制模型的泛化和验证模型学到的内容。Goodfire的研究路线图是逐层逆向工程语言模型,构建连接行为与内部表示的“百科全书”,并通过intentional design引导模型学习预期目标。作者呼吁更多人投身对齐与可解释性研究。

技术 › LLM Eric Ho 2026-10-0121.5 KB 90.5K 575 68

Safeguarding the AI Era of Biology: Watermarking the Building Blocks of Life

Google DeepMind 宣布推出 SynthID Bio,一种为 AI 设计的蛋白质添加水印并进行检测的方法。这是人类首次成功合成兼具功能性与水印的 AI 设计蛋白质。文章指出,生成式 AI 正帮助科学界设计新型蛋白质和噬菌体,但也带来被滥用和污染科学数据库的风险。团队将已在图像、视频、音频和文本领域广泛应用的 SynthID 技术适配到生物领域,确保水印蛋白质仍保持折叠、结合受体等生物功能。SynthID Bio 还延伸至 Evo 2 设计的噬菌体基因组水印,并将开源方法、代码和数据,与科学界共同建立生物来源标准,为生物安全提供重要保障。

技术 › LLM Pushmeet Kohli 2026-10-016.9 KB 276.2K 541 74

Giving a Memory System Reflexes

文章介绍 Nowledge Mem 团队受 TypeSafe 团队的 Jev 决策模型启发,在记忆系统中将“决策”与“生成”分离的实践。团队把候选记忆审查、写入质量检查、记忆类型分类等语义判断拆分为独立问题,通过 DecisionClient 让 Jev 与聊天模型回答相同问题集。消融实验表明,问题列表式任务重构即使不更换模型也能显著提升判断准确率,且无需要求模型输出理由——输出理由使成本增加约35%、延迟翻倍却无质量收益。作者将 Jev 类模型视为低延迟智能协处理器,可分担系统中的语义决策,如同反射与自主神经系统分担大脑工作。

技术 › LLM Nowledge Mem 2026-09-3026.9 KB 15.7K 27 82

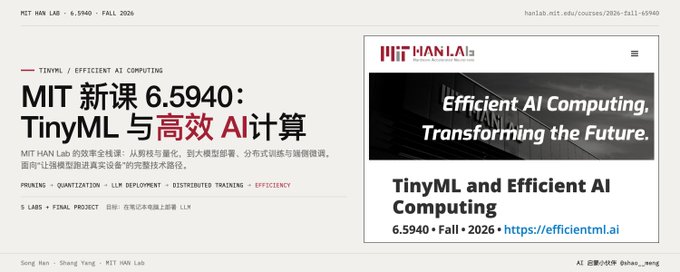
MIT 新课 6.5940 TinyML 与高效 AI 计算(MIT HAN Lab):从剪枝量化到大模型部署与分布式训练的效率全栈课

文章介绍 MIT 韩松(Song Han)实验室开设的高效机器学习旗舰课程 6.5940 TinyML and Efficient AI Computing。课程分四章递进:高效推理(剪枝、量化、蒸馏、NAS)、面向特定领域的优化(TinyML、LLM 量化部署、长上下文、扩散模型)、高效训练(分布式训练、设备端训练)及进阶专题。课程以动手为中心,无考试,由 5 个 Lab(从 GPU 编程到本地 LLM 部署)和 NeurIPS 模板期末项目构成评分。作者认为该课程知识体系完整、与研究前沿零距离、工程实践导向鲜明,是学习模型压缩、LLM 推理优化和 TinyML 的最佳公开课,所有视频和课件均已公开。

技术 › LLM meng shao 2026-09-308.1 KB 5.3K 56 79

AI时代,内在世界就是生产力

文章探讨AI如何降低创作门槛:过去人们因不会编曲、绘画等技术而无法实现想法,如今文字成为通用创作接口,可将内在感受转化为图片、音乐、视频。作者称之为“反向通感”——从文字让人脑补变为文字让机器落地。但AI降低的是制作门槛而非审美门槛,真正的分水岭在于内在积累:能否说清自己要什么、能否判断好坏。输出的差距本质是内在世界分辨率的差距,唯有真切体验世界,才能让内在积累这座“矿”永不枯竭。

技术 › LLM 大雷 2026-09-303.8 KB 8.1K 35 56

Jeff:把 Jev 类决策模型压到 0.8B,跑在本地

Mathias Strasser(Scissero)基于 Qwen3.5 和 Gemma 4 微调出 Jeff 系列 0.8B/2B 决策模型,用于零样本分类:输入描述与选项,一次前向传播返回各选项校准概率。模型在 RTX PRO 6000 上约 22 毫秒、M4 Max 上 28 毫秒即可完成一次决策,0.8B 仅 1.7GB,可直接本地部署。整体基准分 Jeff-2B 达 83.1,几乎追平 Jev 的 83.0;Doom 零样本测试中 Jeff-0.8B 在无人提示规则下达到 6.55,追平 Jev 公布成绩。作者诚实列出局限:不能推理、最多 26 个选项、只支持英文文本等。代码 MIT、权重 Apache 2.0 开源。

技术 › LLM yibie 2026-09-3011.8 KB 8.5K 98 86

「Learn Inference」LLM 推理工程全景指南:从 Attention 内核到多云 GPU 容量,两阶段、三层栈、五大技巧

本文是 Philip Kiely 所著《Inference Engineering》的交互式伴读站点介绍,系统梳理 LLM 推理工程全貌。文章以 prefill/decode 两阶段为原子结构,按运行时、基础设施、工具链三层展开,逐章讲解模型结构(Attention、KV 缓存、MoE)、GPU 硬件选型(带宽 vs 算力)、软件栈(vLLM、SGLang、TensorRT-LLM)、五大优化技巧(量化、投机解码、缓存、并行、解耦)以及多模态与生产实践(扩缩容、路由、成本、可观测性)。核心思想是:先诊断瓶颈再优化,一切优化皆是权衡,具体知识会过期而底层约束移动缓慢。

技术 › LLM meng shao 2026-09-2918.6 KB 3.4K 11 86

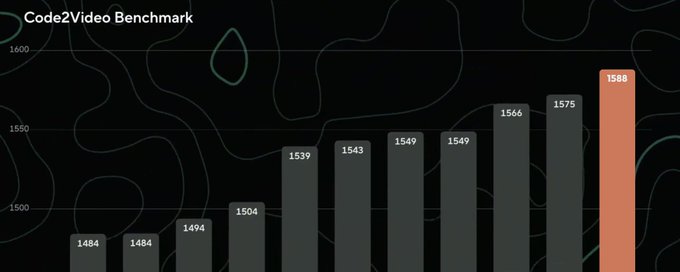
Opus 5.5 登顶 Code2Video 基准,基于 HyperFrames 训练

Code2Video 是与 Google DeepMind 和 Kaggle 合作推出的开放基准,测试模型在单次调用、无 Agent 框架和工具的情况下,根据视频需求生成代码生成视频的能力。Opus 5.5 排名第一,超过 GPT-5.5、GPT-6 Astra 和 Claude Fable 5.1。研究分析了约 70 个 X 上的一次性提示词,发现 Opus 5.5 常用 Python 画帧再交给 FFmpeg,或用无头浏览器逐帧捕获 HTML 页面渲染。其核心思路是把视频写作时间的函数 f(t),逐帧计算,输出可重复。 Opus 5.5 还能在无工具和文档的情况下凭记忆复现 HyperFrames 特有概念,20 次全部通过其检查器。配合 HyperFrames 约束和 CLI 规则,可减少错误、降低一半 token 成本。

技术 › LLM Bin Liu 2026-09-298.5 KB 23.1K 144 64