Wiki 知识库

技术 / LLM

1279 篇
清除

DGX Spark Handbook

本文是 NVIDIA DGX Spark 本地推理设备的使用手册。作者最初因其 273 GB/s 的低内存带宽而不看好,但随着 MoE 架构、推测解码等推理工程技术的成熟,DGX Spark 已能在本地以接近云服务的速度运行高智能模型。文章详细介绍了多台 Spark 通过 ConnectX-7 网卡链接实现近线性扩展带宽和内存的方案(四台可达 1092 GB/s、512 GB 内存)、低功耗适合家用部署的优势、MoE 与推测解码如何弥补硬件短板,以及单机同时服务 8 个并发会话的能力,并对比了与 Mac 的算力优势和成本分析。

技术 › LLM EXO Labs 2026-09-2651.7 KB 256.4K 703 75

这应该是我写过最全的 Opus 5.5 提示词工程讲解了

本文基于 Anthropic 官方指南,系统讲解 Opus 5.5 的提示词工程方法。内容涵盖如何清晰描述问题、提供相关上下文(报错、文件、触发步骤)、说明任务范围与原因;详细介绍 effort 五个档位(low 到 max)的选择策略及在 Claude Code 和 API 中的设置方式;强调改完代码后要求 AI 给出具体检查结果、区分已完成与未完成事项;讲解如何防范围外部文档中的间接提示注入,以及看图任务中提供清晰截图的技巧,面向已使用但不熟悉提示词设置的用户。
技术 › LLM Feicai 2026-09-2632.7 KB 2.5K 5 90

Joy & Curiosity #101:Agent 时代的编程语言与框架思考

Thorsten Ball 分享了他对 AI Agent 时代编程语言与框架未来的思考。他认为手写代码时代正在终结,框架不再是最大的生产力杠杆,语法和工具易用性变得不再重要,但共享抽象仍有价值。未来重要的是性能、可观测性、可调试性等对 Agent 透明的特性。语言偏好将从'我喜欢'转向'我的 Agent 能用好'。他还探讨了生态系统的变化、测试框架的命运、静态类型的未来等话题,认为 token 成本下降是最强的技术驱动力。

技术 › LLM Thorsten Ball 2026-09-2619.3 KB 9K 98 70

本地无 GPU 微调实战:基于 HUD 与 Fireworks 训练 API 的 LoRA 强化学习指南

本文解读 Fireworks AI 官方 Training API Cookbook 中一篇实战教程,讲解如何结合 HUD 框架与 Fireworks Serverless Training API,在无本地 GPU 条件下用 GRPO 风格强化学习微调 LoRA 适配器。文章详细拆解了四步工作流程:环境配置、任务校准、单步训练和长跑训练,重点阐释了快照隔离、trace 记录、loss masking、组内优势归一化等核心训练机制。实验结果显示四位数乘法任务准确率从 78.1% 提升至 98.4%,但作者指出收益主要来自输出格式和自我节制的优化,而非深层算术能力的提升。文章还提醒了 checkpoint 语义区分等实操要点,并对教程的严谨设计给予高度评价。

技术 › LLM meng shao 2026-09-2610.7 KB 4.7K 36 86

2026 年最全免费 AI 资源盘点

作者花费 20 天实测了各类免费或近免费的 AI 模型获取渠道,包括免费 API、促销额度、创始人和学生计划、开源维护者资助等。文章指出多数“免费 AI”汇总信息过时且不准确,并从三个维度评估:永久配额与限时额度的区别、实验用途与生产用途的区别、以及隐藏的数据隐私代价。详细分析了 Google AI Studio、Groq、Cerebras、Mistral、Cloudflare Workers AI、OpenRouter、Cohere、OpenAI 等平台的免费额度与限制,还涵盖初创企业资助、学生福利、开源维护者计划以及地理限制,最后强调本地部署模型是唯一不可撤销的保底方案。

技术 › LLM Innopro 2026-09-2610.8 KB 381.6K 156 85

读张拳石《致 AI 圈的每一根韭菜》有感

作者分享张拳石老师《致 AI 圈的每一根韭菜》一文的读后感。文章指出一些本科生虽有3-5篇顶会论文,却答不上大模型生成token概率、交叉熵等基础问题,因为文献调研、代码、写作等环节都可由大模型代劳。论文越来越容易生产,数量加速贬值,真正难替代的是底层理解、问题判断与研究动机。作者结合读博经历感慨:读博需五六年,而AI研究范式一年数变,追热点风险极高。文章适合做AI研究和准备读博的人阅读,促使思考:当写论文变容易后,如何判断研究者真正的能力。

技术 › LLM Xudong Han 2026-09-261.5 KB 51

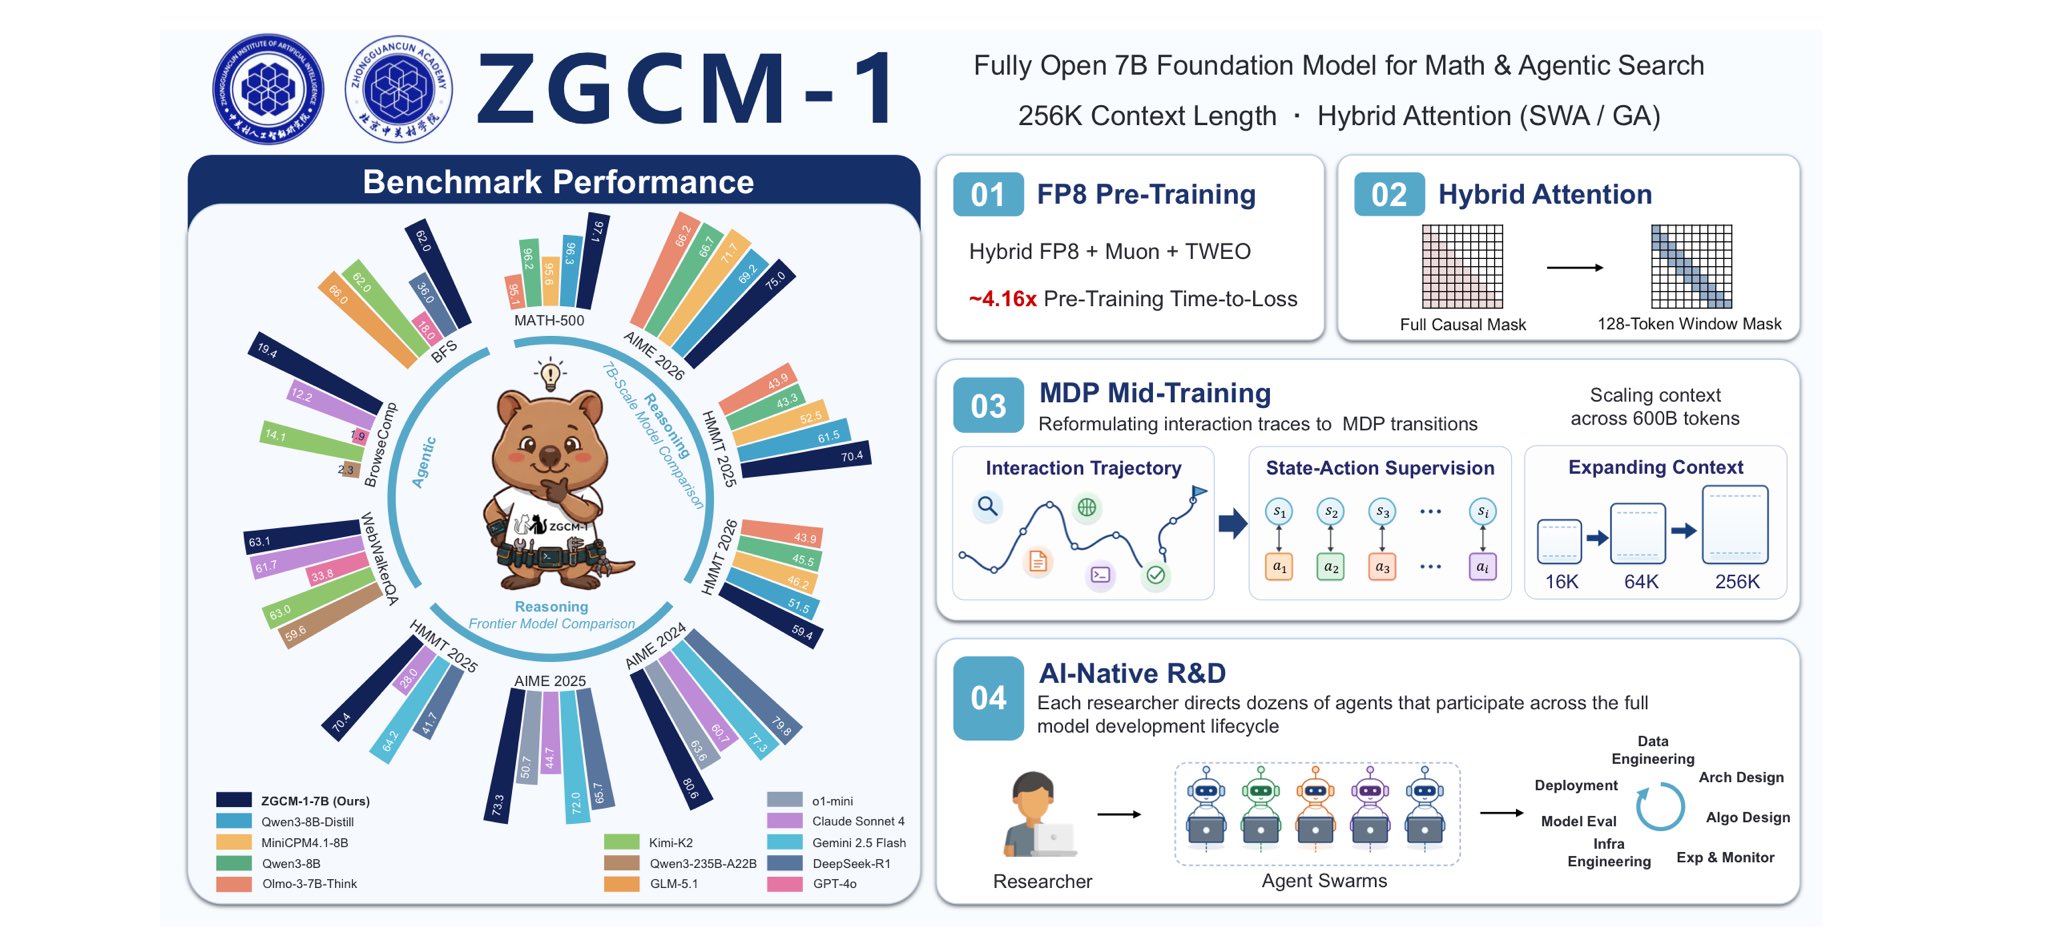
中关村学院 3 个月从零训练 7B SOTA 模型的启示

作者评述中关村学院何纪言老师带领 7 位博士生用 3 个月从预训练、中训练到后训练完全自主训练出 7B 模型并达到 SOTA 水平。文章提出三点观察:一是当前模型能力远未到全自主程度,在架构设计、算法设计等方面仅达 L2 辅助水平;二是模型训练会者不难,MiMo V2.6 RL 仅花 300 多万美金即达高水平,说明关键是人才而非算力堆砌;三是数据是新的代码,数据质量如同代码质量一样重要,该模型在数据清洗、课程学习、上下文扩增和 RL 优化上做了深入工作。

技术 › LLM Bojie Li (@bojie_li) 2026-09-262.6 KB 63

从零手写大模型系列完结了

作者宣布「从零手写大模型」系列完结,共20篇,包括推理篇15篇和训练篇5篇。推理篇涵盖分词器、嵌入层、位置编码、自注意力机制、多头注意力、残差连接、层归一化、Transformer模块等内容;训练篇涵盖损失函数、反向传播、梯度下降、Adam优化器和学习率调度。每篇都有可练习的代码示例,帮助读者理解模型如何生成文字以及如何从误差中学习更新参数。作者强调理论公式是精华,代码多被PyTorch封装。系列笔记已发布在个人网站上,欢迎交流指正。

技术 › LLM 纳米AI (@antiAIvo) 2026-09-262.6 KB 65

Coding is dead, long live Coding

作者以个人编程经历为引,回应对 AI 导致编程手艺消亡的哀悼。引用 Thorsten Ball 的观点:手写代码的工艺将像意大利手工鞋匠一样成为小众。作者认为编程虽'死',却以模型权重、框架和语言的形式延续。作为自学成才的程序员,他乐观地认为 AI 编程是新的开始——新一代程序员用自然语言表达意图,能更快、更高质量地构建产品。过去受限于个人能力,如今可以通过正确的提示词和上下文驱动 Agent 实现心中构想。作者对更多人体验创造的乐趣充满期待。

技术 › LLM lauren 2026-09-263.9 KB 174.2K 2.6K 45

为什么 AI 繁荣但生产力却没有提升

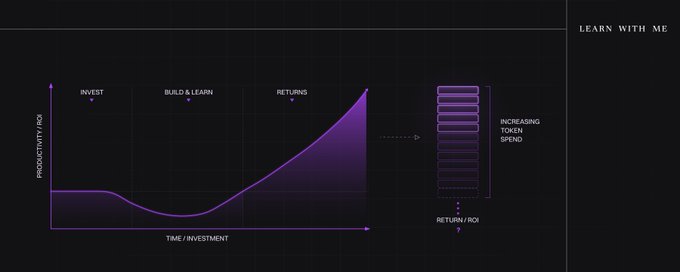
Chamath 探讨了 AI 投资回报率(ROI)难以在生产力数据中体现的原因。AI 成本极低——企业中位数每月每位员工仅花费 12.50 美元,只需提升约 0.15% 的效率即可回本。但价值端难以衡量:企业员工大部分时间花在协调、会议和流程审批上,而非产出工作,人成为 AI ROI 的瓶颈。2026 年一项 515 家初创公司的实验显示,几乎所有收益都来自最顶尖的 10% 企业——关键在于围绕 AI 重组工作流程,而非工具本身。作者引用 Solow 的生产力悖论和 Musk 的五步自动化流程,指出企业应先简化流程再自动化,生产力提升将取决于大企业采纳的速度。

技术 › LLM Chamath Palihapitiya 2026-09-265.1 KB 812.4K 2.2K 78

AI 眼里根本没有猫,那它到底是怎么认出猫的?|从 0 开始理解大模型底层

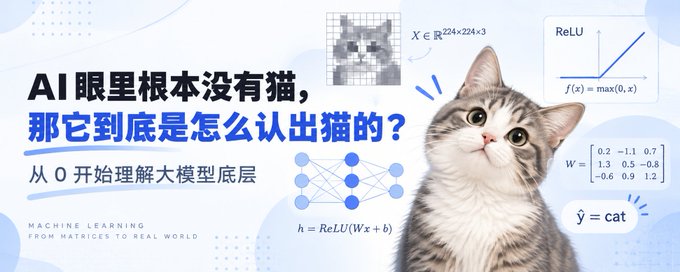
本文从最简单的线性模型 y=wx+b 出发,逐步拆解神经网络识别图片的原理。作者解释了为何单层线性计算表达能力不足,堆叠多层也仍会退化为一次线性变换,因此需要 ReLU 等激活函数引入非线性。随后说明图像如何从原始像素经多层计算被加工成适合任务的内部表示,并澄清了'第一层看线条、第二层看耳朵'的常见误解。文章还介绍了万能逼近定理的含义与局限、CNN 与 Transformer 的关系,以及模型为何是黑箱与机制可解释性,最后引出过拟合问题,为下一篇泛化主题做铺垫。

技术 › LLM joy 2026-09-2614.8 KB 6.5K 18 63

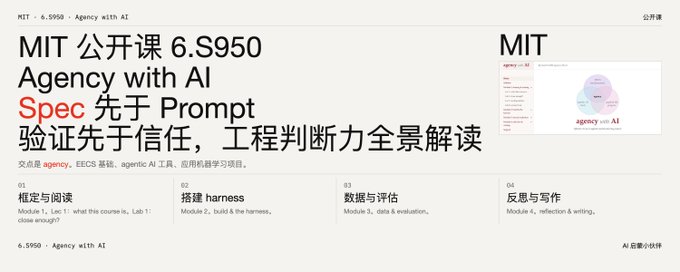
MIT 公开课 6.S950 Agency with AI:Spec 先于 Prompt,验证先于信任

文章全景解读 MIT EECS 2026 秋季新课程 6.S950《Agency with AI》。课程不教工具使用,而教 AI 时代的工程判断力:什么该委托给 AI、什么该验证、什么该留给自己。方法论核心是四问法(解决什么问题/方案/老思想/新在哪)与增量思维。12 讲沿真实 ML 项目生命周期展开,涵盖文献阅读、spec 驱动开发、版本控制、抽象阶梯、数据审查、LLM 机制、评测设计与审计等主题。Lab 设计精妙地控制 AI 在场与否,考核要求任何无法说明理由的工作不得分,强调决策的可辩护性与人类作者性的保留。

技术 › LLM meng shao 2026-09-2616.8 KB 17.9K 115 80

Alexandr Wang:从数据标注到执掌 Meta 超级智能实验室

文章讲述 29 岁的 Alexandr Wang 的创业历程:他从 MIT 退学后创办 Scale AI,选择当时被轻视的数据标注业务,为 OpenAI、Google、Meta 等巨头提供训练数据、RLHF 和红队测试服务,成为 AI 行业绕不开的基础设施。2025 年扎克伯格以约 290 亿美元估值收购 Scale 49% 股权,并邀请他执掌 Meta Superintelligence Labs。作者认为,小扎买下的不只是一家公司,而是一个看遍顶尖模型训练底牌八年的人。文章借其经历说明:技术人真正的胜负手在于焊死别人不愿做的底层管道。

技术 › LLM AYi (@AYi_AInotes) 2026-09-253.9 KB 61

Project Suncatcher:谷歌将AI算力送入太空的登月计划

谷歌宣布其长期研究项目Project Suncatcher即将进行首次轨道测试,通过SpaceX的Transporter-18任务发射一颗原型卫星,验证TPU芯片在太空环境中的表现。文章介绍了三大工程挑战:一是硬件生存能力,卫星需承受发射时的剧烈震动和高达10倍重力加速度的载荷,TPU还须抵御太空辐射,测试显示Trillium TPU可承受超过五年太空任务的辐射总电离剂量;二是散热问题,太空真空环境无空气对流,团队开发了热管加辐射器的冷却方案;三是卫星互联,未来卫星集群需通过高带宽激光通信保持连接。2027年计划发射两颗卫星进一步测试。

技术 › LLM Google 2026-09-256.9 KB 360.7K 2.8K 64

BestBlogs 早报 · 09-25|Every 分享如何筛选 AI 产品创意,Elastic 原子声明验证,AI时代人际反馈不可替代

本期早报精讲三篇文章:一是 Every CEO Dan Shipper 介绍在 AI 快速演进中如何用小型实验室机制筛选产品创意,通过内部采用、早期客户测试等管线判断原型价值,其 AI 编辑助手已减少 12% 编辑工作量;二是 Elastic 分享用原子声明验证减少 LLM 幻觉的方法,将知识库文章合并拆解为可逐项核对的声明,把合并时间从一小时缩短到五分钟;三是 Thoughtworks 作者探讨健康的同行反馈机制,强调人类反馈不可被 AI 替代。速览部分涵盖 AI 代码现代化、机器人仿真资产、京东 AI 知识库、视觉模型 Skills 封装和 TPU 大模型训练复现等内容。

技术 › LLM ginobefun 2026-09-2526.6 KB 4K 1 84

Anthropic 成立生命科学团队,Claude 自主发现类 CRISPR 新酶系统 ART

Anthropic 成立新的生命科学团队和实验室,尝试用 AI 辅助基础生物学研究。约 950 个 Claude 智能体在 21 小时内分析了超过 20 万个 DNA 样本,自主发现了一套名为 ART 的全新酶系统,其结构类似基因编辑工具 CRISPR,包含逆转录酶、未知辅助蛋白和重复 DNA 序列。虽然 ART 的具体功能尚不清楚,但初步测试显示其重复序列会表达成多种短 RNA 分子,工作机制可能与 CRISPR 类似。CRISPR 领域先驱张锋对此表示认可,认为这是 AI 参与生物学发现的重要案例。

技术 › LLM Gorden Sun 2026-09-242.4 KB 58

斯坦福大学 CS336 公开课「从零构建语言模型」:18 讲完整视频 · 作业开源 · 零成本自学

本文介绍斯坦福大学 2026 春季研究生课程 CS336「从零构建语言模型」。该课程由 Hashimoto 和 Liang 教授讲授,工程量极大,学生需亲手实现 tokenizer、模型、FlashAttention2 内核及分布式训练。内容覆盖 LLM 全生命周期:模型架构、系统优化(GPU/内核/并行)、Scaling Laws、数据处理、推理评估及后训练对齐(含 RLVR)。五次编程作业串起从原始数据到可对话模型的完整生产流程。目前 18 讲视频与作业已全部公开,是自学者系统补齐 LLM 工程能力的稀缺资源,但要求扎实的 PyTorch 与体系结构基础。

技术 › LLM meng shao 2026-09-247.2 KB 15.5K 194 81

锐评一下 Jev 和狂躁的 AI 圈

作者对近期爆火的 Jev 模型进行冷静剖析。通过分析 JevPilot 自动驾驶、通关《宝可梦·红》、大战《毁灭战士》等热门项目源码,指出其炫酷演示背后主要依赖传统算法和剪辑包装,Jev 真正参与决策极少。Jev 本质是低延迟、低成本的判别分类架构,只能做单步选择,缺乏长程推演能力。作者认为与其让大模型生成选项再由 Jev 裁决这种毫无意义的使用方式,不如将其用于任务前置过滤分流等真正能降本增效的场景,呼吁 AI 圈少些浮躁炒作,多沉下心寻找实际应用价值。

技术 › LLM 林亦LYi 2026-09-246.3 KB 9.1K 50 75

如何用 AI 写出有活人感的文章?【手把手教你祛除AI味】

作者分享用 AI 写作时降低 AI 味、提升活人感的实操经验。认为 AI 写作不可能完全消除 AI 味,只能压到可接受程度。方法分四步:一是选择中文语感好的模型(首选 Claude,其次 Gemini,国内推荐豆包、DeepSeek);二是准备风格档案和写作禁令,只聚焦句子和用词表达层,避免过多要求设定,并用示例语料校准风格;三是用语音输出想法,让内容更符合自然语言习惯;四是让 AI 反问以收集个人案例。最后建议手动修改细节、重写开头,允许适当冗余以增加真实感。

技术 › LLM xilo 2026-09-2415.1 KB 85.9K 300 78

把 Jev 插进 RAG:爆速与降本到底能不能实现,实测验证

本文实测了 TypeSafe AI 发布的不生成文本的 AI 模型 Jev 在 RAG 检索流程中的效果。作者在重排、回答判断、检索前置门卫三个环节插入 Jev 进行验证:重排方面,Jev 以八分之一的成本达到接近 Cohere Rerank 的精度;在调用 LLM 之前用 Jev 判断「无法回答」,响应速度提升 5.6 倍,成本降至二十七分之一;在检索之前拦掉范围外提问,速度提升 7.4 倍,成本降至七十五分之一。此外,Jev 还能一次请求同时完成重排和回答判断。结论是用 Jev 改善 RAG 速度与成本可行,但需慎重设定阈值,避免误拦可回答问题。

技术 › LLM yibie 2026-09-2416.7 KB 10.8K 85 85

企业的缓慢死亡:AI 时代传统组织的渐进式衰退

文章论述企业不会在瞬间被 AI 击败,而是逐季度缓慢落后。作者引用 PwC 和 McKinsey 调查数据指出,尽管员工普遍使用 AI 工具,但大多数企业未获得显著财务回报。类比电力时代工厂保留蒸汽机传动轴的教训,说明仅购买 AI 许可证而不重构工作流程无法释放价值。结合 Microsoft 及医疗授权平台等案例,作者强调必须围绕 AI 重新设计工作流。文末提出企业落后于 AI 的七个阶段,警示渐进式衰退的风险。

技术 › LLM Mark Ajzenstadt 2026-09-2418.0 KB 144.8K 247 77

闲鱼上的ChatGPT代充暗号,已经进化到我看不懂的程度了

作者探访闲鱼上的ChatGPT代充黑市,发现卖家为绕开平台禁令创造了各种隐晦暗号,如'奥特曼充电''鸡屁踢''Tibo洗衣粉'等,且暗号随平台封禁快速轮动演化。文章记录了代充交易的完整流程,包括加微信、提供会话凭证等存在安全风险的步骤。作者将这一现象类比为电影《我不是药神》:平台依法禁令、用户只是想用上好AI、卖家赚取辛苦钱,各方都有难处却形成奇怪困局。最后作者呼吁国产大模型崛起,让好技术成为像电力一样的基础设施,消灭摩擦,让这些荒诞暗号失去存在意义。

技术 › LLM 数字生命卡兹克 2026-09-249.4 KB 32.2K 75 63

AI 时代职场人现在最该学的一项技能是什么

宝玉分享吴恩达的观点:AI 时代人人都应该学编程。与一些企业高管认为 AI 会自动化编程、不值得学的观点相反,吴恩达认为正因为 AI 辅助让编程变得前所未有地容易,才更值得人人学习。学编程不等于手写代码,而是学会用计算机听得懂的方式把需求说清楚。会编程的职场人可以自己搭建网站、用程序筛选简历,与不会编程的人拉开明显生产力差距。孟岩补充观点:把'人人学编程'翻译成'人人用 Agent'更贴切。

技术 › LLM 宝玉 (@dotey) 2026-09-241.9 KB 57

Jev:离开 OpenAI 后,他做了一个不跟人聊天的 AI

本文整理了 Latent Space 对 TypeSafe 联合创始人兼 CEO Diogo Almeida 的访谈。Diogo 曾参与 OpenAI 的 InstructGPT 与 RLHF 早期工作,但他质疑'讨人喜欢'与'帮助人做对事'并不一致,并认为 AI 的调用者将主要是代码而非人类。离开 OpenAI 后,他创办 TypeSafe,推出名为 Jev 的'系统一模型'(大型可编程模型),让模型输出可被代码直接使用的判断结果,而非聊天回复。他强调单位美元智力、可靠性与速度,反对刷榜,看好暗数据处理与 AI 深入 SaaS 流程的未来,目标是让模型像 VISA 一样成为不被谈论的基础设施。

技术 › LLM Frank Wang 玉伯 2026-09-2417.5 KB 35.4K 56 76

Use Jev to extract signals from millions of chat agent traces

本文介绍如何利用 Jev 类模型大规模分析数百万条聊天 Agent 生产轨迹,从中提取失败信号。传统 LLM-as-a-judge 评估依赖采样以控制成本,而 Jev 类模型可在同一上下文中并行回答多个问题,以极低成本对全部轨迹进行全面评估。文中讨论了显式反馈、行为追踪、事实结果和对话信号等不同类型的用户信号,并以航班改签客服对话为例,展示如何同时捕捉后续提问、用户挫败感和结果满意度等维度。文章最后介绍如何在 Langfuse 中配置基于 Jev 的批量评估模板,实现生产信号的监控与可视化。

技术 › LLM Annabell 2026-09-245.7 KB 59.9K 171 70

BestBlogs 早报 · 09-24|OpenAI 拆解 GPT-6 提示缓存,Gemini 3.8 语音生成模型、Grok 4.7 发布

本期早报围绕 AI 模型与工程实践展开三大精讲:一是 OpenAI 为 GPT-6 改进提示缓存,命中率提升并推出缓存诊断工具,缓存输入折扣最高 90%;二是 Google DeepMind 发布 Gemini 3.8 Flash TTS 和 Flash-Lite TTS,支持声音创作、双说话人控制与授权声音复刻;三是 xAI 发布 Grok 4.7,聚焦长任务编程与自我验证,附基准与定价。速览部分涵盖腾讯错误码治理 Agent、网易 AI 原生组织实践、Reducto 文档智能、阿里 AI Native 研发手册、大淘宝小游戏 Agent、Harness 记忆与验证闭环及良渚 vibe coding 社区观察。

技术 › LLM ginobefun 2026-09-2424.5 KB 4.5K 4 76

How to train your own Jev for $17

本文介绍如何以约17美元的成本微调一个类似Jev的高效分类模型。作者基于Qwen3.5 4B,从MultiNLI、BoolQ、Banking77、AG News、SST-5等多个Hugging Face数据集中采样约3.8万个样本,通过脚本归一化数据后,使用Together AI的Fine-tuning服务启动训练任务(约25分钟完成),再将模型部署到Together AI的专用端点(dedicated endpoint),并通过API查询模型完成分类任务。文中还发布了可直接使用的together/Tev1-4B-experimental模型,适用于客服意图识别、文本情感分析、论文分类等实际场景,涵盖从环境搭建、数据准备、训练到部署查询的完整流程。

技术 › LLM Hassan 2026-09-2412.4 KB 822.4K 2K 76

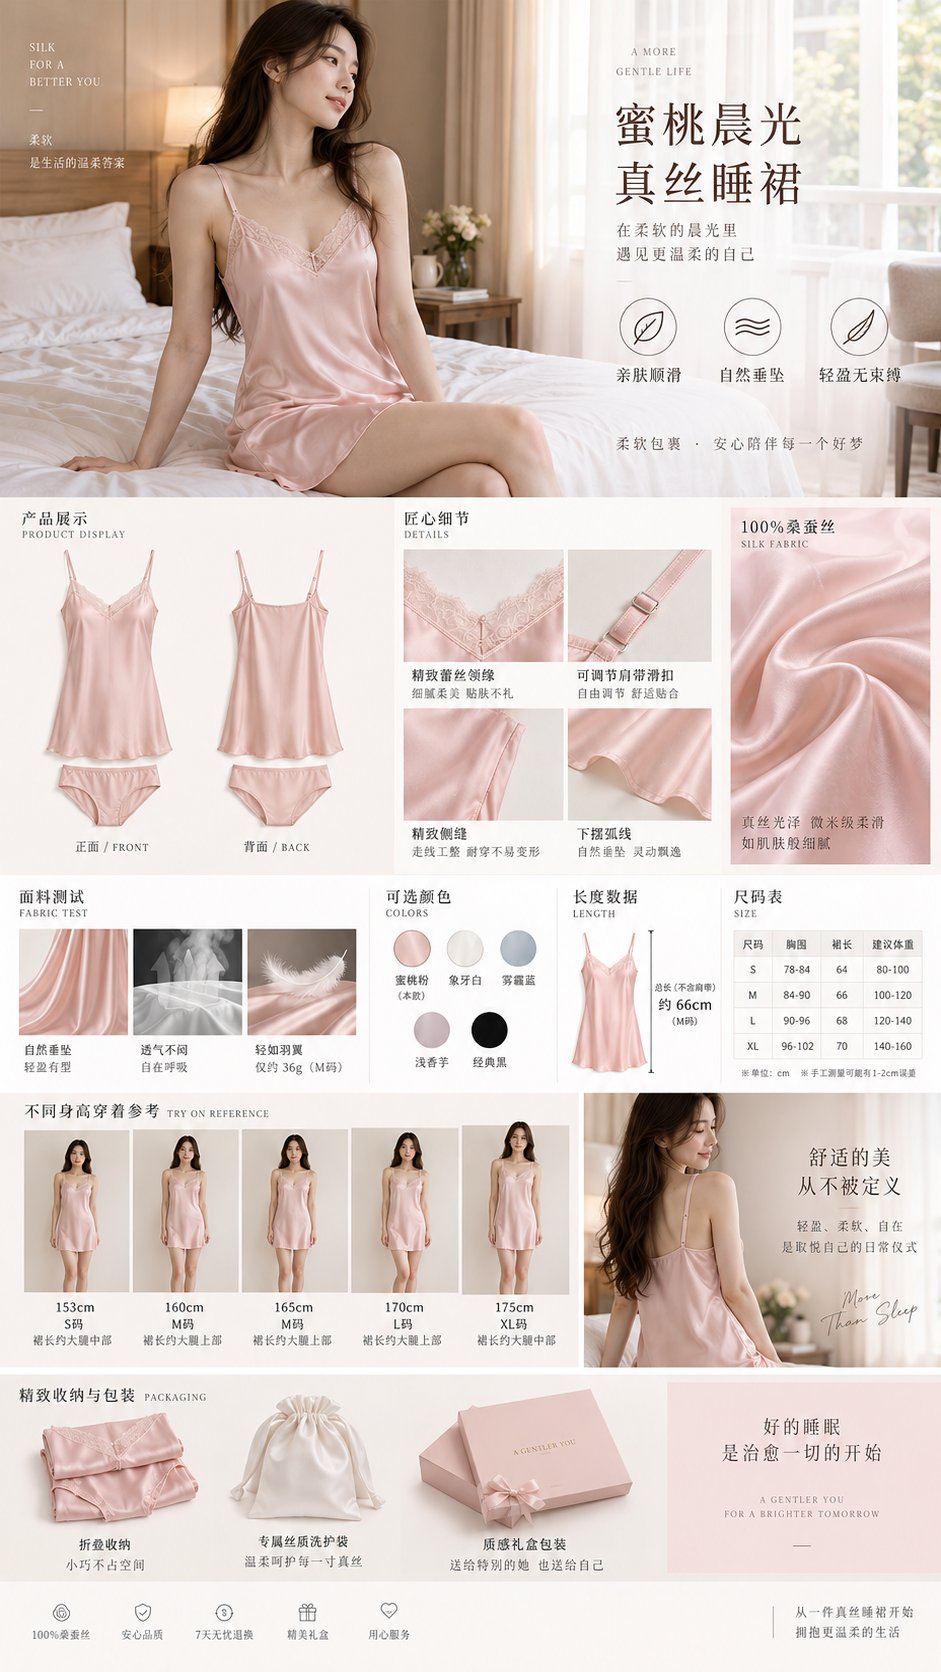
蜜桃粉真丝睡裙电商详情页 GPT Image 提示词

文章分享了一个使用 GPT Image 2.5 生成电商详情页图片的提示词案例。内容为生成一张 9:16 竖版的蜜桃粉真丝睡裙电商详情页,模拟高级生活方式品牌的移动端页面。提示词详细描述了产品细节(柔粉真丝吊带睡裙、蕾丝领缘、可调节肩带)、场景设定(私人酒店卧室)、首屏标题与卖点文案,以及中段的商品平铺展示、面料微距、尺码表等内容,并明确规避诱惑姿势、透视走光等风险点,展示了 AI 图像生成在电商设计中的应用。

技术 › LLM Mr.pinecone 2026-09-241.5 KB 59

AI一句话生成知识讲解视频:知识博主的末日?

作者用 Opus 5.5 一句话生成了一个讲解 password 与 passkey 区别的 4 分钟互动讲解视频,包括配音(edge-tts)、字幕、封面图等,质量高于一般人类知识博主水平。作者感叹AI不仅完成视频制作,还主动铺好后续改版、竖屏适配等路径,认为知识讲解类视频博主的生存空间将被颠覆——获取知识的范式正在改变,只有亲身经历类内容尚有竞争力。

技术 › LLM Tz (@Tz_2022) 2026-09-243.4 KB 47

我用两周时间将真实工作交给 GPT-6 Astra,结果令人惊艳

作者用两周时间在编程、销售、财务、客服、法务和电商等场景中实测 GPT-6 Astra。核心发现:传统自动化在可预测输入下仍最优,而 Astra 适合需要判断力的“混乱中间地带”;它能操作从未见过的软件界面(如 CRM、后台系统);作为编码 Agent 可定位并修复真实 bug 并补测试;能端到端完成销售准备、竞品分析和财务数据处理等完整工作流。作者建议拆分成多个窄领域 Agent 使用,并从现有工作流出发而非凭空构建场景。

技术 › LLM wluha 2026-09-2314.8 KB 227.6K 25 74