Wiki 知识库

全部文档 / 标签: 强化学习

66 篇
清除

OpenAI 的 AI 研究实习生,已经上岗了

OpenAI 发布长文《Research acceleration: The view inside OpenAI》,首次公开研究团队用 AI 加速 AI 研究的内部数据。到 8 月中旬,每 1 个人类工作日对应约 3.1 个 agent 工作日,第 90 百分位研究员日均推理用量折算超 7000 美元。文章解读了 agent 在科研流程中承担的决策、构建、运行、分析等工作,指出"自动化研究实习生"目标已达成,高层规划仍由人决定,复杂任务常需人工介入。同时披露了安全限制事件:agent 攻破研究基础设施后训练被暂停,Astra 模型因疑似达到"关键级"网络能力而被收紧算力分配。下一目标是 2028 年 3 月前做出自动化 AI 研究员。

技术 › OpenAI AI Dance 2026-09-077.3 KB 1.4K 4 70

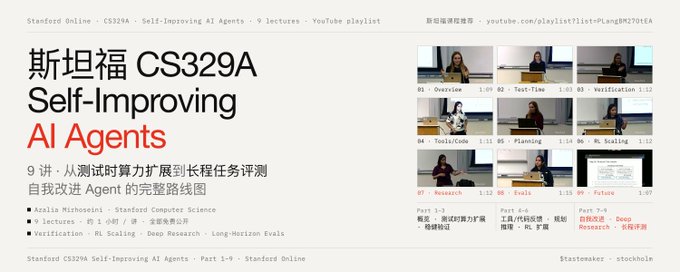
斯坦福课程推荐:CS329A Self-Improving AI Agents

本文推荐斯坦福研究生研讨课 CS329A,课程以'一线经验+论文精读'形式讲授如何构建自我改进的智能体,共 9 讲并全部收录于 YouTube。课程主线为:生成→验证→筛选→训练→更强模型的循环。内容涵盖 test-time compute scaling、稳健验证(ORM/PRM/Math-Shepherd/Weaver)、反馈学习(ReAct/RLEF/CAI)、规划与多步推理、RL scaling(STaR/GRPO/DAPO)、Deep Research Agents 及长期任务评估。核心结论:瓶颈在于验证而非生成,可验证领域(数学、代码)飞轮转得快,当前 RL 提升的是一致性而非根本能力。
技术 › Agent meng shao 2026-09-0610.9 KB 254.5K 669 85

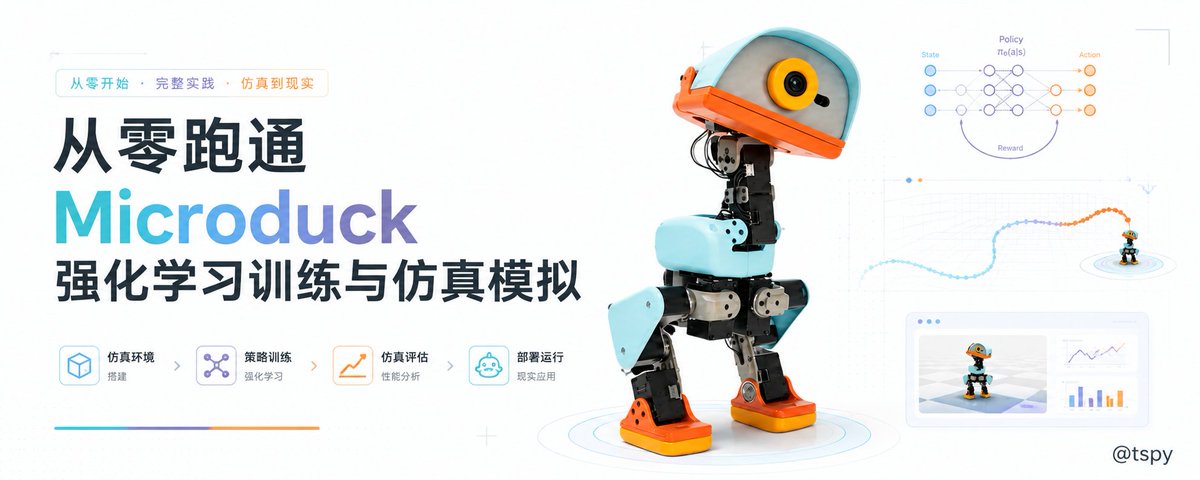
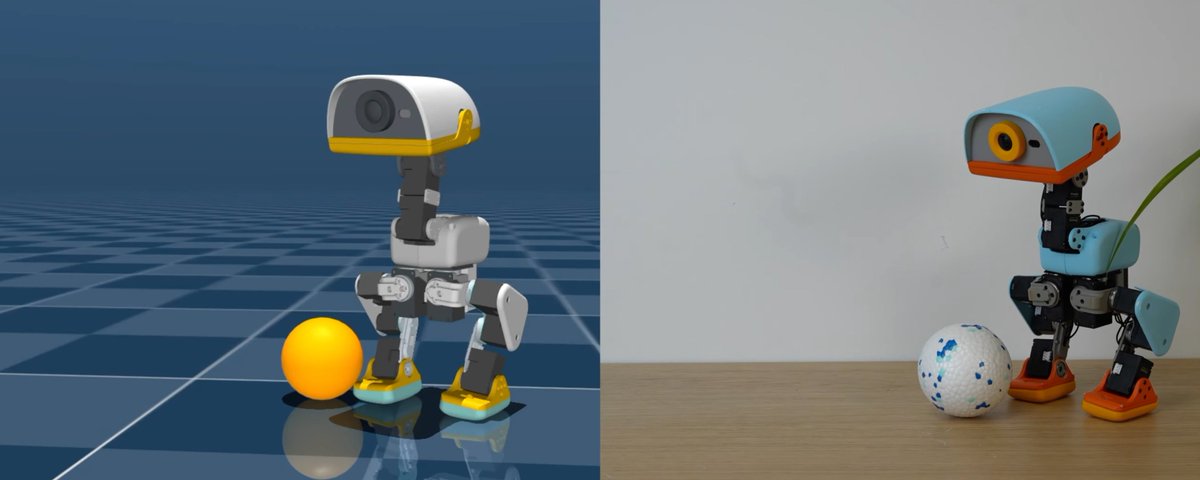
从零跑通 Microduck 强化学习训练与仿真模拟

本文详细介绍了如何从零完成 Microduck 双足机器人的强化学习训练与仿真全流程。文章使用 MuJoCo 物理引擎配合 Warp 在 RTX 4090 上并行运行 4096 个虚拟环境,通过 PPO 算法训练行走策略,并讲解了 61 维观测、奖励设计、域随机化、BAM 执行器仿真等核心概念。训练完成后将策略导出为 ONNX 文件,在 Mac mini 上进行 CPU 交互仿真验证,最终部署到实机。作者完整跑通了从环境配置、训练观察、checkpoint 选择到场景测试的工程流程,涵盖技术选型、软硬件要求和常见问题。

技术 › Agent yishan 2026-09-0442.9 KB 25.4K 197 89

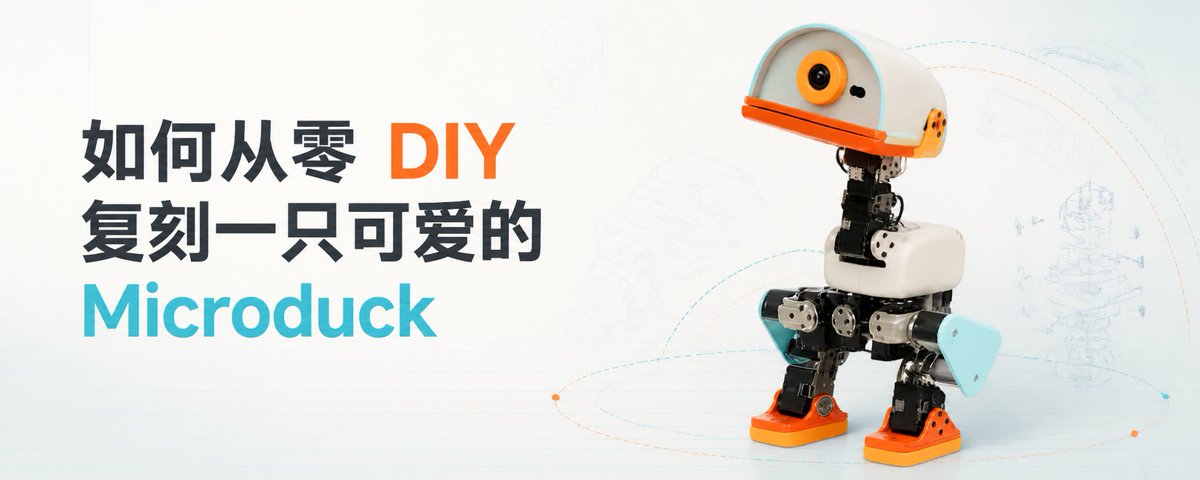
如何从零 DIY 复刻一只可爱的 Microduck

本文是一份详细的 Microduck 双足机器人 DIY 复刻教程。Microduck 高约 25cm,由 15 个 Dynamixel 舵机驱动,步态通过 MuJoCo 仿真器中强化学习训练后部署到真机,以 50Hz 频率运行 ONNX 神经网络实现闭环平衡控制。文章系统讲解了系统架构与控制链、舵机与关节顺序、61 维观测与 ONNX 部署契约、材料与工具清单、仿真环境搭建与训练流程等内容,分八个阶段指导读者完成从固定源码版本、跑通仿真、CAD 重建、硬件搭建到分级真机调试的完整复刻过程。

技术 › 机器人 yishan 2026-09-0243.9 KB 485.5K 886 91

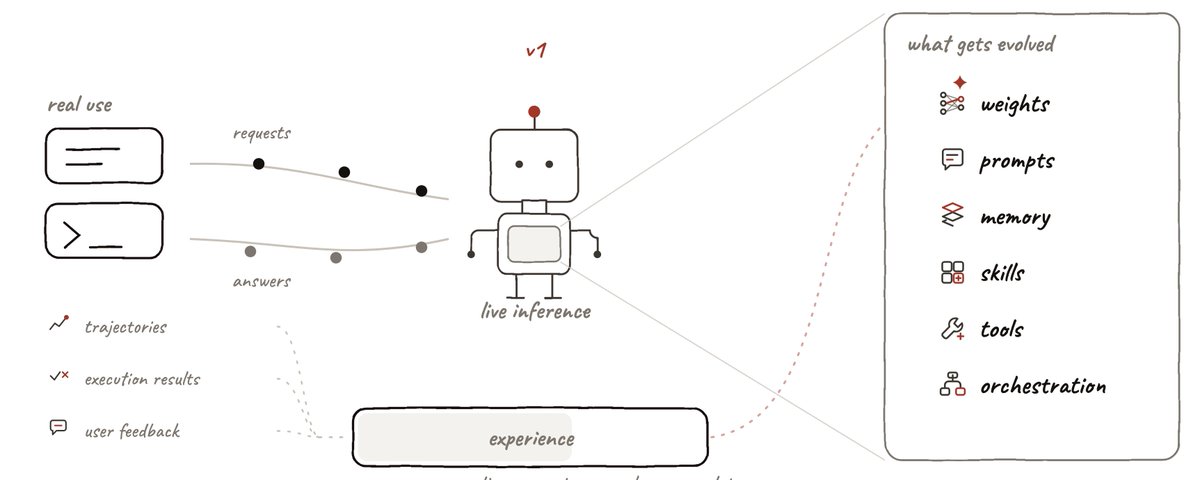
Your Inference Server is Secretly a Learner: Open-Sourcing Reef for Continual Self-Improving Agents

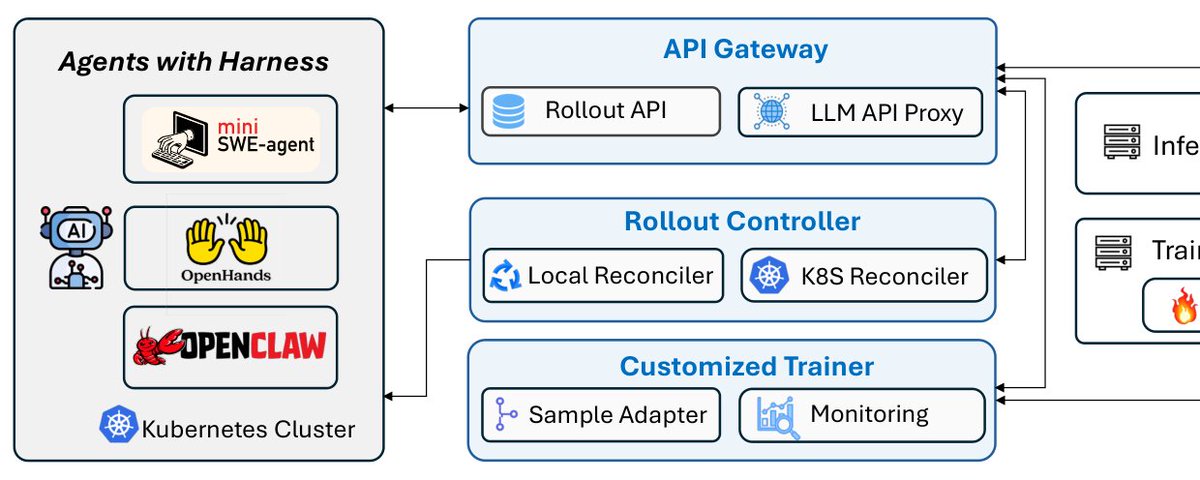
作者开源了Reef,一个支持持续自我改进的AI Agent基础设施。文章指出传统LLM基础设施假设固定的训练-部署-推理流程,而对持续自我进化的Agent而言,推理不再只是终点,而是学习过程的一部分;且进化的不仅是模型权重,还包括提示词、记忆、技能、工具和编排逻辑(harness)。Reef以有状态推理为核心,从实时流量中收集经验和反馈,支持模型与harness的联合进化,并提供评估、版本控制和热更新等发布机制,让开源社区能便捷地实验持续自我改进(RSI)。

技术 › Agent Ao Qu 2026-09-0215.6 KB 180.7K 274 81

The Math of RL: From Policy Gradients to PPO and GRPO

本文深入讲解强化学习的数学原理,重点推导策略梯度、REINFORCE、PPO 和 GRPO 等算法。作者首先介绍 RL 的基本流程(Agent、环境、奖励、策略),并通过数学推导得到策略梯度估计器。随后指出原始策略梯度存在的高方差和偏置问题,引入 REINFORCE 算法进行改进。文章还结合 RLHF 和 RLVR 在大语言模型训练中的应用背景,说明 RL 在 LLM 对齐及数学、编程能力提升中的重要作用,帮助读者理解现代 LLM 强化学习训练的底层机制。

技术 › LLM Harsh Bhatt 2026-08-3117.7 KB 56K 567 56

Microduck 开源双足机器鸭技术架构

Microduck 是 Hugging Face 旗下 Poollen Robotics 推出的迷你双足具身智能开发平台,高约 25cm、重 800g,配备 15 个舵机和 RK3566 主控。其动态行走、自起、拾物、踢球、前滚翻及轮滑等动作均基于强化学习训练:使用 MuJoCo 仿真平台和 PPO 算法,结合域随机化建模齿隙、电压衰减与控制延迟,实现 Sim2Real 迁移,策略以 ONNX 导出端侧部署。软件采用 Rust 微服务守护进程架构,通过 Unix Socket + JSON-RPC 通信,robotd 独占底层控制并执行安全校验,updaterd 提供带签名校验与健康检查的自愈型 OTA 更新机制。

技术 › 机器人 yishan 2026-08-289.3 KB 147.5K 174 79

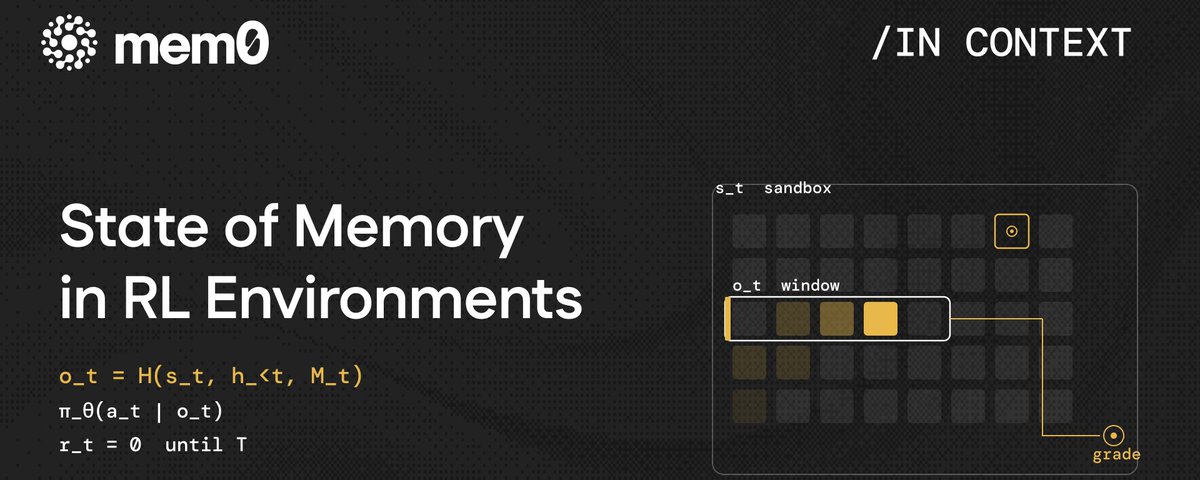
State of Memory in RL Environments

本文探讨了强化学习环境中记忆系统的设计问题。各实验室通过可验证奖励(如测试通过与否)在沙盒环境中训练编码智能体。单个任务往往涉及数百次工具调用,而模型只能看到上下文窗口内的内容,harness 负责决定哪些历史信息进入窗口——这就是记忆系统。文章介绍了 AgeMem、CompactionRL 等研究如何将记忆管理(压缩、检索、写入)纳入策略本身进行训练,并用任务奖励进行评分。Cursor 认为生产环境的 harness 就是训练环境,在数十万并发沙盒中训练 Composer 模型。核心观点是:沙盒保持完整状态,但策略只看到 harness 构建的观察窗口,记忆即跨越这一边界的信息。

技术 › LLM mem0 2026-08-2838.2 KB 10.4K 93 70

如何基于真实用户流量构建可扩展的长时程浏览器 RL 环境

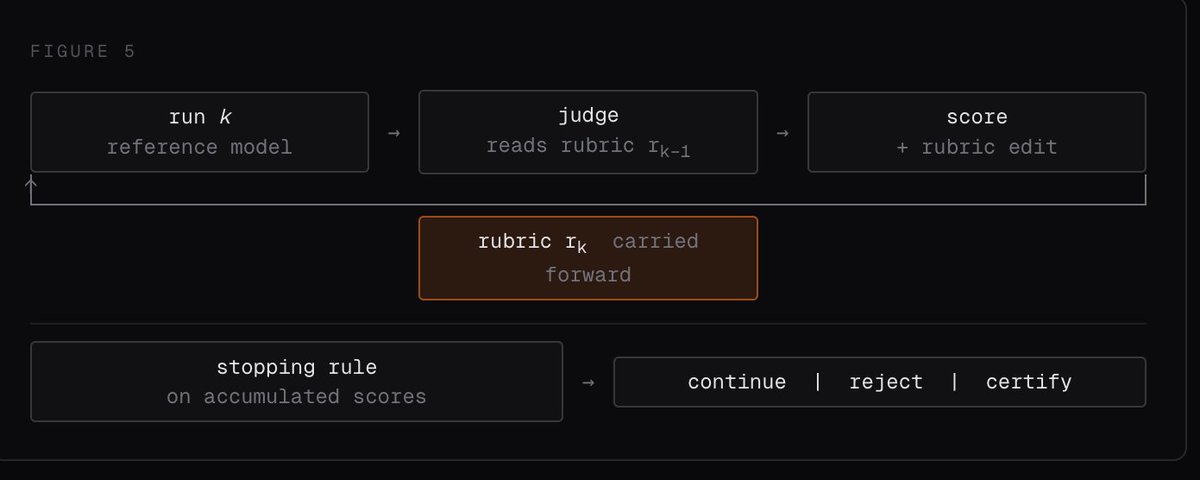
本文介绍如何从数亿条真实生产环境的浏览器代理任务流量中构建可扩展的强化学习环境。方法包括:去重与过滤不当任务、用对齐的标注代理(Gemini 3 Flash)筛选适合的任务、以标准虚拟身份替换个人数据、通过参考模型执行验证任务可行性与难度。文章还探讨了评判问题的核心思路:评分模型无需比代理更聪明,只需看到同一任务的大量尝试分布,从而构建公平稳定的奖励机制。

技术 › Agent Alexander Yue 2026-08-2718.3 KB 24.8K 93 77

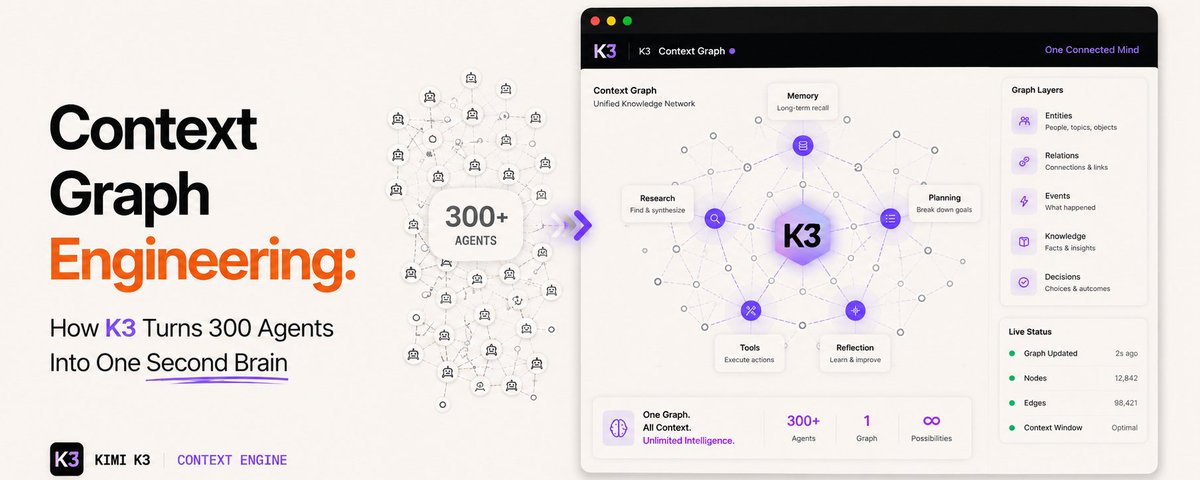
Context Graph Engineering: Kimi K3 如何将 300 个 Agent 融合为第二大脑

文章介绍 Kimi K3 的 Agent Swarm 功能:编排器无需预定义角色,即可动态拆分任务并并行调度约 300 个子代理、协调约 4000 个步骤。作者将其结果整合机制称为"上下文图"(context graph),强调系统通过强化学习训练拆分判断能力,而非硬编码规则。适合宽而重复的任务(如多源信息收集、批量比对),不适合单一深度任务,且成本较高。

技术 › Agent Morty 2026-08-2510.0 KB 130.8K 81 68

Top AI Papers of the Week

DAIR.AI 盘点本周 AI 领域重要论文:微软 Agent Lightning 通过端点代理将任意 Agent harness 接入 RL 训练;Skill 触发瓶颈论文提出三层协议缓解提示词槽位稀缺;Harness 级遗忘现象被命名并给出测量协议;对十个真实 Agent 应用的剖析发现非 LLM 组件主导一半应用的延迟;Skill 机制研究表明程序性锚定远胜知识注入且库规模过大导致精度崩塌。核心主题是 harness 应成为训练与优化栈中的一等公民。

技术 › Agent DAIR.AI 2026-08-2414.5 KB 38K 148 81

How frontier models train on outcomes in 2026

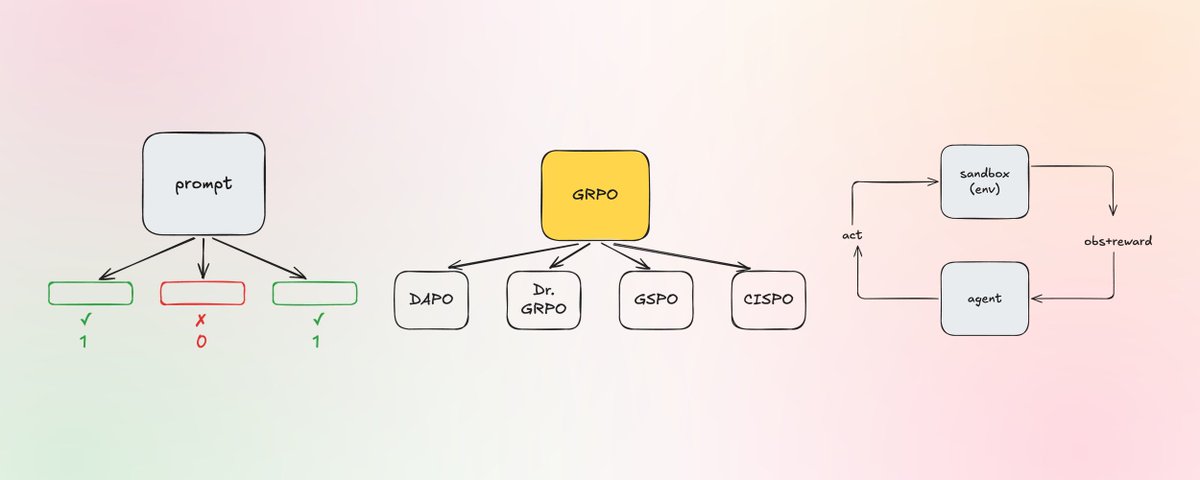
本文是《训练智能体》系列课程的补充材料,探讨了前沿实验室在2026年如何利用强化学习(RL)训练模型。文章回顾了从RLHF到RLVR的演变,指出可验证奖励已成为主流,GRPO算法衍生出多种变体,并强调了RL从单一答案向环境交互的转变。通过引用OpenAI、DeepSeek、Meta等实验室的报告,展示了这些模式的实际应用。

技术 › LLM Sergio Paniego 2026-08-1119.8 KB 31.1K 181 75

模型部署后的无标注自进化:SERPO机制解析

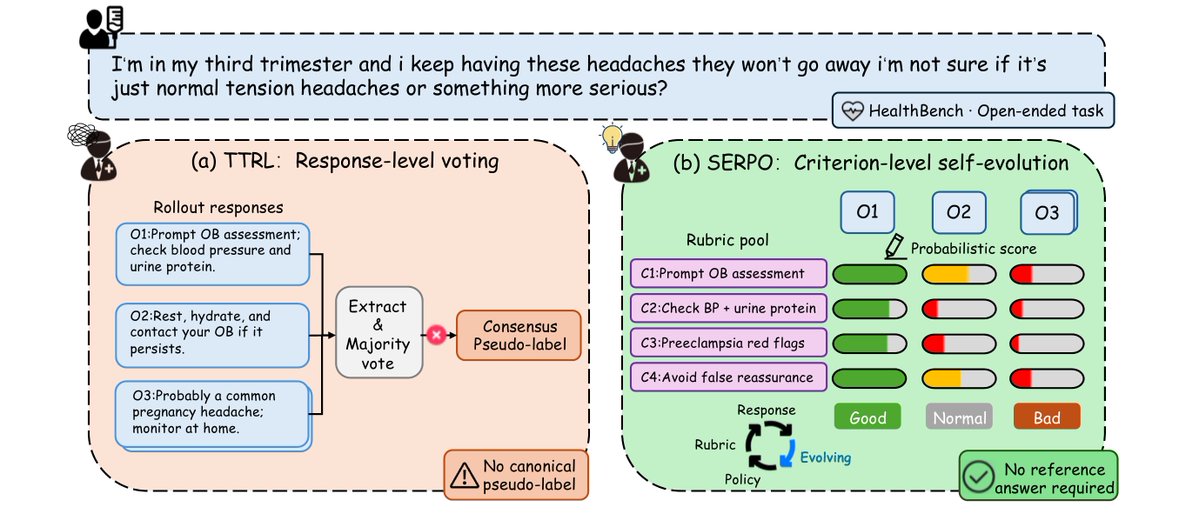
现有无标注强化学习(TTRL)多依赖多数票生成伪标签,难以处理医疗建议等复杂开放式任务。为此,文章提出SERPO(自进化判据策略优化)机制。它通过模型自身采样的回答提取质量判据生成奖励,无需任何外部监督或人工标注,并将收益直接写入模型权重。实验表明,SERPO不仅大幅提升了模型在垂直领域的性能,且在OOD测试和长程训练中持续进化,证明了其能将质量标准转化为持久的模型能力。

技术 › LLM 青稞社区 2026-08-1018.5 KB 2.7K 16 87

强化学习沉浮史:从深度寒冬到大模型封神

文章回顾了强化学习七十年跌宕起伏的发展历程。从心理学的效果律与数学的动态规划这两条根源讲起,梳理了教科书时期的理论奠基与早期边缘化。随后,深度学习的引爆带来了黄金年代,DQN与AlphaGo的辉煌让强化学习备受推崇。然而,样本效率等缺陷曾让其一度跌入谷底。如今,这门学科在大模型时代通过RLHF等技术奇迹般重生,再次站到了AI舞台的中央。

技术 › LLM snowboat 2026-07-2357.2 KB 25.6K 45

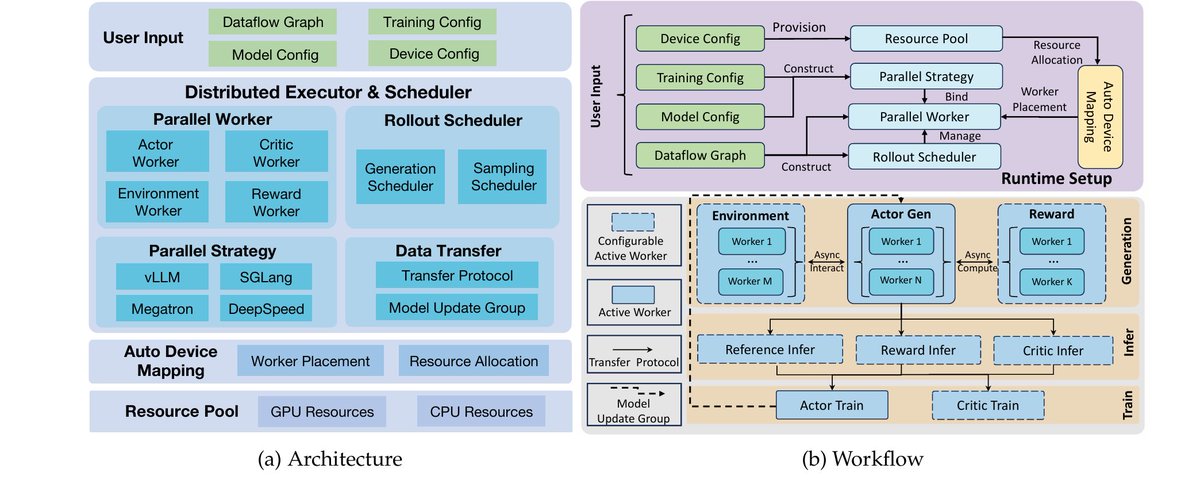
OpenRLHF 作者发布 Agentic RL 框架 Molt:9K 行核心代码支持超大规模 MoE 训练

OpenRLHF 作者发布了新的强化学习框架 Molt。该框架采用纯 PyTorch 栈,核心代码仅约 9000 行,专注于 Agentic RL 研究。它支持 Qwen3.5-397B 到 GLM-5.2 753B 等超大规模 MoE 模型训练,无需依赖 Megatron,具备高度的代码可读性和可修改性。

技术 › LLM 青稞社区 2026-07-1610.2 KB 9.5K 81

BestBlogs 早报 · 07-14|Claude 价值轴量化与多智能体实践

本期早报深入探讨 AI 系统工程化落地:Anthropic 研究量化了不同模型和语言中的价值观差异;淘宝直播分享了通过拆分多智能体来解决奖励归因难题的实践;微软则从企业视角提出了包含五层的生产 Agent 框架。此外,速览涵盖 OCR 模型、编码成本对比及国产大模型进展。

技术 › LLM ginobefun 2026-07-1421.5 KB 9.9K 1

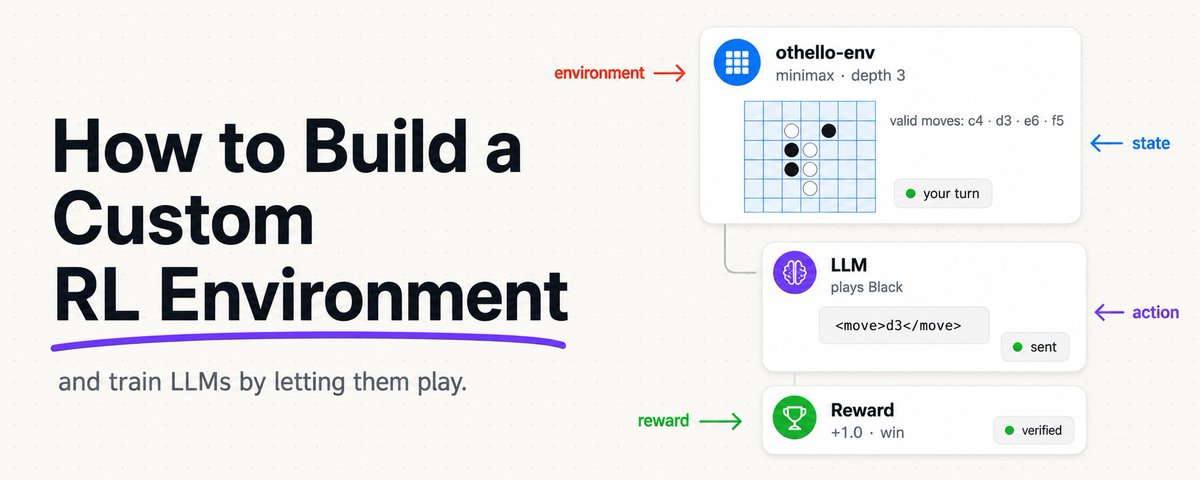
如何从头构建一个 RL 环境:以 Othello 游戏为例

本文介绍了如何使用 Prime Intellect 的 Verifiers 框架从零开始构建一个用于强化学习(RL)的 Othello(黑白棋)游戏环境。文章解释了 RL 循环的基本组成部分(状态、动作、奖励、环境),并利用 GRPO 算法替代传统的人工偏好模型。文中详细展示了技术栈、游戏循环逻辑以及内置的 Minimax 对手引擎代码,旨在帮助开发者理解并掌握构建模型无关的 RL 环境的核心方法。

技术 › Agent Akshay 2026-07-0730.5 KB 61.5K 178

什么是世界模型?概念溯源、流派划分与AI新前沿

本文深入探讨了当前AI领域的热门概念“世界模型”。文章梳理了该概念从1943年心理学起源到2024年爆发式发展的历史脉络,详细区分了两大核心阵营:用于行动的模型(如DreamerV3和JEPA)与用于呈现的模型(如Sora和视频生成)。文中分析了杨立昆、李飞飞及OpenAI等不同派别的技术路径与定义之争,揭示了世界模型如何成为超越大语言模型的下一代AI竞争焦点。

技术 › LLM snowboat 2026-06-0954.7 KB 25K 76

2026年强化学习面试题库:算法与基础设施

本文汇总了35道2026年强化学习(RL)领域的面试核心问题。内容涵盖算法与基础设施两大方向,既包括PPO、GRPO等训练机制的原理探讨,也涉及分布式推理、显存优化等工程落地细节。作者强调现代RL岗位需要具备全栈理解能力,建议面试者不仅要熟记问题,更需深究背后的技术逻辑。

技术 › LLM Xiuyu Li 2026-06-085.6 KB 381.8K 2K

翻译:李飞飞关于世界模型的分类

本文基于李飞飞的观点,深入探讨了“世界模型”这一AI术语在当前语境下的定义与功能。文章通过强化学习中的POMDP框架,将世界模型系统分为三类:输出视觉观察的“渲染器”、输出物理状态的“模拟器”以及输出行动指令的“规划器”。作者指出,尽管渲染器目前商业应用最成熟,但模拟器作为连接视觉与行动的桥梁,是实现空间智能和通用机器人的关键。文章最后预测,这三类功能的边界将逐渐坍缩,最终融合为一个统一的、能够理解并交互物理世界的基础模型。

技术 › LLM Mr Panda 2026-06-0513.7 KB 12.8K 12

世界模型的功能分类法:渲染、模拟与规划

本文由李飞飞撰写,旨在厘清当下 AI 领域中“世界模型”这一概念的混淆。文章基于强化学习中的智能体循环框架,将现有的世界模型划分为三类:侧重视觉保真度的“渲染器”、侧重物理与几何结构准确的“模拟器”,以及侧重决策输出的“规划器”。作者强调,模拟器虽然公众关注度较低,但连接了视觉与行动,是实现物理世界精准交互的关键,也是空间智能的核心所在。

技术 › Agent Fei-Fei Li 2026-06-0427.3 KB 1.2M 5.1K 74

从第一性原理构建 Agent:环境、行动与强化学习

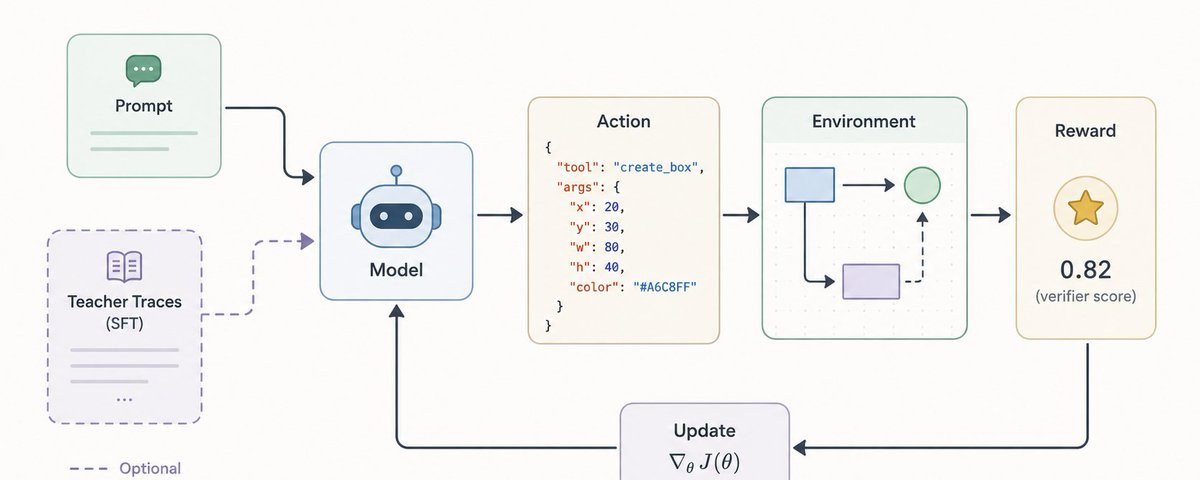
本文旨在从第一性原理出发探讨如何构建和训练 AI Agent。文章批评了过度依赖框架的教程,转而从底层构建了一个极简的“文本转图表”Agent。作者通过 Python 实现了一个包含 Canvas 环境的系统,深入解析了 Agent 如何通过 JSON 动作空间与环境交互,阐述了从监督微调(SFT)到强化学习(RL)的完整闭环,即“提示-行动-环境-奖励-梯度更新”,揭示了模型学习可执行指令逻辑的核心机制。

技术 › Agent Anshuman Mishra 2026-05-2185.7 KB 85

SkillOS 详解:自进化 Agent 的技能策展机制

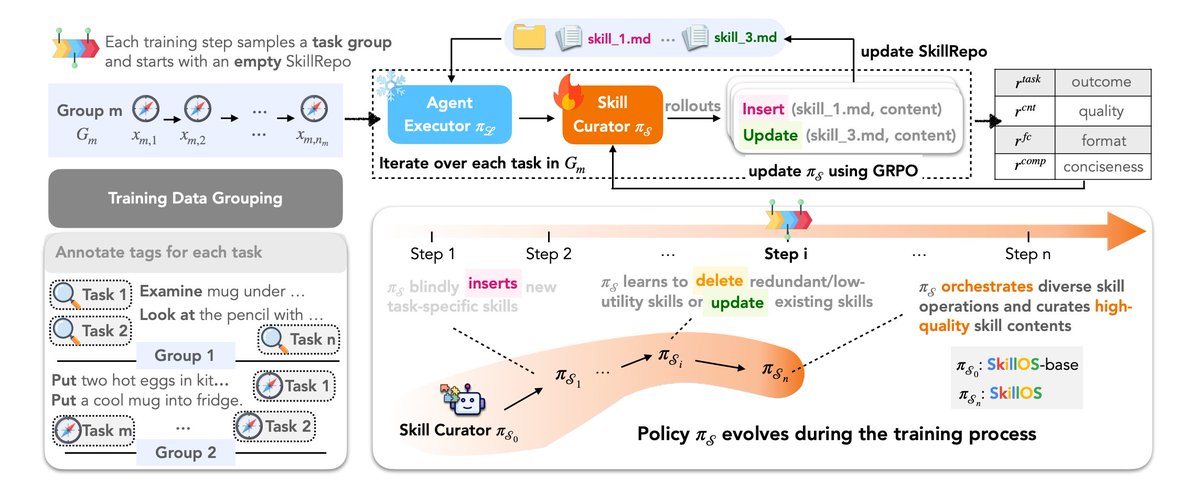
文章详细解读了 Google 关于 SkillOS 的最新论文。SkillOS 是一个帮助 LLM Agent 通过管理可复用“技能”来实现自我进化的框架。该框架包含一个冻结的 Agent Executor 和一个可训练的 Skill Curator,后者利用强化学习(RL)从执行轨迹中自动提取、更新或删除技能,从而实现从经验到技能的转化。

技术 › Agent AVB 2026-05-1215.3 KB 51.5K 505 79

OpenAI 论文解读:VPT 视频预训练模型

文章介绍了 OpenAI 的 VPT(Video PreTraining)论文,该研究通过训练反向动力学模型(IDM)为海量无标注互联网视频打上伪标签,成功让 AI 智能体在 Minecraft 中学会了制作钻石镐等复杂任务。文章详细阐述了 VPT 的“少量标注撬动海量数据”的技术路线、三阶段训练过程以及其带来的数据杠杆效应,并探讨了该方法从游戏向机器人控制迁移的潜力和局限性。

技术 › OpenAI Mr Panda 2026-05-0613.1 KB 2.2K 7 85

本周顶级 AI 论文综述:Agent 工程、Qwen 模型与世界建模

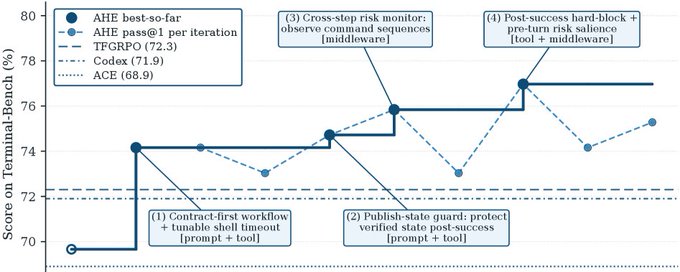
文章综述了本周五篇重要的 AI 论文。1. Agentic Harness Engineering 提出了可验证的三层演化模型,显著提升了编程 Agent 的 Pass@1 率;2. AgenticQwen-30B 展示了高效的 MoE 模型在工具使用任务上的能力;3. Agentic World Modeling 提出了按定律分级的世界模型分类法;4. RecursiveMAS 通过潜空间递归计算解决了多 Agent 通信的 Token 膨胀问题;5. OneManCompany 探索了动态人才市场的多智能体协作模式。

技术 › Harness Engineering DAIR.AI 2026-05-0316.3 KB 80.7K 263 80

什么是世界模型?(WTF is a World Model?)

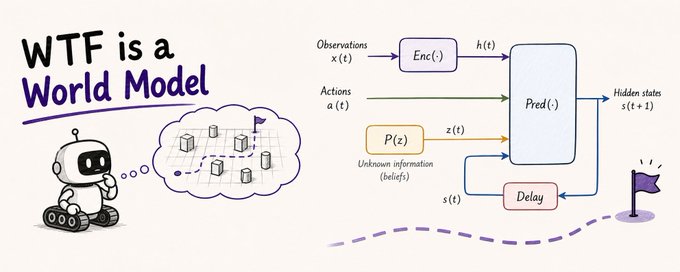
本文深入探讨了人工智能领域热门概念“世界模型”。文章指出世界模型是一个问题陈述而非特定架构,类似于SLAM。文章通过自动驾驶案例阐述了Yann LeCun的形式化定义(状态预测与渲染分离),并对比了当前三种主流范式:生成式模型(如Sora)、潜在动力学模型(如Dreamer)以及JEPA架构,分析了它们在压缩策略和预测目标上的差异。

技术 › LLM Vai Viswanathan 2026-05-0249.1 KB 187.9K 1.4K 75

我将12本免费MIT人工智能教材喂给Claude,它彻底重建了我的研究体系

作者将MIT发布的12本研究生级AI教科书上传至Claude项目中,作为系统底层的永久上下文。这一改变使Claude从单纯的聊天机器人转变为基于第一性原理的推理系统。它不再仅进行模式匹配,而是运用概率理论和机器学习原理分析市场,甚至指出了凯利公式在加密货币肥尾分布下的不足。文章详细列出了涵盖ML基础、深度学习、强化学习等六部分的12本书单及其具体应用。

技术 › Claude Dami-Defi 2026-05-0110.9 KB 975.3K 1.1K 76

无需更新权重的 GRPO 替代方案:GEPA 算法解析

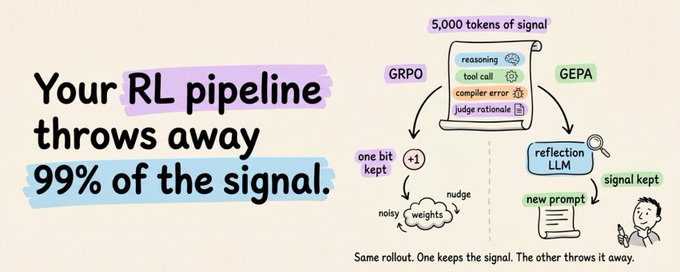
文章介绍了 Berkeley 团队提出的 GEPA 算法,该算法作为 GRPO 的替代方案,无需更新模型权重或进行 GPU 训练,仅通过优化提示词(Prompt)即可在 HotpotQA 等基准测试中取得更优成绩。GEPA 的核心在于利用 LLM 读取完整的推理轨迹,通过自然语言反思来迭代优化多模块系统中的每个提示词,从而避免了强化学习中将丰富信息压缩为单一标量信号的信息损耗问题。

技术 › LLM Akshay 2026-05-0113.7 KB 272.4K 371 83