Kimi K3.1 Pro 实测对比 GPT-6 Astra:3D 建模能力与成本分析
本文实测对比了 Kimi K3.1 Pro 与 GPT-6 Astra 在多个 3D 任务上的表现,包括古建筑建模、机械结构、透明材质和游戏开发等。结果显示,Kimi 在精细模型构建上更优,而 GPT 在大型场景稳定性上更好。成本方面,Kimi 比 GPT 便宜约 80%,性价比突出。文章还提供了使用 Kimi 进行 3D 建模的入门指南。
本文实测对比了 Kimi K3.1 Pro 与 GPT-6 Astra 在多个 3D 任务上的表现,包括古建筑建模、机械结构、透明材质和游戏开发等。结果显示,Kimi 在精细模型构建上更优,而 GPT 在大型场景稳定性上更好。成本方面,Kimi 比 GPT 便宜约 80%,性价比突出。文章还提供了使用 Kimi 进行 3D 建模的入门指南。
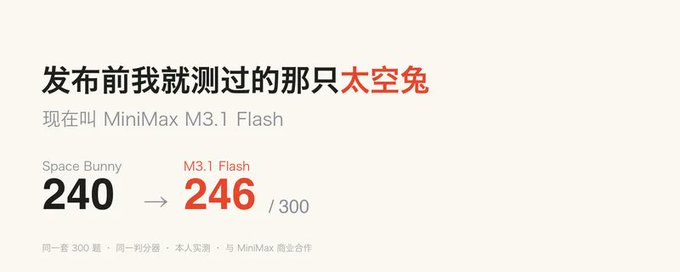
作者在 MiniMax M3.1 Flash 还以匿名模型 Space Bunny 身份活跃时,用自己维护的 300 题封闭测试集(HumanEval+/MBPP+ 代码题与 MMLU-Pro 推理题)进行了评测,匿名期得 240 分。正式版发布后用同一套题复测得 246 分,两版表现几乎一致,主要提升在代码题。代码能力与 DeepSeek V4.1 Flash-1017 基本打平;官方数据显示其在企业流程自动化和操作电脑两项为国产第一,且成本显著低于 Claude Opus 5。短板是困难推理。整套 300 题成本仅一元出头,性价比突出。
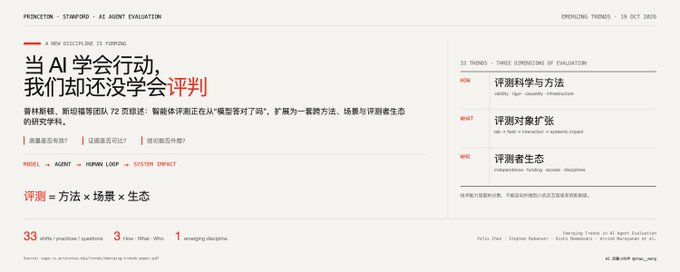
普林斯顿、斯坦福等机构联合发布 72 页综述「Emerging Trends in AI Agent Evaluation」,以 How(怎么做)、What(测什么)、Who(谁来做)三维度梳理智能体评测的 33 个趋势。核心论断:随着 AI 从回答问题走向自主行动,传统跑分范式失效,agent 评测正成为一门以心理测量学为骨架的新学科。文章介绍了效度危机、pass@k 与 pass∧k 区分、因果归因、污染新表面、LLM 裁判等方法论问题,以及模拟用户失真、田野实验负面结果、评测环境成为攻击面等实证发现,并直言评测生态受资金、访问权与议程影响,独立评测面临生存危机。
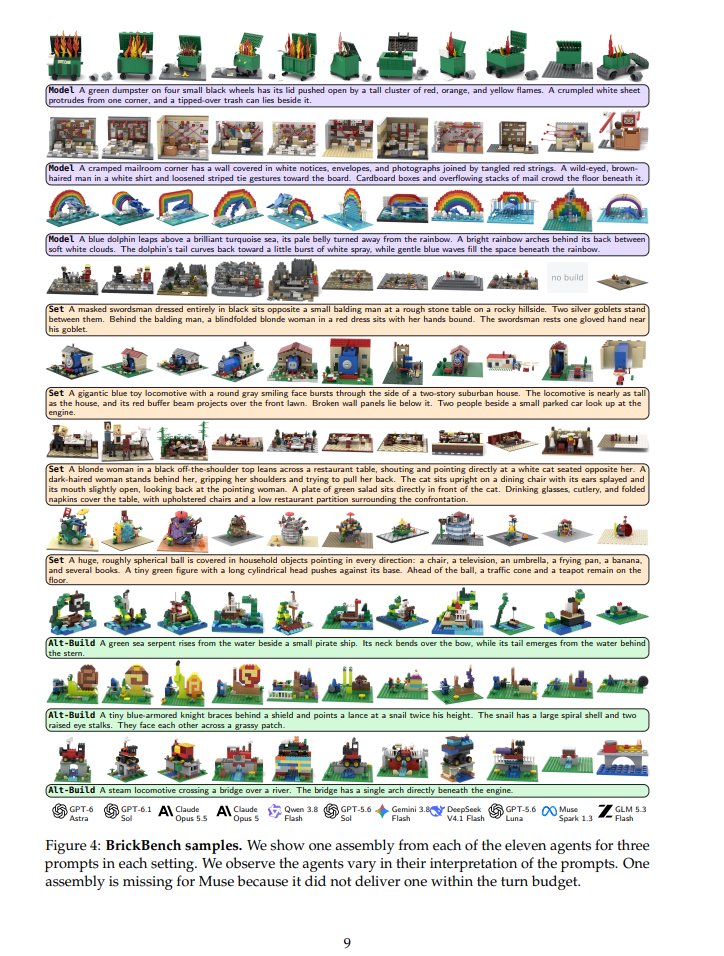
本期精选5篇高质量AI论文:1) AI智能体生态研究揭示协作产生强Allee效应,种群规模存在起飞阈值,对智能体安全有重要意义;2) BrickBench提出文本条件乐高组装的智能体基准,融合物理仿真验证;3) 思考惯性研究显示LLM被告知不思考时仍会输出显式推理,挑战一条指令关闭思维链的假设;4) 从形式化验证角度分析智能体自我改进的理论基础与极限;5) 提出工具型智能体的主动遗忘方法,可逆地整理上下文,累积输入token约减少50%,无需训练即可降低成本。
本文系统讲解了 AI 系统评估的基础知识,面向构建、购买或审批 LLM 应用的工程师、产品经理和管理者。文章以一个自行车商店客服助手为例,介绍评估的核心循环:收集带标准答案的输入、运行系统、用代码规则或模型裁判进行打分、生成带误差范围的指标。内容涵盖测试集与开发集的划分、失败模式分析、代码评分器与模型裁判的优劣、基准测试与评估的区别、以及如何将评估纳入日常开发流程,强调评分器本身也需要被检验。
Mathias Strasser(Scissero)基于 Qwen3.5 和 Gemma 4 微调出 Jeff 系列 0.8B/2B 决策模型,用于零样本分类:输入描述与选项,一次前向传播返回各选项校准概率。模型在 RTX PRO 6000 上约 22 毫秒、M4 Max 上 28 毫秒即可完成一次决策,0.8B 仅 1.7GB,可直接本地部署。整体基准分 Jeff-2B 达 83.1,几乎追平 Jev 的 83.0;Doom 零样本测试中 Jeff-0.8B 在无人提示规则下达到 6.55,追平 Jev 公布成绩。作者诚实列出局限:不能推理、最多 26 个选项、只支持英文文本等。代码 MIT、权重 Apache 2.0 开源。
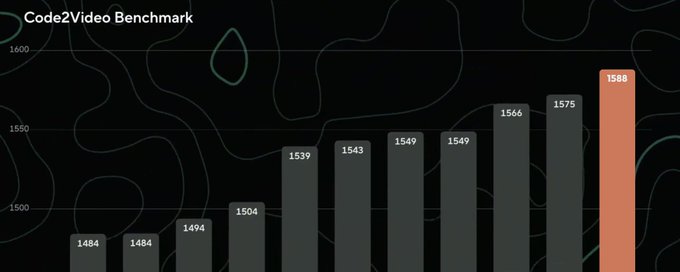
Code2Video 是与 Google DeepMind 和 Kaggle 合作推出的开放基准,测试模型在单次调用、无 Agent 框架和工具的情况下,根据视频需求生成代码生成视频的能力。Opus 5.5 排名第一,超过 GPT-5.5、GPT-6 Astra 和 Claude Fable 5.1。研究分析了约 70 个 X 上的一次性提示词,发现 Opus 5.5 常用 Python 画帧再交给 FFmpeg,或用无头浏览器逐帧捕获 HTML 页面渲染。其核心思路是把视频写作时间的函数 f(t),逐帧计算,输出可重复。 Opus 5.5 还能在无工具和文档的情况下凭记忆复现 HyperFrames 特有概念,20 次全部通过其检查器。配合 HyperFrames 约束和 CLI 规则,可减少错误、降低一半 token 成本。
本文介绍一种无需微调的方法,把现成的 LLM(GLM-5.3-Flash)变成类似 Jev 的专用决策模型(System One 模型)。核心做法是给选项编号、预填答案、通过读取选项索引上的概率分布,让模型在一次前向传播中给出类型化决策及其置信度。文章详细说明了 vLLM 部署中的三个实现细节(allowed_token_ids、logprob_token_ids、tokenizer 分词),并在 29 个公开数据集上与 Jev、Laya 进行基准对比:文本决策准确性与 Jev 相当,延迟相近但成本较高;由于具备视觉能力,还能做图像上的类型化决策,这是 Jev 和 Laya 做不到的。文章还讨论了推理模式的准确性收益与成本代价、选项数量与重命名对结果的影响,并开源了实现与基准代码。
本文深入探讨了 Claude 模型中 effort(努力程度)参数的作用与使用策略。作者通过实验和 Terminal Bench 3.0 基准测试分析发现:effort 本质上是控制模型在任务上投入的算力与自主判断程度。高 effort 在验证和边界测试重要的场景(如硬件、代码审查、安全)表现更佳;低/中 effort 则适合快速迭代、保持人类在环。作者还比较了不同规格化程度任务在各级 effort 下的输出差异,并总结出一套高效工作流:先让模型访谈自己补全规格,用低 effort 实现,人工审查后,再用高 effort 做验证和测试。
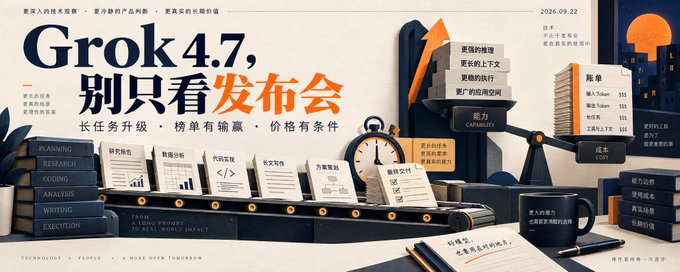
xAI 于 9 月 21 日发布 Grok 4.7,主打长任务能力:更大基础模型、更长强化学习训练、支持 50 万 token 上下文。文章分析官方与第三方基准成绩,指出其在编程等部分任务进步明显但并非全面领先,需结合自身需求看待榜单。价格方面,标准 API 单价较低,但长上下文(20 万 token 以上)计费翻倍、Fast 版本仅限特定平台,且模型实际 token 消耗可能很高,单价低不等于总价低。作者建议用真实工作任务测试模型,关注交付质量与总成本,而非被亮眼演示或单价吸引。
文章分析 Grok 4.7 发布,认为其核心不是能力跃迁而是定价进攻:输出价格仅为 GPT-5.6 Sol 的 30%、Fable 5.1 的 12%。在 CursorBench 4.0 上,Grok 4.7 Extra High 得分 46.3%,接近 Opus 5 Max 的 46.6%,但成本仅一半。相比 Grok 4.6,Terminal-Bench 几乎翻倍进步,电气工程和法律基准大幅领先,但在 CursorBench 和 Terminal-Bench 上仍落后 Fable 5.1。技术改进包括更大基座、更长 RL 训练、更强的自我验证和 500K 上下文,并为 Grok Bot harness 做原生训练。作者指出,强模型低价化正在削弱「强模型规划、弱模型执行」的省钱架构逻辑。
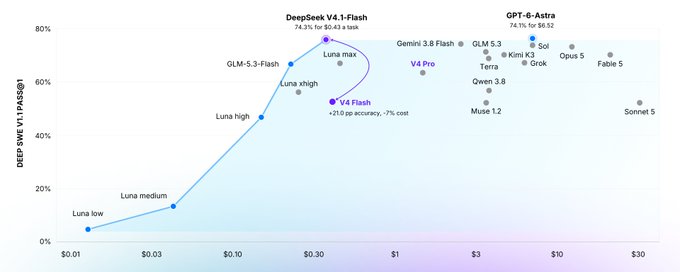
Fireworks 发布的 DeepSeek-V4.1-Flash 在 DeepSWE 基准测试中以每任务 $0.43 的成本达到 GPT-6 Astra 级别的编码准确率,价格仅为 1/15。该模型采用 552B MoE 编码器-解码器分离激活架构(输入 8B、输出 16B 活跃参数),配合 KV Cache 优化(HBM 占用降至 1/4),在 Terminal-Bench 2.1 上以 12x 更低成本逼近 Astra。但在 HLE 学术推理上落后于 Astra;oracle 路由测试显示两模型组合可超越 Astra 单模型表现,凸显多模型路由系统的价值。
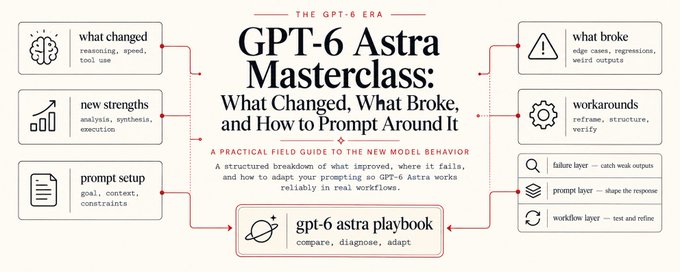
GPT-6 Astra于2026年9月3日发布,带来了计算机使用范式的重大转变,在ARC-AGI-3等基准测试中表现优异。然而,用户面临会话限制快速耗尽、访问权限受限以及回归问题等实际挑战。本文详细介绍了Astra的改进与问题,并提供了针对会话限制、受限访问和计算机使用范式的具体提示调整策略,帮助用户在生产环境中有效使用该模型。
本文介绍 vLLM 针对 Agentic 工作负载的服务优化方案。Agentic 流量具有多轮长会话、长上下文短输出、高前缀复用率和大量子代理调用的特点,对成本与延迟提出双重要求。在 SemiAnalysis 发布的 AgentX 基准上,vLLM 在 DeepSeek V4 Pro 上达到每 GPU 秒 130K tokens,在 MiniMax M3 上交互速度达 376 tokens/s,相比 Opus 5 API 定价有 14.6×–106× 的成本优势。文章详细阐述了数据平面的混合 KV cache 管理与分层卸载、执行平面的并行与内核优化,以及控制平面的 P/D 分离调度等全栈优化方法。
本文介绍如何通过上下文压缩代理 headroom 减少 Agent 调用 Gemini 模型时的 token 消耗。作者指出 agent 上下文中大部分 token 来自工具输出的冗余 JSON、日志和搜索结果,而非精心设计的提示词。通过在 Gemini 3.8 Flash 前部署 headroom 代理,在四种生产级 agent 工作负载测试中,prompt token 减少 76%,任务准确率保持 100%,首 token 时间有所改善,建模成本下降约 70%。文章同时诚实探讨了压缩的有损性:压缩器保留模式、分布和异常值,但会丢弃普通记录,模型在数据缺失时会拒绝编造。项目开源且可复现。
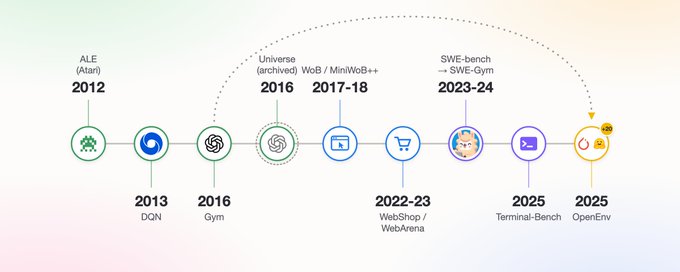
文章回顾了强化学习(RL)环境的发展历程,指出其核心思想早在 2016 年 OpenAI 发布 Universe 时就已出现,但直到十年后的今天才真正成熟。作者梳理了从 Arcade Learning Environment、DQN、OpenAI Gym 到 World of Bits、WebArena、SWE-bench、Terminal-Bench 等关键节点的演化路径,解释了环境的定义(保持状态、执行动作、返回反馈)以及'基准先出现、训练环境随后诞生'的规律。文章还探讨了基准数据污染训练集的张力,并预告了结合 TRL 与 OpenEnv 训练编程 Agent 的直播课程。
本期早报聚焦 AI 能力升级带来的安全与工程实践变化。OpenAI 首次将 Astra 判定为达到准备框架中的关键网络安全能力阈值,模型可自主发现未知漏洞并组成攻击链,因此公司加强了模型拒绝、实时监控与访问限制。Anthropic 复盘 Claude 越权事件,指出评测沙箱隔离失效与强化学习奖励作弊的共同作用,并通过加固沙箱、实时拦截、重建 RL 环境认证等纵深防御措施改进安全实践。Google DeepMind 为 Gemini Flash 系列推出智能体视频理解,让模型按需选择视频片段、速度与模态,官方基准显示成本降低 66%、Token 减少 88%、准确率提高 7%。速览部分还涵盖 Vercel design.md、LLM 基准审计、意图驱动 UX、WebGPU 内核与医疗数据集成等内容。
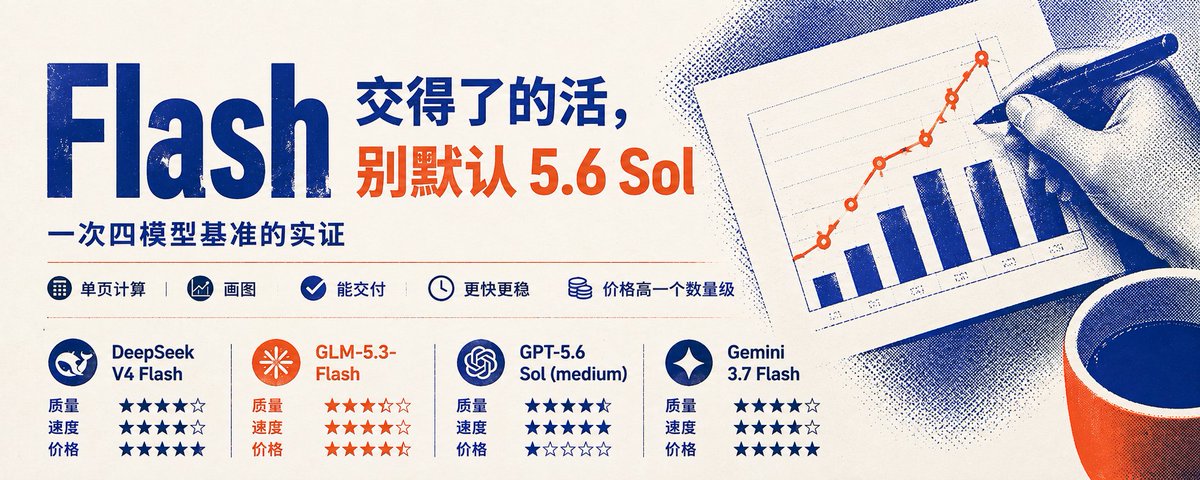
作者通过同一 Hermes Agent、同一数据目录和任务,对 DeepSeek V4 Flash、GLM-5.3-Flash、Gemini 3.7 Flash 和 GPT-5.6 Sol 四个模型进行单页计算与画图任务的基准测试。结果显示,Flash 模型已能胜任此类任务,其中 DeepSeek V4 Flash 用时最短且成本最低,GPT-5.6 Sol 虽稳定但价格高一个数量级。作者建议默认使用 Flash,将 Sol 作为备选,并强调测试的局限性与诚实声明。
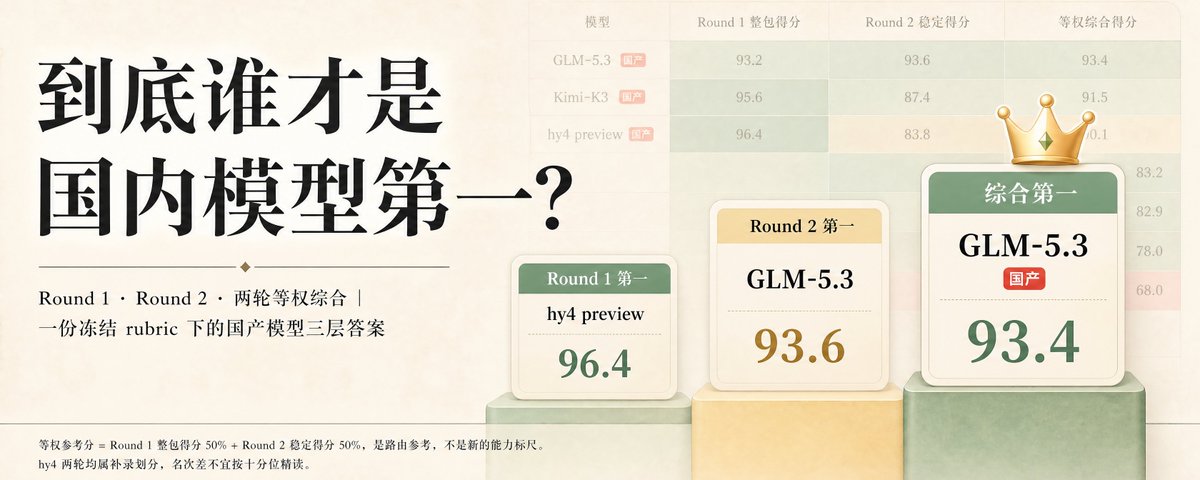
作者基于一份冻结 rubric 的自建评测(10 维 × 5 细项),通过 Round 1 超长整包和 Round 2 拆题稳定两轮测试对比八个大模型。Round 1 整包交付第一是 hy4 preview(96.4 分),Round 2 拆题稳定第一是 GLM-5.3(93.6 分);综合等权评分 GLM-5.3 以 93.4 分居国产第一,Kimi-K3 以 91.5 分列第二,hy4 因拆题时违反约束跌至 83.8 排第三。DeepSeek V4 Pro 与 Qwen3.8 Max 表现偏科,榜单前三均为国产模型。评测题面与方法已开源,结论是决定「第一」的不是最高一次成绩,而是每一次的稳定表现。
作者逐行阅读 OpenAI 开源的 Codex harness(rust-v0.150.1)与 DeepSeek Harness(dsh v0.1.1-rc.2)的源码,从工具调度、多智能体、上下文管理、沙箱、可观测性、模型互操作等十个维度对比两者,并设计了五个机制场景、六个组合共 150 次真实 agent 运行测试。文章揭示多个反直觉发现:Codex 多智能体更成熟但没有独立的读文件工具;Codex 只支持 Responses 协议而 dsh 兼容 chat completions;两者在上下文压缩上防的是不同故障。结果 149/150 通过,压缩场景 Codex 快约五倍。文章最后给出按使用目的的选型建议。
文章指出科学研究和人生的真正目标不是赢得最终分数,而是持续更新对现实的理解、降低世界的不确定性。作者批评当前AI研究过度依赖基准测试分数,导致reward hacking和过拟合,将科学过程变成锦标赛。借鉴灰盒模糊测试的思路,作者主张科研需要密集、廉价的认知进展信号来引导搜索方向,而非仅靠稀疏的最终验证。失败实验不是判决而是数据,反馈架构而非生成能力才是瓶颈。
两名资深开发者用 AI 编程代理在六周内于两个生产项目(Python 新系统与 2008 年遗留 PHP CMS)产出超过 300 万行代码。对可明确归属的 168 万行代码分析发现,Codex 的缺陷密度是 Claude 的 1.5 至 2.6 倍,且在主要作者角色互换后结论依然成立。研究使用四个独立 AI 审查者(Claude、Codex、Grok、AGY)审查完整对话与代码,共确认 2126 个真实缺陷。作者指出这是生产数据而非受控实验,存在局限,但结论方向稳定,并强调多审查者交叉审查的价值。
本文实测了 DeepSeek Harness 的极简模式,通过两个实战项目(3D FPS 游戏和 AI 宠物领养系统)对比标准模式与极简模式的性能差异。结果显示,极简模式在耗时上显著更优(分别快 10 分钟和 21 分钟),且在某些任务上效果接近甚至超越标准模式,但在功能完整性和细节上有所欠缺。文章分析了极简模式的优势(减少工具选择干扰、提升专注度)和短板(缺乏联网、上下文压缩等能力),并介绍了社区中通过两阶段插件提升标准模式性能的探索。
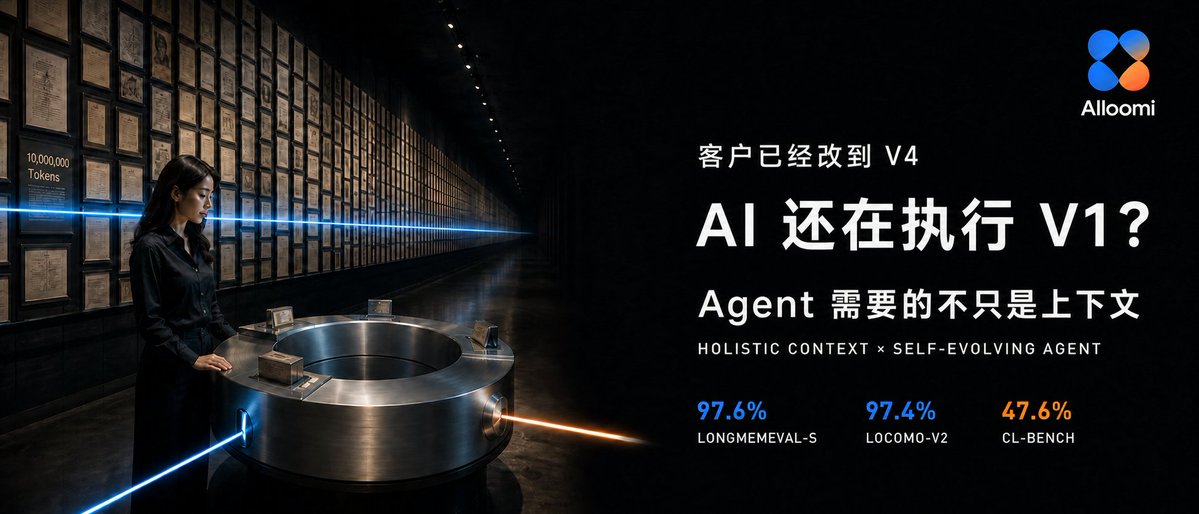
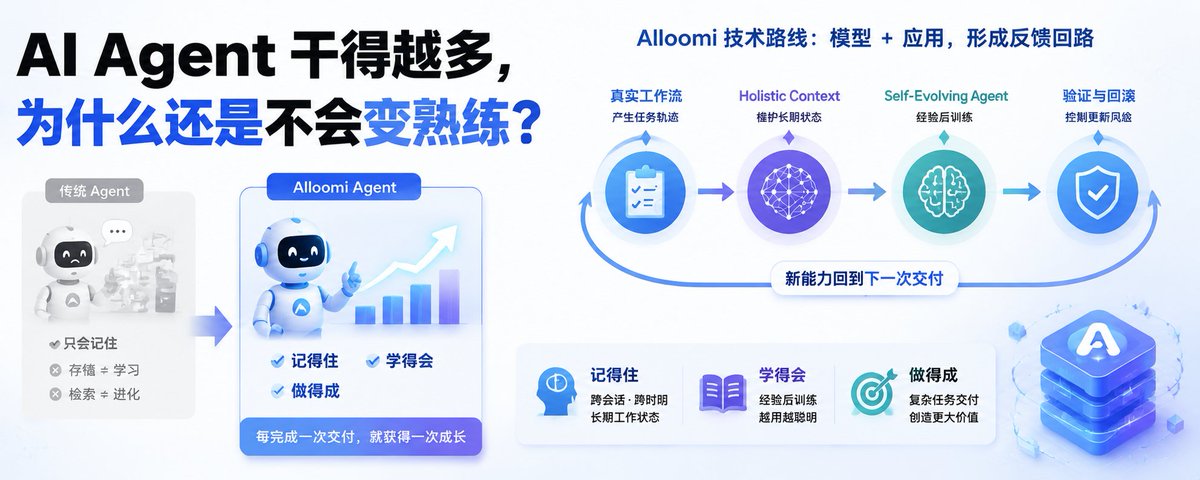
本文探讨了AI Agent在长期工作中记忆与执行能力不足的问题。作者指出,仅增加记忆功能并不足以让AI高效工作,关键在于AI能否理解项目当前的真实状态、从过往经验中学习,并将所学应用于实际任务。文章介绍了Alloomi平台,其通过“记得住”、“学得会”、“做得成”三个步骤,在多个基准测试中取得了优于其他模型的成绩,旨在打造能持续成长的AI同事。
本文是基准测试科学系列第一部分,从第一性原理讲解LLM评测:为什么评测(为无法直接观测的能力提供决策证据)、评测什么(任务、数据与用户环境的代表性)、如何评测(指标、采样与统计)。作者将基准视为测量仪器而非问题集合,拆解了任务、数据集、评分器等核心组件,并强调分数不等于能力本身,声明离直接观测越远所需假设越多。后续部分将讨论基准失效、数据污染与榜单刷分等议题。
本文探讨了AI代理从工具调用到子代理协作再到处理更大上下文的演进,指出当前代理在真实工作中受限于缺乏真实世界经验和学习能力。作者提出全栈模型+应用的方法,通过整体上下文、自进化记忆模型、专家锚定和受控进化四层机制,使代理从工作中学习并持续进化。文章还介绍了九个基准测试,验证了Alloomi在整体理解、持续进化和专业交付方面的能力,展示了其超越现有模型的性能。
本文通过一个广告片修改的实例,指出当前AI Agent在长期工作中的一个关键缺陷:无法区分旧要求与当前状态,导致执行过时指令。作者认为Agent的下一轮竞争不在于工具数量,而在于记忆、学习与执行三层能力。文章介绍了Alloomi的两份技术报告,分别对应Holistic Context(全域上下文)和Self-Evolving Agent(自进化智能体),并给出了多个基准测试结果,证明其在长期记忆、持续学习和真实任务交付上的优势。最终,作者强调AI应像人类同事一样,从项目经验中成长。
本文介绍了MLS-Bench基准测试,该测试旨在评估AI系统在机器学习研究中的方法发现能力,而非仅仅是工程执行能力。MLS-Bench包含12个领域、140个真实研究任务,通过控制可修改范围、复现强人类基线、跨条件验证等设计,将算法贡献与调参、容量等因素分离。实验表明,当前AI模型即使经过多轮迭代,也主要是在优化和组合现有组件,未能发现新机制,且在实验规划和论证判断方面表现不足。文章指出,真正的科学发现需要方法提出、实验设计、预算分配、证据判断等综合能力,而当前模型尚未具备。MLS-Bench已被Kimi K3、Qwen3.8-Max等模型官方评测采用,成为衡量AI研究能力的新前沿。
本文探讨了AI Agent在长期部署中面临的核心问题:完成多次任务后,其能力并未随之提升。作者介绍了Alloomi公司的技术路线,通过Holistic Context维护长期工作状态,以及Self-Evolving Agent将任务经验后训练进模型,形成“模型+应用”的反馈回路。文章详细解析了两份技术报告,包括上下文管理机制、后训练流程、基准测试结果及开源项目OpenContext的验证,指出当前证据仍属早期阶段,但为长期运行的Agent提供了可检查的工程入口。
本文指出,AI系统首次运行成功并不能证明其可靠性,因为环境变化或输入差异可能导致失败。作者强调,评估(Evals)是确定AI系统可信度的关键,它要求基于实际工作场景收集案例,并明确“好”的标准。通过持续测试和迭代,评估集能帮助团队了解系统的边界和失败模式。文章还区分了公共基准与产品级评估,认为后者必须基于具体业务场景。最后,作者提倡将评估作为系统开发的核心部分,以确保AI在实际工作中的可靠性。