Wiki 知识库

全部文档 / 标签: KV Cache

43 篇
清除

AI 的流量超过人类之后,搜索也要重做一遍

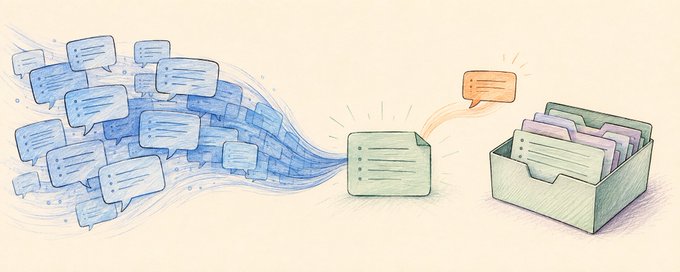
Cloudflare 数据显示 AI 自动化流量首次超过人类(57.5% vs 42.5%)。文章分析搜索用户从人、到大模型、再到 Agent 的三次演变,指出 Agent 场景下搜索的三大卡点:结果需可直接用、信源要可信、速度要快。腾讯「元宝搜索」通过提供完整正文、接入 157 个权威信源、索引期压缩网页为 100 token 支持 KV Cache 复用等优化,使 Agent 完成任务的平均搜索调用从 8 次降至 5 次。作者实测 9 个品类 31 条 query,认为其强项为权威性、时效性和正文提供能力,适合国内 Agent 开发者,但学术论文、生活服务等场景需配合垂类 API。文章最后介绍了三种接入方式与按量计费价格。

技术 › Agent Orange AI 2026-10-258.4 KB 6.4K 21 81

Cerebras 如何部署万亿参数前沿模型

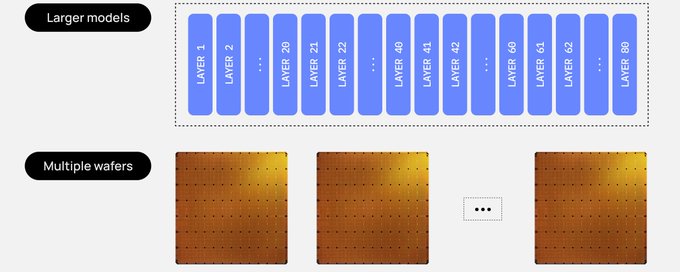
Cerebras 团队详细介绍了如何在 WSE-3T 晶圆级芯片上部署万亿参数大模型。以 3 万亿参数的开源模型 Kimi K3 为例,团队通过 4-bit 权重量化和 8-bit KV 缓存计算每层约 16 GB 的显存需求,将模型切分到 59 片晶圆上:每个 dense 层独占一片晶圆,每片可放两个 linear-attention 层。晶圆间通过以太网 RDMA 传递激活值,权重无需移动。系统以流水线方式运行,各阶段可同时处理不同请求和微批次,从而实现 1000-2000+ tokens/秒的推理速度。
技术 › LLM Sarah Chieng 2026-10-239.9 KB 282.4K 816 85

DeepSeek V4.1 Flash 大规模推理部署实践

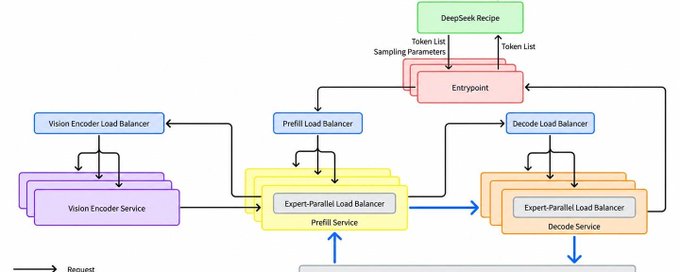
文章介绍 DeepSeek V4.1 Flash 大规模推理系统的部署实践与开源推理框架 DeepInfer。系统设定三大目标:兼容多厂商计算芯片、基于通用硬件组织 Prefill 与 Decode(8 卡机 Prefill、64-128 卡超节点 Decode)、支持 KVCache 保留 72 小时以上以实现上下文复用、减少冗余计算。团队通过在计算、通信、调度与存储上的持续优化,在满足延迟要求下提升有效吞吐。DeepInfer 集成高性能算子与深度优化推理引擎,支持分布式推理、投机解码、SWA Bounded Replay 和结构化输出等能力。目前单集群服务吞吐达每天 155 万亿 tokens,整体收入为每卡每小时 38 美元(按低谷价格计)。

技术 › 后端 Latent.Space 2026-10-2182.1 KB 92.6K 432 69

MacOS 本地部署 Qwen-Image 2.1 提速将近五倍!怎么做到的?(推荐收藏)

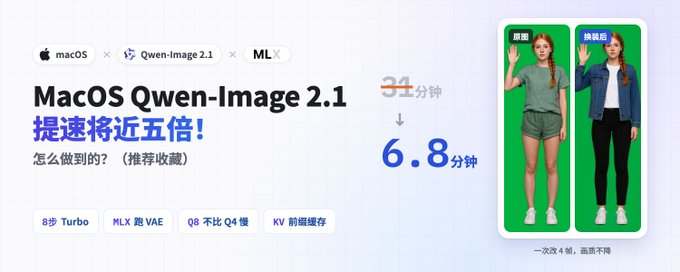
作者分享了在 M2 Pro Mac 上将 Qwen-Image 2.1 改图时间从 30 分钟压到 6.8 分钟(提速4.5倍)的完整方法论。首先通过耗时拆解定位瓶颈,然后叠加四个优化点:换用 Turbo 模型将去噪从20步降至8步;将 VAE 编解码切换到苹果 MLX 框架,从315秒降到15秒;实测发现 Q8 与 Q4 量化在扩散模型上速度相同,因此选用画质更好的 Q8;利用块因果结构实现前缀 KV 缓存,使每步采样时间减半。作者还用该流水线完成了一段10秒视频的逐帧换装,并通过肤色基准校正、锚点补偿和时序平滑三层方案解决了误差累积问题。

技术 › 工具与效率 WquGuru 2026-10-1311.0 KB 16.6K 87 88

AI 工程师面试:大厂反复考的 25 道通用题

文章总结了 AI 工程师面试中各科技大厂(OpenAI、Meta、DeepSeek、Anthropic 等)反复考察的高频题目,覆盖三大模块:LLM 内部原理(attention、KV cache、RoPE、MoE、scaling laws、解码策略等)、推理部署与 GPU 性能(continuous batching、PagedAttention、量化、并行策略、显存估算、延迟指标等),以及 RAG、Agent、微调、评测、安全、多模态、系统设计等方向。作者指出各家面试题高度重合,建议优先刷这些通用题以获得最高性价比。

技术 › LLM 山景城小路 2026-10-073.7 KB 21.2K 258 71

Disaggregated Inference From The Ground Up

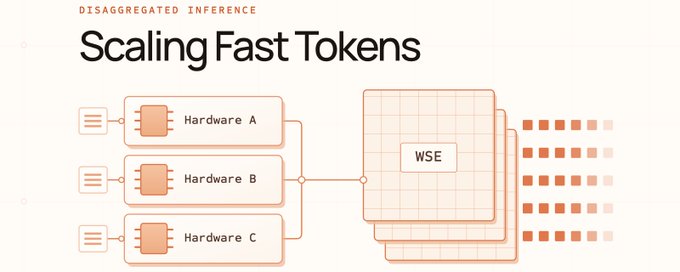
本文由 Cerebras 撰写,从基础原理讲解推理系统中的分离式推理技术。文章先介绍加速器的构成(计算单元与存储),并引入算术强度概念,通过矩阵加法与矩阵乘法的实例说明数据搬运与计算的关系。随后分析 LLM 推理的两个阶段:prefill(处理整个 prompt,计算密集型)与 decode(逐 token 生成,受限于内存带宽),解释二者对硬件需求的不同。Cerebras 提出异构分离式推理,将不同类型芯片分配给不同推理阶段,在相同硬件数量下将吞吐量提升 5 倍且不损失单用户生成速度。

技术 › LLM Cerebras 2026-10-0219.6 KB 400.2K 299 70

vLLM 架构之美:PagedAttention 与 Continuous Batching 解析

作者赞颂 vLLM 的软件设计之美。文章首先介绍 LLM 自回归生成的基本原理,以及推理的两个阶段:计算密集的 Prefill 和带宽受限的 Decode,指出 KV Cache 动态增长与静态批处理带来的内存浪费问题。vLLM 借鉴操作系统分页思想,将 KV Cache 切分为固定大小的块并维护逻辑到物理的块表(PagedAttention),将内存浪费降至约 3%;配合 Continuous Batching 和动态调度,避免已完成的请求阻塞整个批次,让 GPU 始终保持高效。作者认为 vLLM 的成功源于借鉴已被大规模验证的成熟系统概念。

技术 › LLM Atharva 2026-09-275.1 KB 21K 401 56

面向 coding agent 的 Jev 工程学

本文基于 Diogo Almeida 的设计笔记,从第一性原理重新审视 coding agent 的设计。作者以「如果没有 KV cache 会怎样设计」为切入点,揭示当前 agent 围绕缓存经济性形成的「只追加对话记录」范式的六大症状:路由失效、工具挤占上下文、压缩有损、子 agent 平庸、重启丢状态、内置能力争论。文章指出 token 主要消耗在读取与搜索而非写代码,并提出以 Jev 决策层为核心的方案:元注意力上下文组装、查询感知压缩、可见性阶梯、可编程权限、安全感知路由与三级工具披露,把上下文当作被有意组装而非偶然累积的对象。

技术 › Harness Engineering yibie 2026-09-2216.5 KB 8.9K 57 83

LLM Inference Handbook 精读:Prefill、Decode、KV Cache,与一切皆权衡的推理工程

本文深度解读 Modular 公司开源维护的《LLM Inference Handbook》,系统梳理 LLM 推理工程的知识体系。文章提炼三大核心框架:prefill(算力受限)与 decode(带宽受限)的两阶段二分法;KV cache 作为系统中心约束的地位,围绕它的 PagedAttention、prefix caching、PD 分离等技术网络;以及“一切皆 trade-off,唯一方法论是 benchmark”的工程哲学。内容还涵盖 continuous batching、speculative decoding、GPU 内存金字塔、FlashAttention、量化与蒸馏三部曲、Agent 生态与部署运维等主题,强调推理优化的本质是围绕有状态 KV cache 做内存管理与调度。

技术 › LLM meng shao 2026-09-2218.3 KB 14.6K 139 84

Loop Engineering for Sub-Dime Agents: Cutting Token Costs in AI Coding Harnesses

本文探讨如何通过循环工程降低自主编码 Agent 的 Token 成本。以一个 5 轮 PR 修复任务为例,未优化的 Harness 消耗 81,000 tokens($1.53),而优化后仅需 12,050 tokens($0.042)。核心机制包括:稳定的系统前缀以最大化 KV 缓存命中;基于 AST 的工具输出压缩,仅提取代码骨架;沙箱确定性工具预检与自动修复,避免浪费 LLM 推理;MCP 工具 Schema 的按需懒加载与 Code-Mode 执行;以及双层级模型路由(Workhorse 处理机械性任务,Frontier 处理复杂规划),并定义了四种确定性升级触发条件,实现亚角级(sub-dime)任务成本。

技术 › Harness Engineering Balaji Subramaniam (Google Cloud) 2026-09-2211.8 KB 49.6K 359 90

深读免费书「Inference Engineering」:Prefill 吃算力、Decode 吃带宽,讲透从 CUDA 到生产部署的推理优化

文章深度解读 Baseten 出版的免费工程书《Inference Engineering》,系统讲解如何把 AI 模型在生产环境中跑得快、省、稳。全书以三层推理栈(运行时、基础设施、工具层)为骨架,核心分析框架是瓶颈判断:prefill 算力受限、decode 带宽受限、图像视频生成算力受限。内容涵盖模型与硬件理解(算术强度、KV cache、选卡策略)、软件栈(vLLM/SGLang/TensorRT-LLM 三大引擎对比)、五大加速技术(量化、投机解码、缓存、并行、分离部署)及其交互关系,以及生产化部署的延迟全栈账本、故障处理与成本核算,强调约束换性能、技术按组合评估等基本原则。

技术 › LLM meng shao 2026-09-2111.2 KB 13.1K 145 84

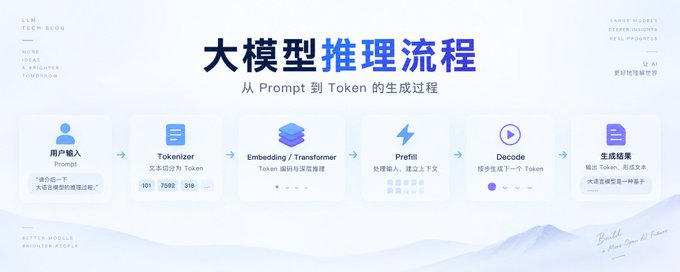
一文了解大模型推理流程

文章系统讲解大模型推理的完整流程:输入文本先经Tokenizer切分为token并转换为token id,再通过Embedding转为带位置信息的语义向量;随后进入Prefill阶段,模型并行处理整个prompt,通过Transformer的Self-Attention计算Q、K、V并生成KV Cache,经Causal Mask确保不偷看未来token;最后经LM Head和softmax输出第一个token。进入Decode阶段后,逐个生成token、不断更新KV Cache,直到满足EOS、max_tokens或stop条件终止,最终反解码为文本输出。

技术 › LLM Jerry Fang 2026-09-184.9 KB 1.4K 8 53

LLM Inference After Training: Prefill, Decode, KV Cache

本文系统讲解 LLM 推理阶段的核心原理。作者指出推理与训练不同,分为 prefill 和 decode 两个阶段:prefill 并行处理整个提示词、计算密集型、决定首 token 延迟(TTFT);decode 逐 token 生成、受 HBM 内存带宽限制、决定 token 间延迟(ITL)。文章介绍了 GPU 关键硬件概念(Tensor Core FLOPS、HBM、SRAM),逐步演示一个请求的完整流程(分词、采样、KV cache 机制),并将 FlashAttention、PagedAttention、continuous batching、RadixAttention 等优化技术归位到这两个阶段中,帮助读者理解推理瓶颈与优化方向。

技术 › LLM Karan 2026-09-1713.8 KB 29.4K 187 83

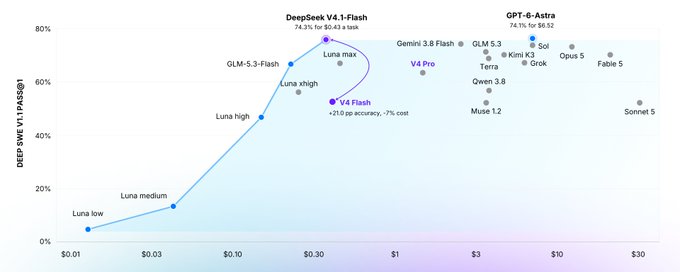
DeepSeek-V4.1-Flash on Fireworks: Astra-level DeepSWE at 1/15th the cost

Fireworks 发布的 DeepSeek-V4.1-Flash 在 DeepSWE 基准测试中以每任务 $0.43 的成本达到 GPT-6 Astra 级别的编码准确率,价格仅为 1/15。该模型采用 552B MoE 编码器-解码器分离激活架构(输入 8B、输出 16B 活跃参数),配合 KV Cache 优化(HBM 占用降至 1/4),在 Terminal-Bench 2.1 上以 12x 更低成本逼近 Astra。但在 HLE 学术推理上落后于 Astra;oracle 路由测试显示两模型组合可超越 Astra 单模型表现,凸显多模型路由系统的价值。

技术 › LLM Fireworks 2026-09-169.1 KB 24.1K 200 75

Prefill and Decode:理解 LLM 推理的两个阶段

文章以'读长文档只要三条结论为何很慢,写两千字演讲稿反而很快开口'为切入点,讲解 LLM 推理的 prefill 与 decode 两个阶段。Prefill 并行处理全部输入 token 并保存 KV cache,决定首 token 延迟(TTFT);decode 自回归地逐个生成 token,受内存带宽影响,影响 token 间隔(ITL)。文章进一步介绍 chunked prefill、prefill/decode disaggregation 和 prefix caching 三种优化手段,并以 EXO 用 DGX Spark 做 prefill、Mac 做 decode 的演示说明跨设备分工的可能性,帮助读者具体分析 AI 响应慢的原因。

技术 › LLM Dongxi 东锡 NLP 2026-09-1511.3 KB 24.8K 89 74

显存就这么多,怎么把字吐得更快?——从 MoE、KV Cache 到 DFlash 的本地部署全景拆解

文章从一张16GB显卡出发,系统拆解大模型本地部署的显存与速度权衡。首先澄清运行显存不只包含模型权重,还有KV Cache、运行时工作区和草稿模型开销;解释MoE与量化对容量和计算的不同影响,区分总参数与激活参数;分析CPU/GPU卸载的代价;介绍KV Cache与混合注意力如何影响上下文长度;区分Prefill与Decode两个阶段的速度特征;最后详解投机解码、MTP与DFlash/DFlash2的加速原理及实测收益。强调各优化手段需配合使用,预算刚好装满并不代表能稳定运行。

技术 › LLM huangserva 2026-09-1423.1 KB 9.9K 69 84

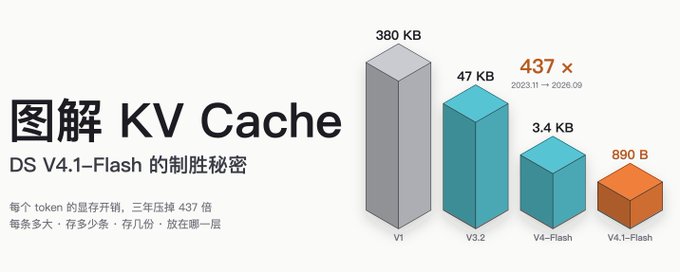
图解 KV Cache——DS V4.1-Flash的制胜秘密

本文图解 DeepSeek V4.1-Flash 如何将单 token 全局 KV Cache 从 V1 的 389KB 压缩至 890 字节。文章先介绍 KV Cache 原理与显存瓶颈,再梳理 GQA、MLA、量化、稀疏注意力、跨层复用等六次关键突破,最后详解 V4.1 在架构、精度、部署三层的联合优化,包括 CED、CSA2 三模式、层级稀疏索引器与 FP4 量化,并给出 890 字节的推导过程。

技术 › LLM WquGuru 2026-09-1423.6 KB 68.6K 376 83

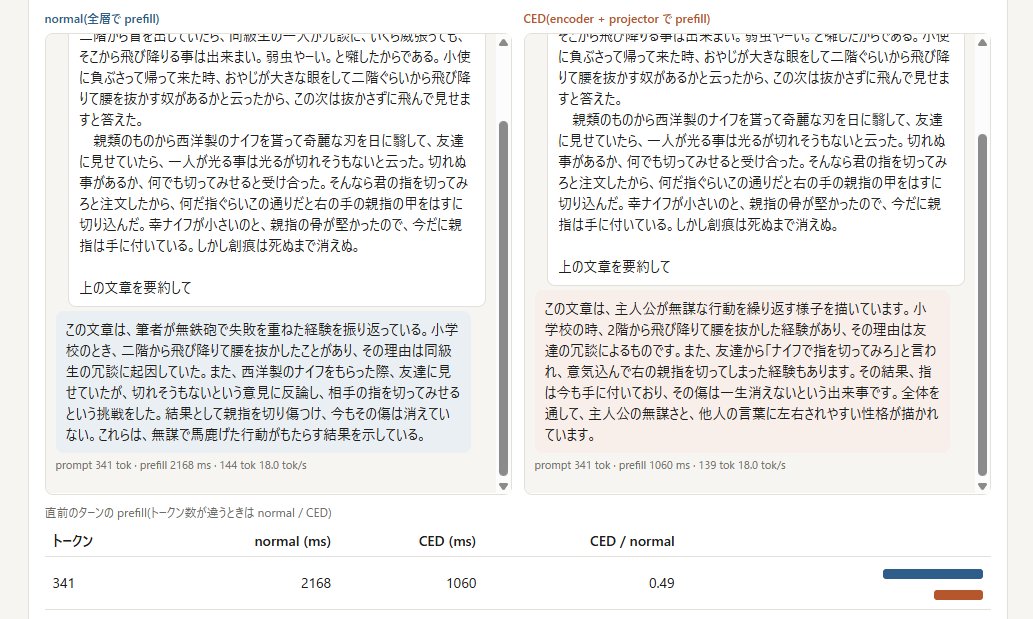
大开眼界:把 DeepSeek V4.1 Flash 的 Causal Encoder-Decoder 思路移植到 Qwen3-8B

文章介绍了一项实验:研究者将 DeepSeek V4.1 Flash 的 Causal Encoder-Decoder 机制移植到现有 Qwen3-8B 上,不修改原模型权重,仅外挂一个小模型近似后半层 KV Cache,使 Prefill 时间缩短近一半且输出一致。作者分析了这对本地模型部署(尤其 DGX Spark)的重大意义:长上下文首 token 等待明显降低,KV Cache 内存占用减少,Coding Agent、Computer Use Agent 等本地工作负载体感大幅提升。文章同时指出结果尚需在更多任务上验证,但认为已有模型可通过轻量近似层获得架构级推理升级。

技术 › LLM Wei (@wei_wang) 2026-09-135.5 KB 75

LLM 为什么缓存 K 和 V,却通常不缓存 Q?

本文深入浅出地讲解了 LLM 推理中 KV cache 的原理。作者以长文档问答为场景,说明模型生成每个 token 时无需重复计算全部历史状态,解释了为什么缓存 K/V 而不需要缓存 Q:历史 Q 已完成对应位置计算,而 K/V 需供后续新位置读取。文章还讨论了 causal attention 的信息方向如何决定 cache 失效条件、KV cache 的显存开销计算、prefix caching 复用共同前缀的策略,以及 DeepSeek-V4.1-Flash 中 causal encoder-decoder、跨层 KV 共享与 shared KV representation 等架构优化。

技术 › LLM Dongxi 东锡 NLP 2026-09-139.5 KB 196.7K 623 82

LLM 推理引擎到底是怎么工作的:从 token 到 KV 缓存、连续批处理,再到 Agent Loop

文章基于 TogetherAI 团队 Zain 的分享,沿一个请求的完整生命周期拆解 LLM 推理引擎(vLLM、SGLang、TensorRT-LLM)的内部机制。核心洞察是:prefill 计算受限、decode 内存带宽受限;KV cache 用空间换掉平方级计算,但成为显存瓶颈。引擎通过连续批处理让 GPU 每 pass 都不空闲,PagedAttention 像操作系统管理内存一样管理 KV cache(碎片率从 60-80% 降到 4% 以下),chunked prefill 摊平长 prompt 带来的延迟尖峰。Agent 循环因每轮重发完整对话、输入越来越长而输出极短,使其痛点落在 prefill 与 KV cache 上:prefix caching 可将 100 轮 agent 的总 prefill 工作量从约 55 倍降到约 10 倍,'缓存为王'是 agent 与引擎的交汇点。

技术 › LLM meng shao 2026-09-139.5 KB 46.7K 414 81

万字长文 | Agent 工程解析(一):上下文管理

文章从底层原理出发,以 Claude Code 为例深入解析大模型的上下文管理。作者指出即使上下文窗口达到 1M,上下文管理依然必要,核心原因是 KV Cache 前缀缓存机制(保证前缀一致可大幅降低推理成本)和注意力稀释问题(上下文过长过杂易引发幻觉)。文章详细拆解了 Claude Code 约 25K 系统提示词的组成,将上下文分为静态指令层、弱动态层和强动态层三层结构,并介绍了 Skill 渐进式加载、工具延迟加载、Memory 硬截断等剪枝手法,以及 CLAUDE.md 规则文件的五类分级组织形式与自顶向下的装配顺序原理。

技术 › Agent 程序员Left 2026-09-1249.6 KB 23.1K 131 86

vLLM x AgentX: Optimizing for Real-World Agentic Serving

本文介绍 vLLM 针对 Agentic 工作负载的服务优化方案。Agentic 流量具有多轮长会话、长上下文短输出、高前缀复用率和大量子代理调用的特点,对成本与延迟提出双重要求。在 SemiAnalysis 发布的 AgentX 基准上,vLLM 在 DeepSeek V4 Pro 上达到每 GPU 秒 130K tokens,在 MiniMax M3 上交互速度达 376 tokens/s,相比 Opus 5 API 定价有 14.6×–106× 的成本优势。文章详细阐述了数据平面的混合 KV cache 管理与分层卸载、执行平面的并行与内核优化,以及控制平面的 P/D 分离调度等全栈优化方法。

技术 › LLM vLLM 2026-09-0931.2 KB 41.2K 328 78

上下文压缩和记忆(nanobot)

作者介绍了 nanobot 的上下文压缩机制与长期记忆设计。上下文由 system prompt、历史消息和当前消息构成,当输入达到上下文窗口的 input budget 时,nanobot 压缩历史消息为新 summary,保留未发送的增量消息。生成摘要时通过模拟用户指令请求模型总结,并保持 system prompt 和工具定义一致以复用 KV cache 降低成本。对 OpenAI 原生压缩 API,nanobot 在加密 compaction item 之外额外生成文本 summary 供长期记忆使用。长期记忆通过 consolidator_archive 和 dream 两份提示词模板定制,用户可调整记忆筛选与整理规则,甚至整理成 skill。

技术 › Agent chengyongru 2026-09-074.9 KB 27.1K 109 74

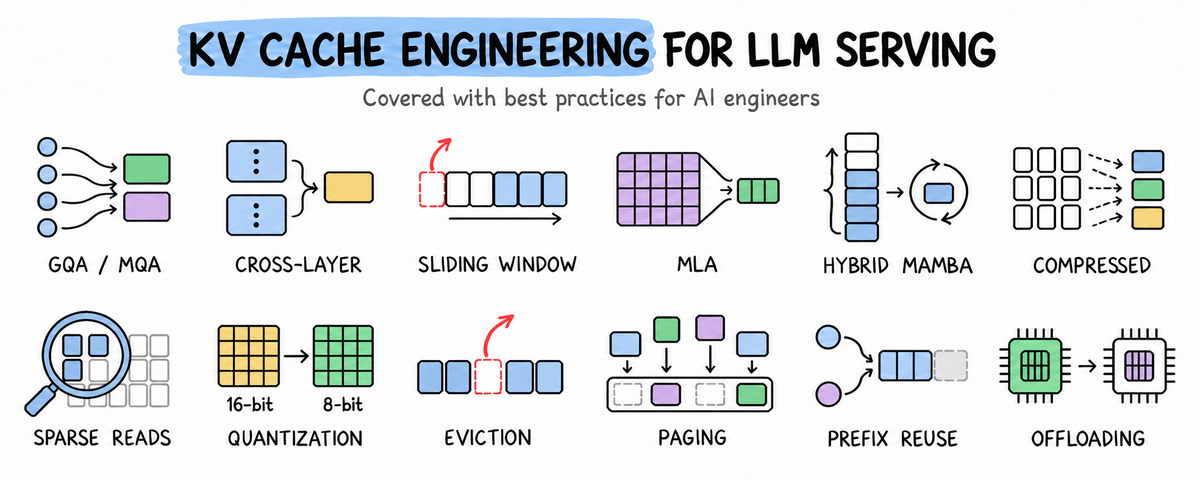
KV Cache Engineering for LLM Serving, clearly explained

文章系统讲解了LLM推理中KV缓存的工程优化。KV缓存随序列长度增长,Llama 3.1 70B单条128K序列的BF16缓存约需40GB,成为GPU内存和注意力计算的双重瓶颈。作者将12种优化技术按减少的对象分类:GQA/MQA减少KV头数量,跨层注意力减少缓存层数,滑动窗口与淘汰减少保留token数,MLA减少表示宽度,量化减少字节数,混合循环层用固定状态替代增长缓存,分页与前缀复用减少分配浪费。文章配有可运行代码示例,并分析各技术的适用场景与权衡。

技术 › LLM Avi Chawla 2026-09-0640.4 KB 206.5K 557 82

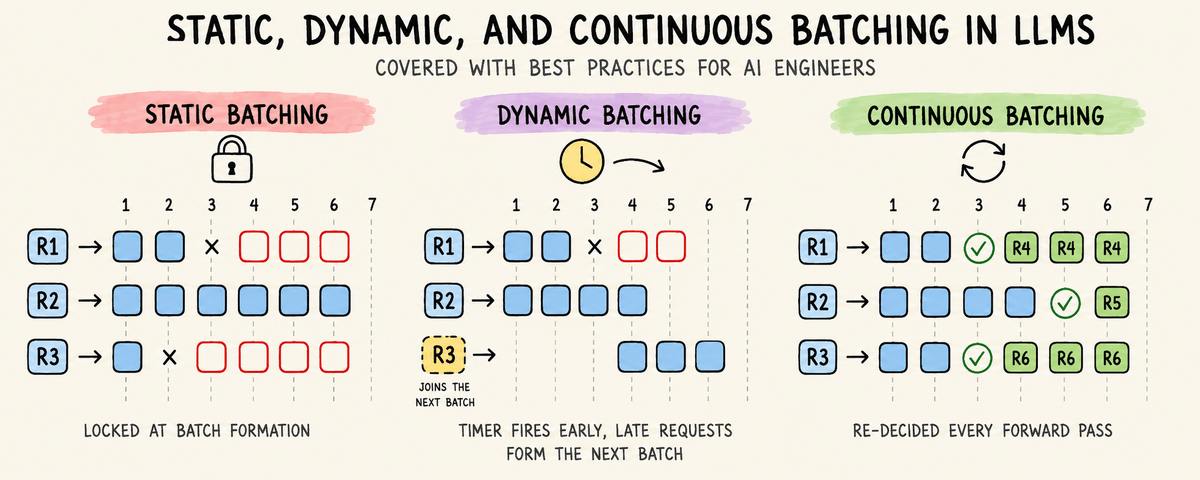
Static vs. Dynamic vs. Continuous Batching in LLMs, clearly explained

文章从第一性原理剖析了 LLM 推理服务中三种批处理策略。现代 GPU 在 LLM 解码时受显存带宽限制,计算单元大量空闲,批处理可将权重读取成本分摊到多个序列以提升吞吐。由于自回归解码的输出长度不可知、序列间相互依赖,传统批处理存在短板:静态批处理在批开始时一次决定,受最慢成员拖累;动态批处理加入定时器,缓解入批等待但仍整批绑定;连续批处理(iteration-level scheduling)在每次前向传播后重新调度,完成的序列立即让位给排队请求,是现代推理引擎高吞吐的关键。文章还讨论了固定输出场景下静态批处理的适用性,并给出 vLLM 和 Triton 的配置示例。

技术 › LLM Akshay 2026-09-0112.8 KB 57.2K 285 78

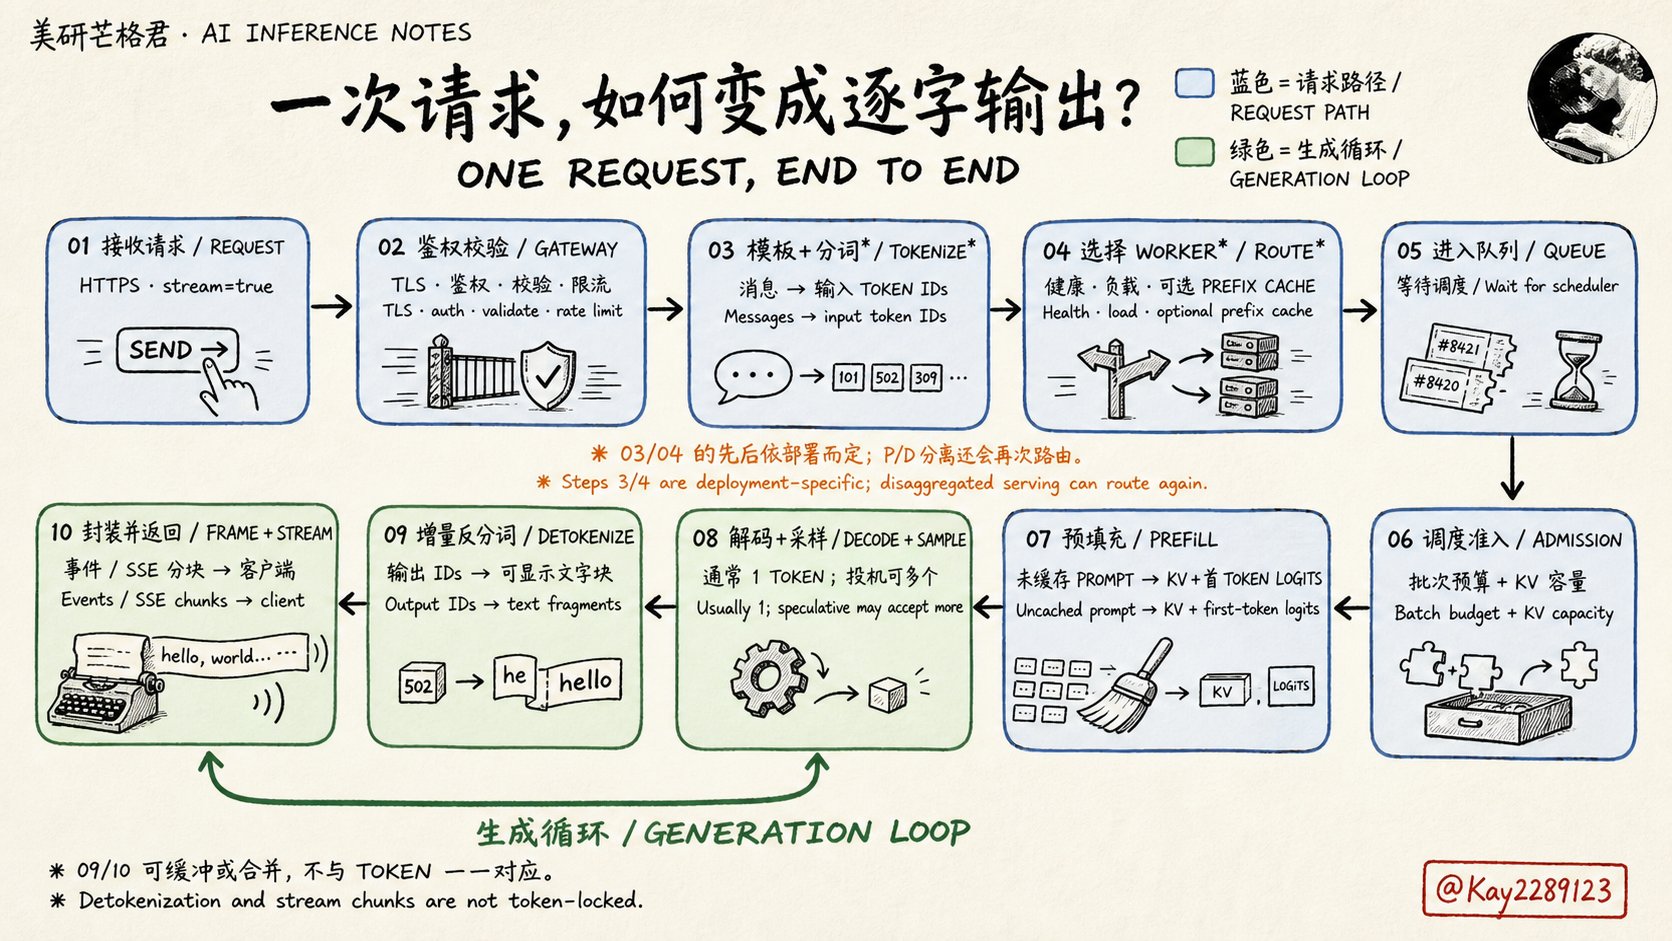
一张图讲清 AI 推理内部流程:从发送请求到首 Token 输出

作者基于在硅谷大厂面试上百人的经验,介绍 AI 推理的完整内部流程:用户发送请求后,需经过 HTTPS 鉴权、模板化分词、路由排队与 KV 容量管理,Prefill 处理完未缓存的 Prompt 后才输出首个 Token,随后进入 Decode + sampling 循环,经增量反分词、SSE 分块返回客户端。作者强调 AI 推理不只是 GPU 速度问题,首 Token 延迟取决于并发排队与 Prefill 的均衡,持续输出取决于 Decode,需优化 KV Cache 以在有限硬件资源下服务更多用户。文中还提到帮团队成员规划了从 SDE 转型 AI infra 的 12 周学习路线。

技术 › LLM 美研芒格君 (@Kay2289123) 2026-08-302.0 KB 57

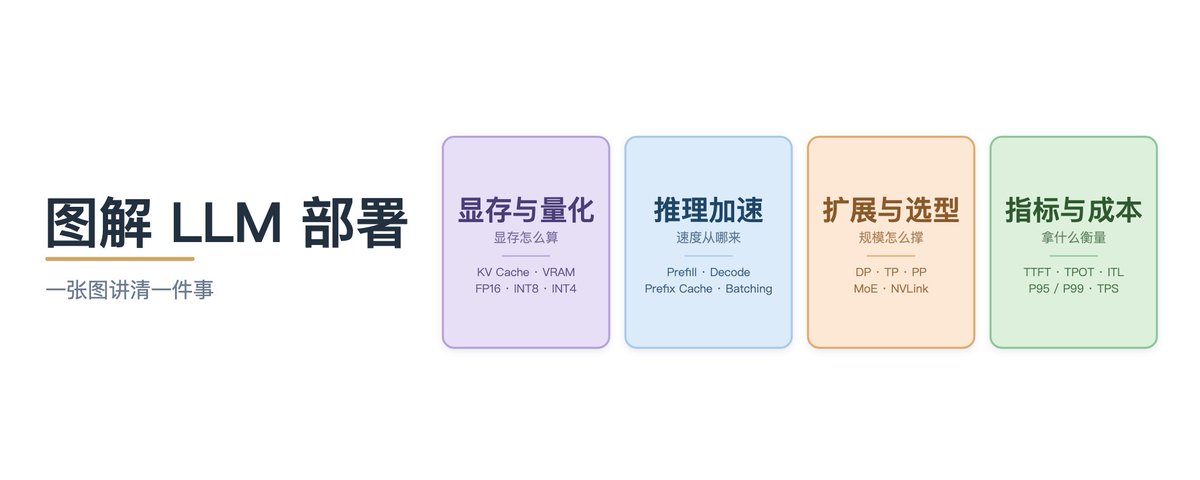
图解大语言模型部署

本文系统讲解大语言模型自部署的核心指标与实践要点,覆盖延迟类指标(TTFT、TPOT/ITL、P95/P99)、吞吐类指标(TPS、QPS、连续批处理)、资源类指标(显存与KV cache计算、量化精度)、服务质量(错误率、探针、可用性)以及成本核算(cost per token、TCO)。作者以 Ling-3.0-Flash MoE 模型在 DGX Spark 上的真实实测为例,将抽象指标落地为具体数字,帮助读者选对硬件配置、排查吞吐瓶颈与OOM问题、评估自建与API的划算临界点。

技术 › LLM WquGuru 2026-08-2927.1 KB 56.2K 199 89

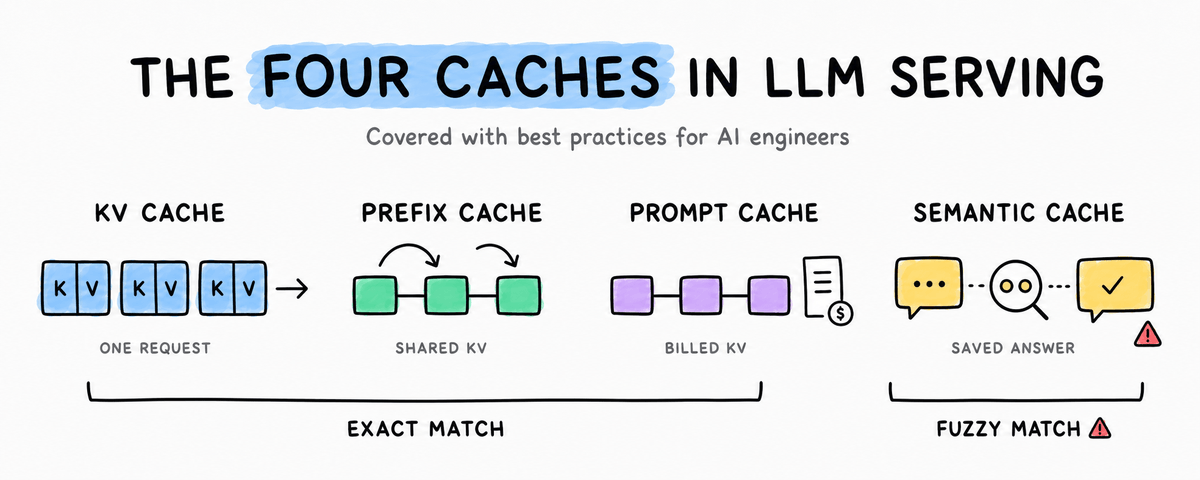
LLM 中的 KV Cache、Prefix Cache、Prompt Cache 与 Semantic Cache 详解

文章系统讲解了 LLM 推理中四层常被混淆的缓存机制:KV cache 存储单次请求的注意力张量;Prefix caching 在服务端以 token ID 哈希链为键复用这些张量;Prompt caching 是服务商对该查找的计费版本;Semantic cache 则以嵌入向量的余弦相似度为键存储完整响应。前三层为精确匹配、不影响正确性,未命中只损失延迟和费用;第四层为模糊匹配,可能返回错误答案。文章基于 transformers v5 提供可运行代码示例,涵盖缓存增长、内存带宽瓶颈、GQA/MLA/量化等优化手段,以及阻碍缓存复用的五类常见问题。

技术 › LLM Avi Chawla 2026-08-2833.6 KB 1.7M 1.4K 85

不懂 Model Infra,写不好 Harness

本文深入探讨了构建高效 Agent Harness 框架时,理解底层模型推理基础设施(Model Infra)的重要性。作者指出,许多 Harness 将模型 API 视为黑盒,导致在应用层的优化可能破坏 KV 缓存、增加成本并降低解析可靠性。文章详细分析了缓存机制(GPU/CPU/SSD)、影响缓存命中的因素(如动态 system prompt、工具 schema 变化)、本地执行耗时对缓存窗口的消耗,以及解析一致性问题。最后,作者提出了稳定前缀、异步工具执行、不可变历史等实践原则,并建议通过监控缓存命中率、一致性等指标来评估 Harness 质量。

技术 › LLM Han Cheng e/acc 2026-08-2013.9 KB 76K 245 83

长上下文缓存能复用,为什么一压缩就失真?

文章探讨了 RAG 场景中 KV Cache 复用的挑战。现有方法在长上下文下面临存储与传输瓶颈,且直接复用或简单压缩会导致位置偏移和误差放大。C2KV 通过轻量级 Extractor 将文档压缩为可拼接、位置解耦的 KV 表示,实现了显著推理加速。文章分析了其在质量、延迟和工程落地上的权衡,强调 KV 复用已演变为存储、传输和质量共同约束的系统问题。

技术 › LLM 烟花老师 2026-08-0413.9 KB 1.2K 5