Wiki 知识库

全部文档 / 作者: meng shao (@shao__meng)

65 篇
清除

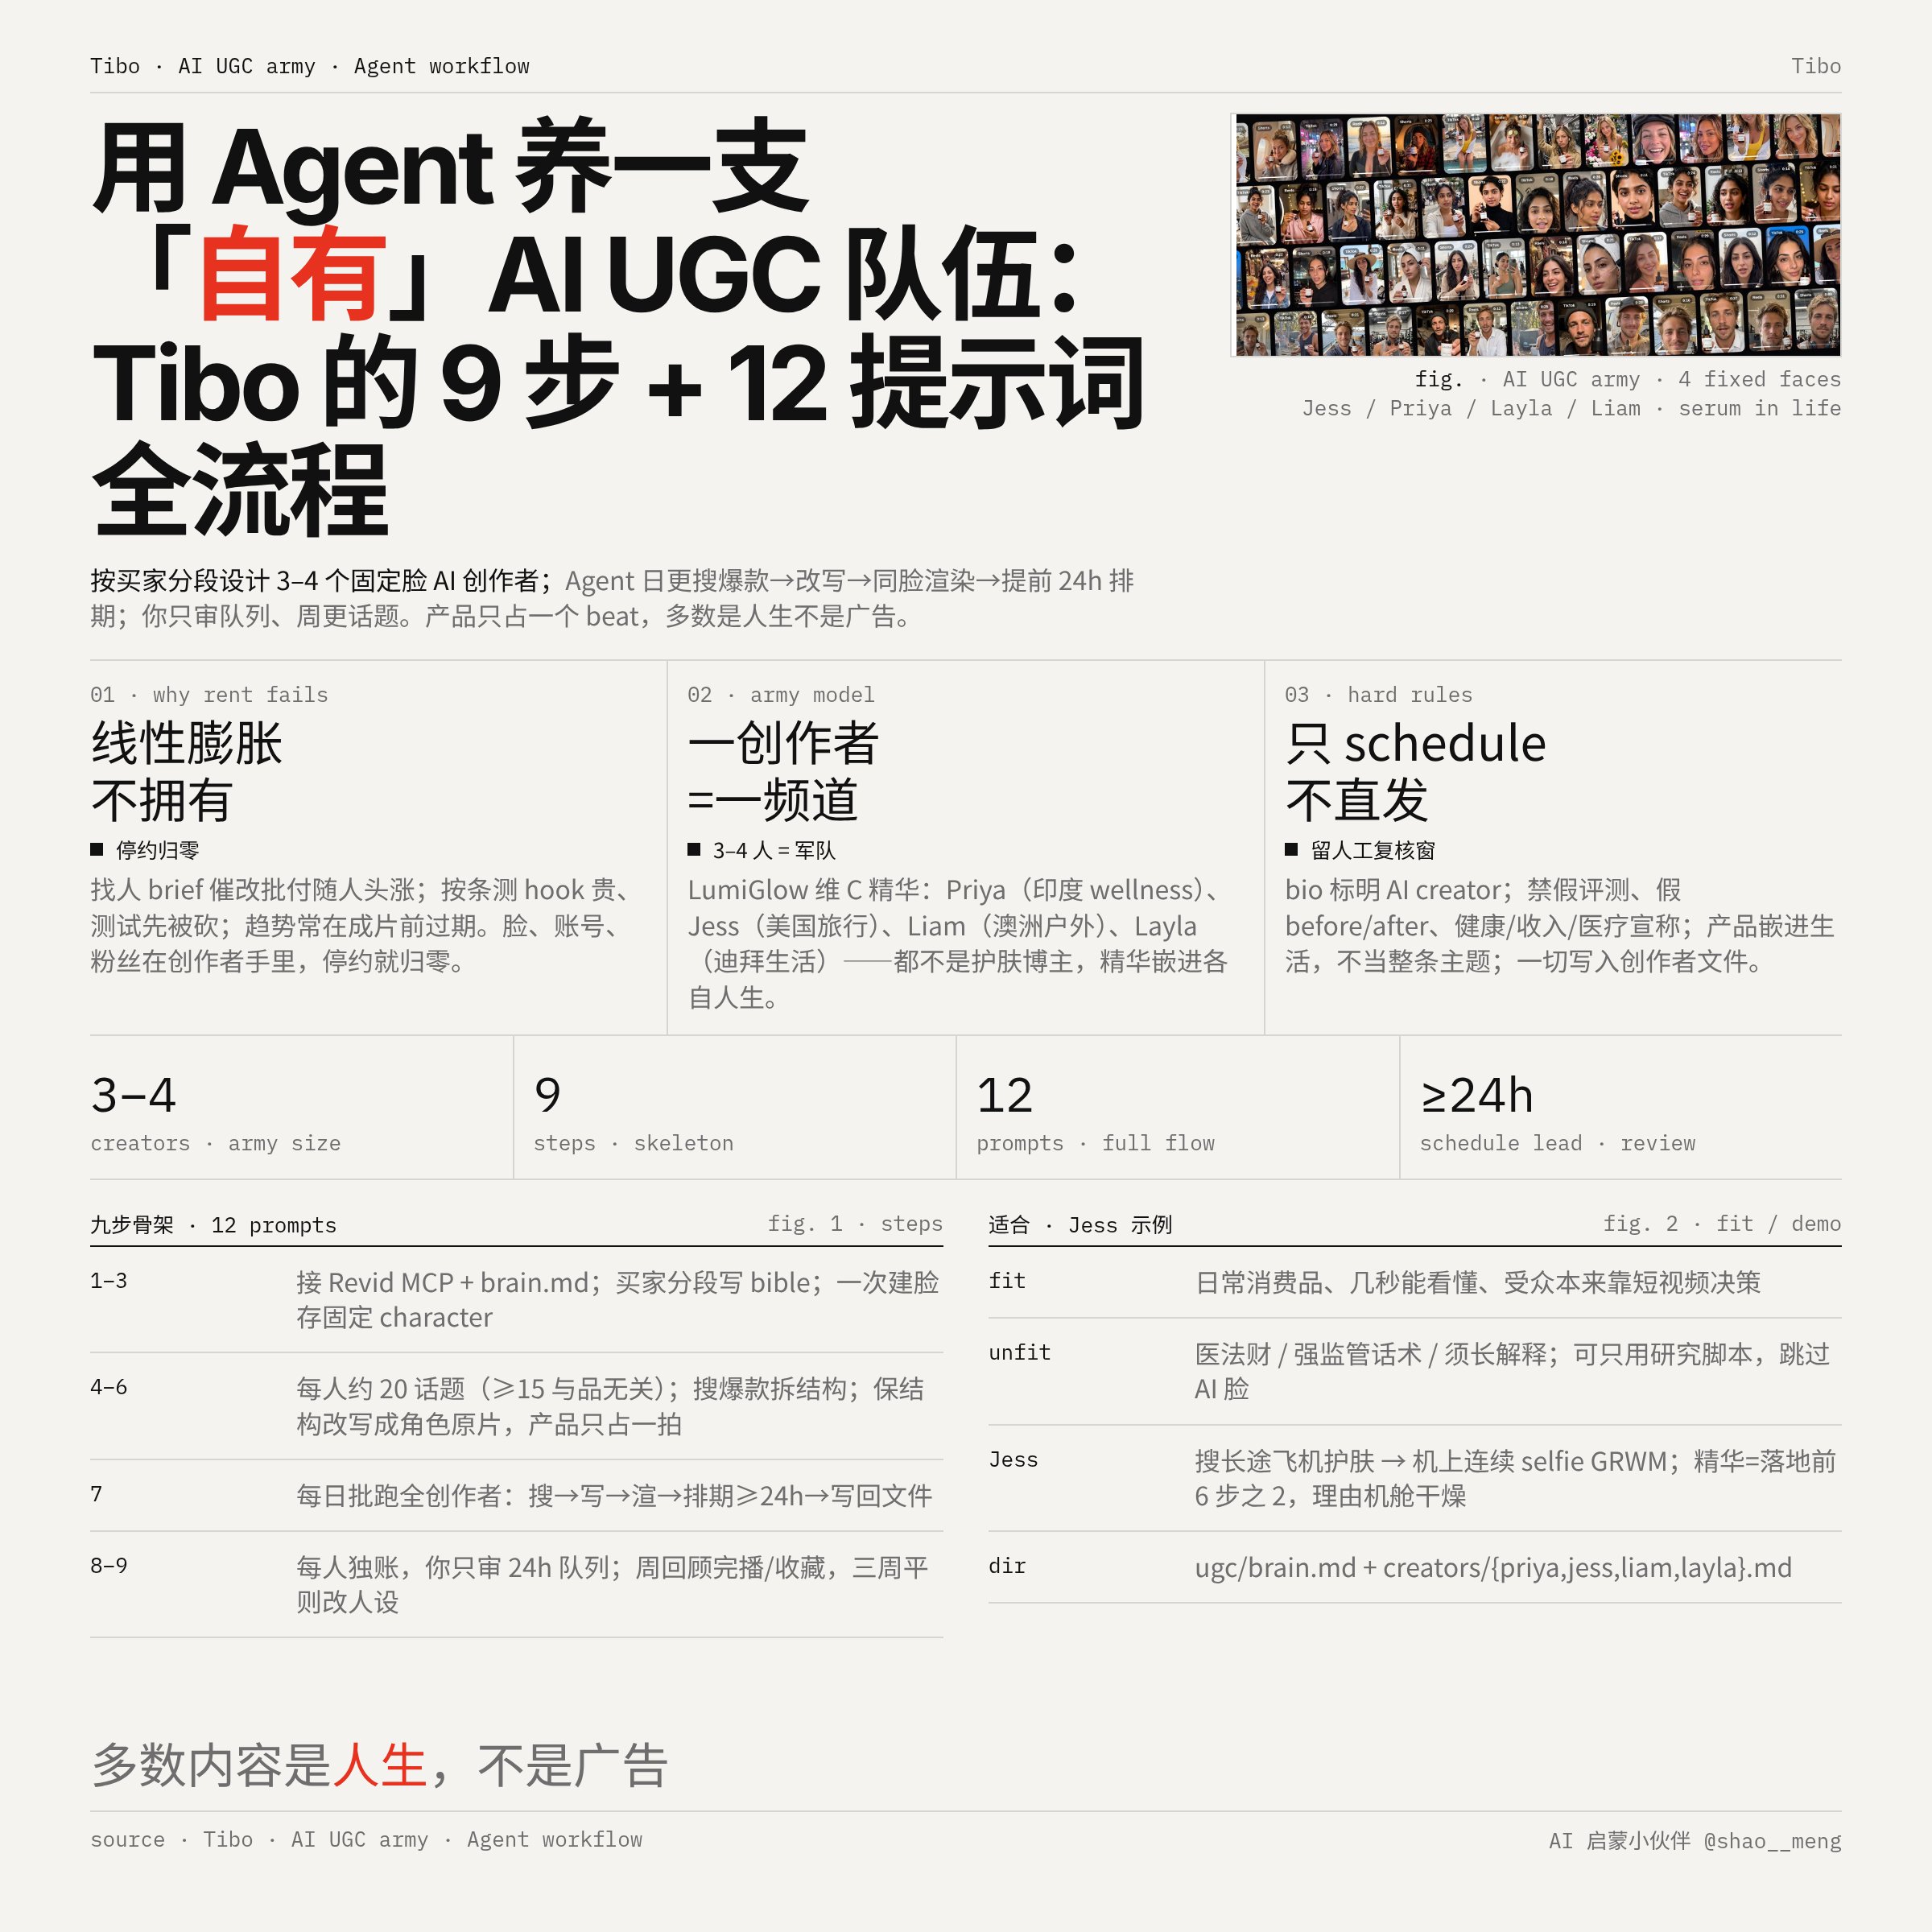
用 Agent 养一支自有 AI UGC 队伍:Tibo 的 9 步 12 提示词全流程

文章介绍如何用 Agent 搭建自有 AI UGC 创作者队伍,替代传统按条租用真人 UGC 的模式。核心做法:按买家分段设计 3–4 个有固定脸、有人设的 AI 创作者,用 Agent 每日搜索爆款短视频、改写成角色口吻、同脸渲染并提前 24 小时排期,人工只审队列和周更话题。产品只占视频一个节拍,多数内容是人生而非广告。文中详述 9 步流程与 12 条提示词,包括接 Revid MCP、写角色 bible、建固定 character、话题设计、爆款拆解、每日跑批等,并强调 bio 标明 AI、禁止假评测等硬规则。

技术 › Agent meng shao (@shao__meng) 2026-10-243.6 KB 82

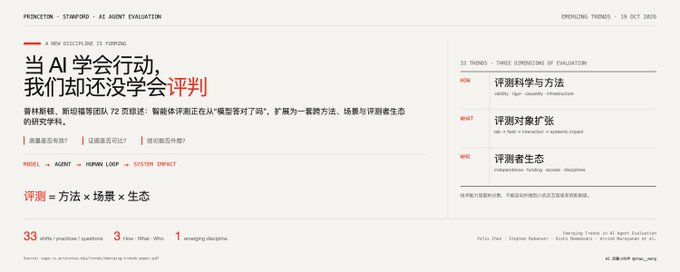
当 AI 学会行动,我们却还没学会评判:普林斯顿、斯坦福等团队 72 页综述深度解读「智能体评测新学科」诞生

普林斯顿、斯坦福等机构联合发布 72 页综述「Emerging Trends in AI Agent Evaluation」,以 How(怎么做)、What(测什么)、Who(谁来做)三维度梳理智能体评测的 33 个趋势。核心论断:随着 AI 从回答问题走向自主行动,传统跑分范式失效,agent 评测正成为一门以心理测量学为骨架的新学科。文章介绍了效度危机、pass@k 与 pass∧k 区分、因果归因、污染新表面、LLM 裁判等方法论问题,以及模拟用户失真、田野实验负面结果、评测环境成为攻击面等实证发现,并直言评测生态受资金、访问权与议程影响,独立评测面临生存危机。

技术 › Agent meng shao 2026-10-2110.7 KB 5K 30 85

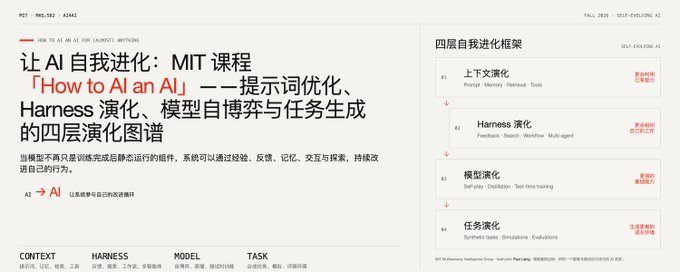
让 AI 自我进化:MIT 课程「How to AI an AI」——四层演化框架解析

文章介绍了 MIT Media Lab 2026 年秋季开设的研究生课程 MAS.S62「How to AI an AI」,主题为自演化 AI(Self-Evolving AI)。课程提出四层演化框架:上下文演化(提示优化、记忆)、Harness 演化(agent 工具链自我改进)、模型演化(持续学习、self-play、测试时训练)、任务与环境演化(合成任务生成、世界模型)。文章详述了教学设计、评分结构、作业与顶会论文成果,并评价该课程是对松散领域的体系化定义尝试,建议以阅读清单和开源工具自学。

技术 › LLM meng shao 2026-10-208.6 KB 14.6K 80 85

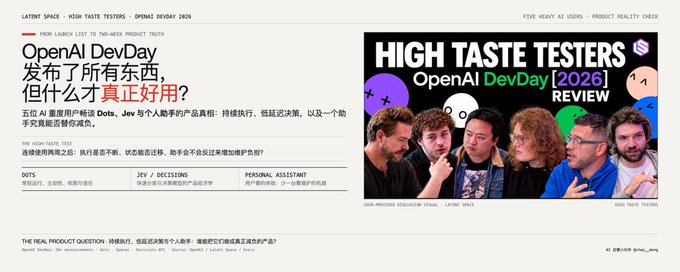
OpenAI DevDay 发布了所有东西,但什么才真正好用?五位 AI 重度用户畅谈 Dots、Jev 与个人助手的产品真相

Latent Space 首期「High Taste Testers」栏目中,五位 AI 重度用户在 OpenAI DevDay 2026 后畅谈产品真相。核心观点:模型前沿没有让人失望,产品执行让人失望;Dots 等功能藏得太深、远程执行与状态迁移未解决;Codex 桌面端更新频遭差评;行业应从 agent 转向 assistant,助手胜负在减负;Jev 决策模型改变的是成本曲线而非能力边界;信任是这一代模型的真正分水岭;分发与深度的矛盾注定产品分裂,各自占据生态位。

技术 › LLM meng shao 2026-10-1818.6 KB 5.4K 9 84

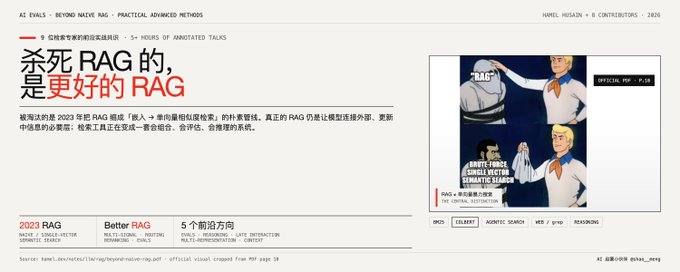
杀死 2023 RAG 的,是更好的 RAG:9 位检索专家的前沿实战共识「Beyond Naive RAG」

本文介绍 Hamel Husain 主编的演讲合集《Beyond Naive RAG》,汇集 9 位一线检索专家的共识:朴素 RAG(切块+单向量+余弦检索)已失效,但检索增强生成本身远未死亡。全书论证三条主线:长上下文不能替代检索(Context Rot 证明上下文越长模型越不可靠);评估先于优化(公开基准已污染,须建自有黄金数据集);复杂性不是目的(慎用图数据库等过度工程)。涵盖 ColBERT 后期交互、推理增强检索(Promptriever、Rank1)、多重表示与智能路由、FreshStack 评估指标等前沿方法,提出'评估驱动+多表示+推理增强+克制架构'的实践观。

技术 › LLM meng shao 2026-10-1211.9 KB 4.7K 43 84

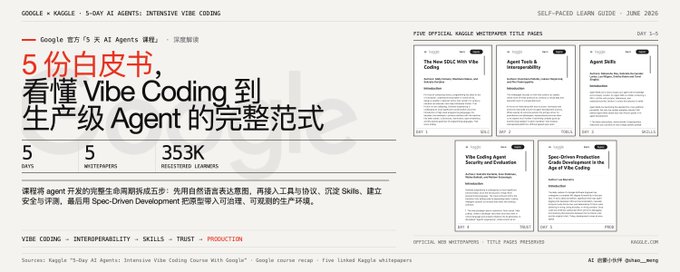
Google 官方「5天 AI Agents 课程」深度解读:5份白皮书,看懂从 Vibe Coding 到生产级 Agent 的完整范式

文章深度解读了 Google 与 Kaggle 联合推出的免费 5 天 AI Agents 密集课程,以五份白皮书为主线:Day 1 阐述 Vibe Coding 带来的软件开发生命周期范式转变;Day 2 介绍 Agent 工具互操作协议栈(MCP、A2A、A2UI、AP2);Day 3 讲解 Agent Skills 作为 LLM 第一个程序性记忆原语的知识封装格式;Day 4 直面安全与评估问题,提出 7 支柱的 Effective Trust 架构;Day 5 主张规格驱动开发(SDD),探讨 AI 时代如何实现生产级工程。文章认为该课程是理解 Agent 时代软件工程范式重组的高浓度样本,并给出以白皮书为纲、Day 2 和 Day 4 含金量最高的学习建议。

技术 › Agent meng shao 2026-10-129.6 KB 19.1K 139 83

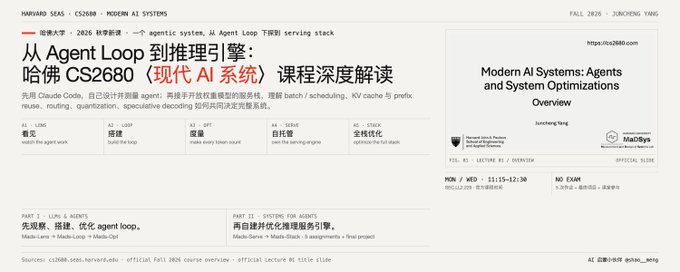
从 Agent Loop 到推理引擎:哈佛 CS2680 现代AI系统课程深度解读

本文深度解读哈佛大学2026年秋季Juncheng Yang开设的研究生课程CS2680《现代AI系统:Agent与系统优化》。课程以一条主线贯穿agent循环到LLM推理serving栈,通过五个递进式作业逐层解剖系统:A1为Claude Code构建Web前端,A2从零实现最小agent harness,A3在黑盒API下优化成本与延迟并引入排行榜竞争,A4自建推理引擎部署开源模型,A5全栈profile驱动的假设验证优化。文章还分析了课程的AI使用政策(强制披露、Claude Code session存档审计)、leaderboard评分机制、严格的20% A档曲线以及体现系统研究方法论的期末项目设计,展示了'AI时代如何教系统课'的完整答案。

技术 › LLM meng shao 2026-10-1233.1 KB 10.8K 103 85

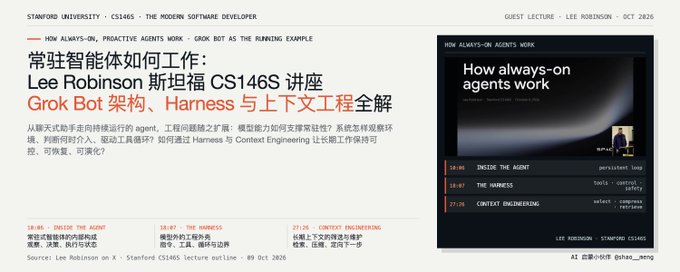
常驻智能体如何工作:Lee Robinson 斯坦福 CS146S 讲座,GrokBot 架构、Harness 与上下文工程全解

本文整理了 Lee Robinson 在斯坦福 CS146S 的讲座,完整拆解常驻主动式智能体(如 GrokBot)的工程架构。内容涵盖:从工具到同事的四个时代演进、模型层六大关键变化(长程指令遵循、子智能体、computer use、技能系统等)、常驻 agent 内部架构(休眠-唤醒模型、Firecracker 微虚机云电脑、薄客户端单工具设计、Temporal 持久化工作流、升级阶梯)、安全模型(auto review、提示注入防护),以及上下文工程核心技巧(prompt caching 经济学、压缩时机、分层记忆),最后展望训练飞轮与行业走向,并给出给学生的三条建议。

技术 › Agent meng shao 2026-10-1013.5 KB 17.4K 57 83

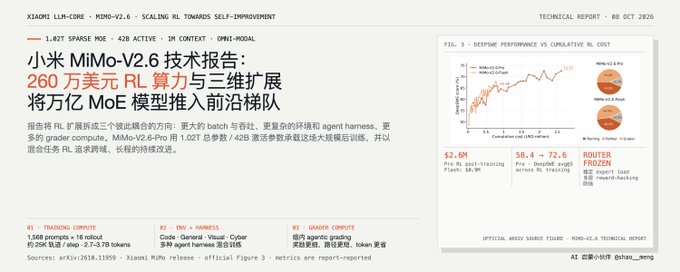
小米 MiMo-V2.6 技术报告:260 万美元 RL 算力与三维扩展,将万亿 MoE 模型推入前沿梯队

文章解读小米 LLM-Core 团队发布的 MiMo-V2.6 技术报告。核心主张是通过系统性扩展强化学习算力提升模型智能,需同时扩展训练批次、环境多样性和评分器三个维度。模型有 Pro(1.02T MoE)和 Flash(310B)两个规格,RL 后训练成本分别 260 万和 90 万美元。报告详述了中期训练优化、GRPO 训练细节、多 harness 训练、四层 reward hacking 防御、Groupwise Agentic Grading 评分体系、router 冻结发现及基础设施设计,最终性能进入与 Claude Opus 5 / GPT-5.6 同一梯队,并开源蒸馏模型、环境与 RL 框架。

技术 › LLM meng shao 2026-10-1011.6 KB 3.3K 6 86

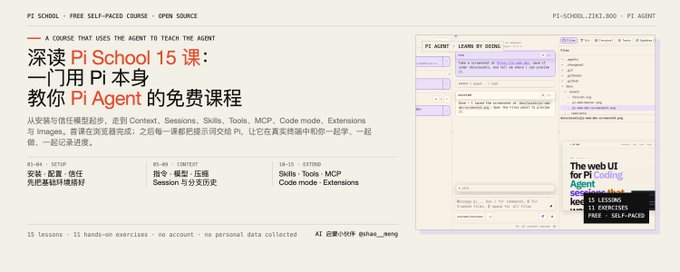
深读 Pi School 15 节课:一门用 Pi 本身教你 Pi Agent 的免费课程

本文深入解读 Pi School 这门免费开源的 15 节课程,教授如何使用 Pi——一个模型无关的极简终端编程智能体。课程采用'用 X 学 X'的设计,学员把提示词粘给 Pi,由 Pi 自己授课并同步进度。内容分四个阶段:环境搭建与配置契约(含 AGENTS.md)、理解模型边界(上下文压缩、会话分支)、以及四层扩展体系(Skills、MCP、Code mode、Extensions)。文章特别分析了 Pi 的 Trust 信任模型——以项目级一次性授权替代逐动作确认,并点评了课程的优势(认知阶梯清晰、诚实度高、押注开放标准)与局限(深度偏入门、生态绑定 Cloudflare 等)。

技术 › Agent meng shao 2026-10-0813.7 KB 25.5K 250 86

MIT 三巨头写了14年的计算机视觉教材免费开放:从古希腊视觉理论讲到 NeRF

MIT 三位教授 Torralba、Isola 和 Freeman 合著的《计算机视觉基础》开放免费在线阅读,全书 55 章历时 14 年写成,完整穿越深度学习革命。本书刻意不追踪 SOTA,而是强调当代方法深植于视觉与 AI 的历史脉络,从古希腊视觉理论一直讲到 NeRF。全书按问题背景、数学与信号处理、神经架构与统计建模、几何与运动、应用与研究素养五条主线编排,统一了经典视觉方法与深度学习,还包含研究方法论与社会伦理内容。作者认为它有望成为下一代 CV 标准入门教材,但不覆盖扩散模型与多模态大模型最新进展。

读书 › 书评 meng shao 2026-10-067.1 KB 7.3K 96 77

NYU 13周研究生课:LLM推理时代的前沿全景

文章介绍了NYU Tandon 2026年秋季由Anthropic研究员Pavel Izmailov开设的研究生课程《Language Models, Reinforcement Learning, Reasoning》。课程共13周,除Sutton & Barto教材外全部使用原始论文,沿「预训练→架构与训练效率→后训练RL→对齐与安全→前沿与未来」的主线展开,涵盖Attention机制、扩展律、Muon优化器、RLHF、GRPO与RLVR、奖励过优化、可扩展监督以及世界模型等前沿主题。文章分析了课程叙事逻辑,指出RL重回舞台中心、中国实验室工作成为正典、安全对齐被当作工程学科等趋势,并给出自学者建议。

技术 › LLM meng shao 2026-10-0512.9 KB 7.9K 72 80

Agent 学会救场:OpenAI DevDay 2026 解读

本文解读 OpenAI DevDay 2026 的 Latent Space 播客,嘉宾包括 Computer Use 负责人 Ari Weinstein 和 API 平台负责人 Nikunj Handa。文章指出 Agent 可靠性的定义已从“能否启动任务”转向“出错后能否自我调试与重试”。核心发布包括:Dots(每个 Agent 配备云端虚拟电脑)、GPT-6.1 Sol(Computer Use 成本仅为 Astra 的七分之一)、App Shots(捕获无障碍元数据的新输入方式)、Decisions API(一周零样本克隆 Jev)。文章还分析了缓存与压缩的 Agent 经济学、异步调用与 mid-turn steering 等 API 能力,并提出 OpenAI 正走向“AI 云”的 AWS 时刻,护城河向推理基础设施与平台生态迁移。

技术 › Agent meng shao 2026-10-0115.5 KB 1.8K 5 86

斯坦福 CS224V「Agentic AI」课程:把会幻觉的 LLM 改造成可信赖的智能体

文章介绍斯坦福 Monica Lam 教授团队主讲的 CS224V「Agentic AI」研究型课程。课程围绕一个核心问题:如何将本质上不可靠、会幻觉的 LLM 变成可信赖、可追责的智能体。技术主线是一条自底向上的“反幻觉”知识栈,涵盖 LLM 基础、知识策展(STORM)、RAG(WikiChat)、结构化数据查询(SUQL、SPINACH)、形式化方法与可追责 AI(SMT、SatIR、VERDICT)、任务型对话 Agent 及元 Agent 优化。课程以研究项目为核心(占 65%),依托开源平台 AOS,选题集中于医疗遗传学等领域。其哲学是系统工程+形式化约束,与业界依赖规模的路线形成鲜明对比,适合有 NLP 基础、想做真实 Agent 研究的人。

技术 › Agent meng shao 2026-10-018.3 KB 18.9K 79 80

MIT 新课 6.5940 TinyML 与高效 AI 计算(MIT HAN Lab):从剪枝量化到大模型部署与分布式训练的效率全栈课

文章介绍 MIT 韩松(Song Han)实验室开设的高效机器学习旗舰课程 6.5940 TinyML and Efficient AI Computing。课程分四章递进:高效推理(剪枝、量化、蒸馏、NAS)、面向特定领域的优化(TinyML、LLM 量化部署、长上下文、扩散模型)、高效训练(分布式训练、设备端训练)及进阶专题。课程以动手为中心,无考试,由 5 个 Lab(从 GPU 编程到本地 LLM 部署)和 NeurIPS 模板期末项目构成评分。作者认为该课程知识体系完整、与研究前沿零距离、工程实践导向鲜明,是学习模型压缩、LLM 推理优化和 TinyML 的最佳公开课,所有视频和课件均已公开。

技术 › LLM meng shao 2026-09-308.1 KB 5.3K 56 79

「Learn Inference」LLM 推理工程全景指南:从 Attention 内核到多云 GPU 容量,两阶段、三层栈、五大技巧

本文是 Philip Kiely 所著《Inference Engineering》的交互式伴读站点介绍,系统梳理 LLM 推理工程全貌。文章以 prefill/decode 两阶段为原子结构,按运行时、基础设施、工具链三层展开,逐章讲解模型结构(Attention、KV 缓存、MoE)、GPU 硬件选型(带宽 vs 算力)、软件栈(vLLM、SGLang、TensorRT-LLM)、五大优化技巧(量化、投机解码、缓存、并行、解耦)以及多模态与生产实践(扩缩容、路由、成本、可观测性)。核心思想是:先诊断瓶颈再优化,一切优化皆是权衡,具体知识会过期而底层约束移动缓慢。

技术 › LLM meng shao 2026-09-2918.6 KB 3.4K 11 86

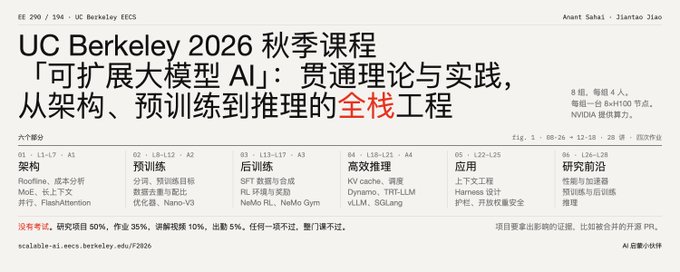
UC Berkeley 2026 秋季课程《Scalable AI》:从架构、预训练到推理的全栈工程

文章介绍 UC Berkeley EECS 2026 秋季开设的《Scalable AI》课程(EE 290/194),由 Anant Sahai 与焦剑涛联合授课,NVIDIA 提供算力支持。课程将大模型作为端到端工程对象教授,涵盖架构、预训练、后训练、高效推理、应用与研究前沿六个阶段,采用基于真实 H100 节点的项目制考核,无笔试,研究项目占 50% 且要求外部影响力证明。课程深度绑定 NVIDIA NeMo 工具链,反映了 AI 教育重心从论文向工程实践迁移的趋势,适合目标为 LLM infra 与 MLSys 的学生。

技术 › LLM meng shao 2026-09-299.4 KB 6.4K 53 73

斯坦福大学 CS329Z「Engineering AI Agents」第二讲 LLMs for Builders:Agent 工程师必修的大模型底层原理

本文深度解读斯坦福 2026 秋季课程 CS329Z 第二讲「LLMs for Builders」讲义,面向 Agent 工程师系统讲解 LLM 底层原理。内容涵盖:自回归概率分解与解码采样策略;从 RNN 到 Transformer、线性注意力的架构演进及其工程取舍;预训练、中期训练与后训练(RLHF、RLVR)管线;推理阶段的 Prefill/Decode、KV Cache、投机解码与推理时扩展;最后落脚到 Agent 开发的结构化 I/O 与上下文工程实践,强调'设计决策→局限→应用策略'的因果链。

技术 › LLM meng shao 2026-09-2919.3 KB 19.4K 60 84

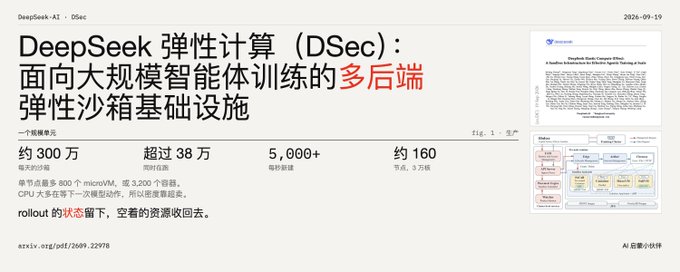
DeepSeek 弹性计算(DSec):面向大规模智能体训练的多后端弹性沙箱基础设施

本文解读 DeepSeek-AI 与清华大学合著的 DSec 论文,这是支撑 DeepSeek V3.2 到 V4.1 智能体 RL 训练的生产级沙箱基础设施。文章分析了智能体训练负载的七大特性(突发创建、CPU 稀疏、有状态长寿命、高度异构等),介绍了其无状态控制面、分层代理数据面架构,以及可组合环境分层、高密度内存管理、QoS 感知 CPU 调度、按需镜像加载四大核心机制。还深入阐述了 agent loop 与训练解耦、暂停恢复协同、防 reward hacking 的安全对抗实践。作者认为这标志着智能体能力竞赛正在演变为基础设施竞赛。

技术 › Agent meng shao 2026-09-2812.9 KB 4.8K 11 83

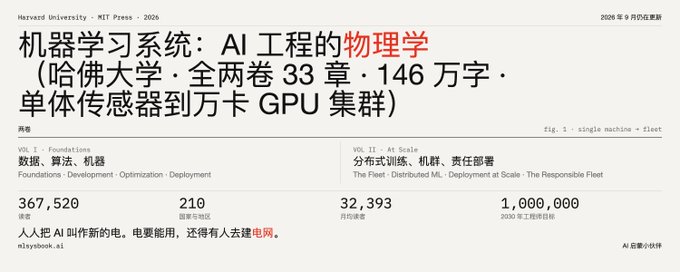
机器学习系统:AI 工程的物理学(哈佛大学开源教材解读)

文章介绍了哈佛大学 Vijay Janapa Reddi 教授的开源教材《Machine Learning Systems: The Physics of AI Engineering》,两卷 33 章,旨在像 Hennessy & Patterson 的体系结构经典一样,将 ML 系统工程变为有定量定律的学科。全书以铁律、屋顶线模型、能耗阶梯、Amdahl 定律、漂移方程等核心定律组织内容:第一卷讲单机 ML 系统栈(数据、训练、压缩、硬件、服务、MLOps),第二卷讲集群规模化(分布式训练、3D 并行、容错、推理经济学、可持续 AI)。文章总结了书中'约束驱动''一切皆有价格''静默失败是默认模式'等核心世界观,并给出不同读者群体的阅读建议。

技术 › 后端 meng shao 2026-09-2817.0 KB 13.5K 125 84

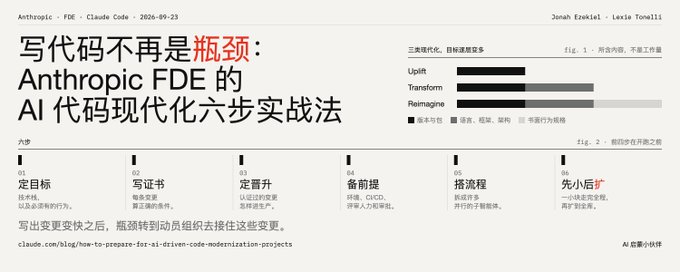
写代码不再是瓶颈:Anthropic FDE 的 AI 代码现代化六步实战法

本文解读 Anthropic 两位 FDE 的实战笔记,指出 AI 驱动的代码现代化中瓶颈已从'产出变更'转移到'围绕变更动员组织'。文章拆解了六步流程:定义三类现代化目标(Uplift/Transform/Reimagine)、定义机器可校验的'证书'作为合并标准、设定分层晋升策略、准备环境与安全前置条件、构建可迭代的 Agentic 工作流、小规模试点后规模化执行。核心洞察包括:与审查者共同设计验收标准、让专家早期介入换取后端轻审、'修改工作流而非修改每一处变更',以及受监管环境中验证成本大于生成成本的新常态。

技术 › Claude meng shao 2026-09-278.8 KB 11.4K 84 90

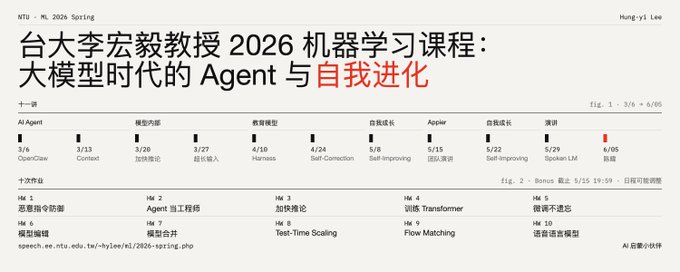
台大李宏毅教授 2026 机器学习课程更新:大模型时代的 Agent 与自我进化

文章介绍台湾大学李宏毅教授 2026 春季机器学习课程,该课程完成了从经典机器学习到大模型时代前沿课的彻底转型。课程以四幕叙事展开:AI Agent 与 Context Engineering、模型内部架构(Flash Attention、KV Cache、位置编码)、模型教育(Harness Engineering、自我修正)、模型自我成长(Self-Improving、自我进化 Agent)。十次硬核作业与授课主题严格对应,涵盖 LLM 安全、Agent 搭建、推理优化、后训练等技能。文章认为课程演变折射学科趋势:Agent 成应用层范式、系统级工程能力重要、后训练时代重心移向环境设计与模型自我进化。

技术 › LLM meng shao 2026-09-2710.2 KB 22.4K 222 85

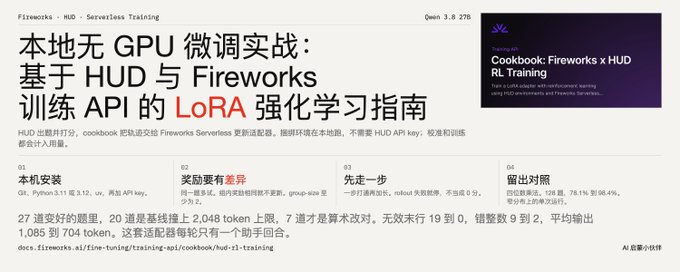
本地无 GPU 微调实战:基于 HUD 与 Fireworks 训练 API 的 LoRA 强化学习指南

本文解读 Fireworks AI 官方 Training API Cookbook 中一篇实战教程,讲解如何结合 HUD 框架与 Fireworks Serverless Training API,在无本地 GPU 条件下用 GRPO 风格强化学习微调 LoRA 适配器。文章详细拆解了四步工作流程:环境配置、任务校准、单步训练和长跑训练,重点阐释了快照隔离、trace 记录、loss masking、组内优势归一化等核心训练机制。实验结果显示四位数乘法任务准确率从 78.1% 提升至 98.4%,但作者指出收益主要来自输出格式和自我节制的优化,而非深层算术能力的提升。文章还提醒了 checkpoint 语义区分等实操要点,并对教程的严谨设计给予高度评价。

技术 › LLM meng shao 2026-09-2610.7 KB 4.7K 36 86

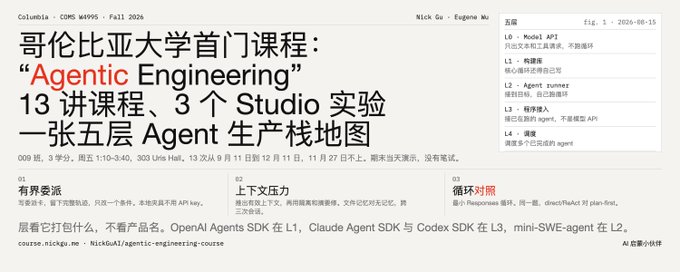
哥伦比亚大学首门 Agentic Engineering 课程解读

文章介绍哥伦比亚大学 2026 秋季首门 Agentic Engineering 课程(COMS W4995-009),其核心立场是:Agent 本质是包裹模型的软件工程(harness),而非模型本身。课程分基础、架构、设计与生产化、期末项目四个模块共 13 讲,配备三个重实践的 Studio 实验:委托与可观测运行、长上下文压力测试与记忆架构、Agent 循环受控对比。文章还解读了课程的五层 Agent 生产栈分类法(L0 模型 API 到 L4 协调系统)与六大学习目标,认为该课将喧闹的 AI Agent 话题还原为可严肃讲授的工程学科,其课程网站和 Studio 设计即使不选课也值得从业者研读。

技术 › Agent meng shao 2026-09-2613.5 KB 13K 133 85

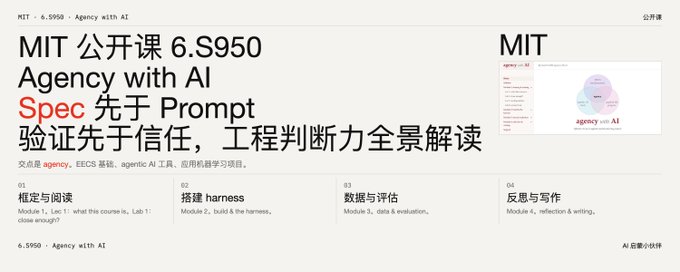
MIT 公开课 6.S950 Agency with AI:Spec 先于 Prompt,验证先于信任

文章全景解读 MIT EECS 2026 秋季新课程 6.S950《Agency with AI》。课程不教工具使用,而教 AI 时代的工程判断力:什么该委托给 AI、什么该验证、什么该留给自己。方法论核心是四问法(解决什么问题/方案/老思想/新在哪)与增量思维。12 讲沿真实 ML 项目生命周期展开,涵盖文献阅读、spec 驱动开发、版本控制、抽象阶梯、数据审查、LLM 机制、评测设计与审计等主题。Lab 设计精妙地控制 AI 在场与否,考核要求任何无法说明理由的工作不得分,强调决策的可辩护性与人类作者性的保留。

技术 › LLM meng shao 2026-09-2616.8 KB 17.9K 115 80

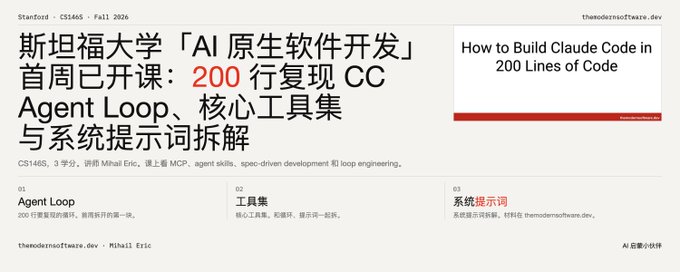
斯坦福 CS146S 首周:200 行复现 Claude Code——Agent Loop、核心工具集与系统提示词拆解

斯坦福大学 Mihail Eric 教授开设的「AI 原生软件开发」课程 CS146S 首周资料公开。第一周主题是拆解 Coding Agent 内部机制:LLM 是无状态的文本到文本函数,agent 的能动性来自外部循环,即 agent = LLM + 工具 + 循环。课程用 200 行代码复现 Claude Code 骨架,讲解核心循环设计、read/write/edit/bash 四个最小完备工具集,以及 Claude Code、Cursor 等生产级 agent 系统提示词的结构分层:身份锚定、工具规则、工作流规范、安全边界和沟通风格。课程旨在 demystify:agent 没有魔法,骨架与产品的差距全是可学习的工程问题。

技术 › Agent meng shao 2026-09-258.6 KB 23.8K 136 84

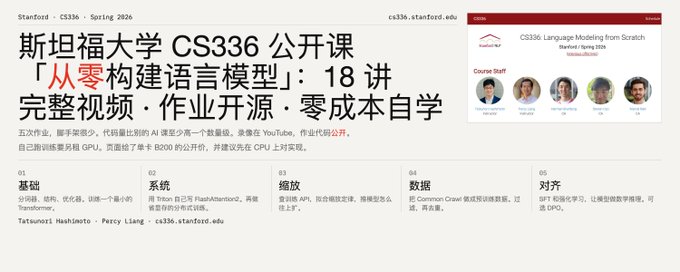
斯坦福大学 CS336 公开课「从零构建语言模型」:18 讲完整视频 · 作业开源 · 零成本自学

本文介绍斯坦福大学 2026 春季研究生课程 CS336「从零构建语言模型」。该课程由 Hashimoto 和 Liang 教授讲授,工程量极大,学生需亲手实现 tokenizer、模型、FlashAttention2 内核及分布式训练。内容覆盖 LLM 全生命周期:模型架构、系统优化(GPU/内核/并行)、Scaling Laws、数据处理、推理评估及后训练对齐(含 RLVR)。五次编程作业串起从原始数据到可对话模型的完整生产流程。目前 18 讲视频与作业已全部公开,是自学者系统补齐 LLM 工程能力的稀缺资源,但要求扎实的 PyTorch 与体系结构基础。

技术 › LLM meng shao 2026-09-247.2 KB 15.5K 194 81

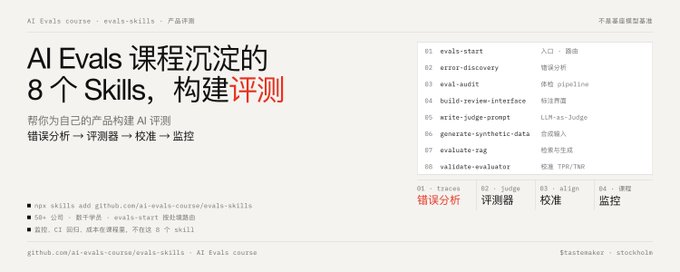
AI Evals 课程沉淀的 8 个 Skills:错误分析 → 评测器 → 校准 → 监控

文章介绍了来自 Hamel Husain 和 Shreya 的 AI Evals 课程沉淀的 8 个 Skills,帮助工程师和产品经理为自己的 AI 产品构建评测体系。核心理念是先看数据再写评测:先手动阅读真实 trace 做错误分析,发现失败模式,再针对每个模式构建评测器,并用约 100 条人工标注校准(TPR/TNR 目标 >90%)。8 个 Skills 覆盖入口路由、错误分析、评测审计、合成数据生成、Judge 提示词编写、评测器校准、RAG 评测和标注界面构建。方法论强调二值评判、单一 judge 测单一失败模式、Rogan-Gladen 偏差修正等最佳实践。

技术 › LLM meng shao 2026-09-238.6 KB 13.9K 66 85

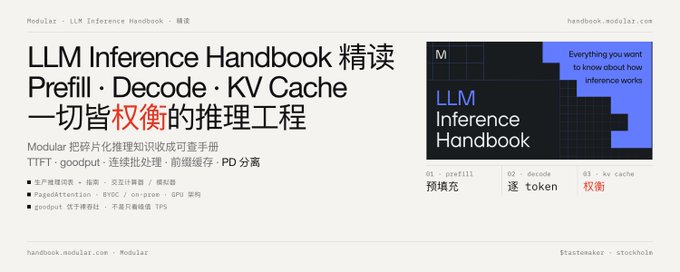
LLM Inference Handbook 精读:Prefill、Decode、KV Cache,与一切皆权衡的推理工程

本文深度解读 Modular 公司开源维护的《LLM Inference Handbook》,系统梳理 LLM 推理工程的知识体系。文章提炼三大核心框架:prefill(算力受限)与 decode(带宽受限)的两阶段二分法;KV cache 作为系统中心约束的地位,围绕它的 PagedAttention、prefix caching、PD 分离等技术网络;以及“一切皆 trade-off,唯一方法论是 benchmark”的工程哲学。内容还涵盖 continuous batching、speculative decoding、GPU 内存金字塔、FlashAttention、量化与蒸馏三部曲、Agent 生态与部署运维等主题,强调推理优化的本质是围绕有状态 KV cache 做内存管理与调度。

技术 › LLM meng shao 2026-09-2218.3 KB 14.6K 139 84

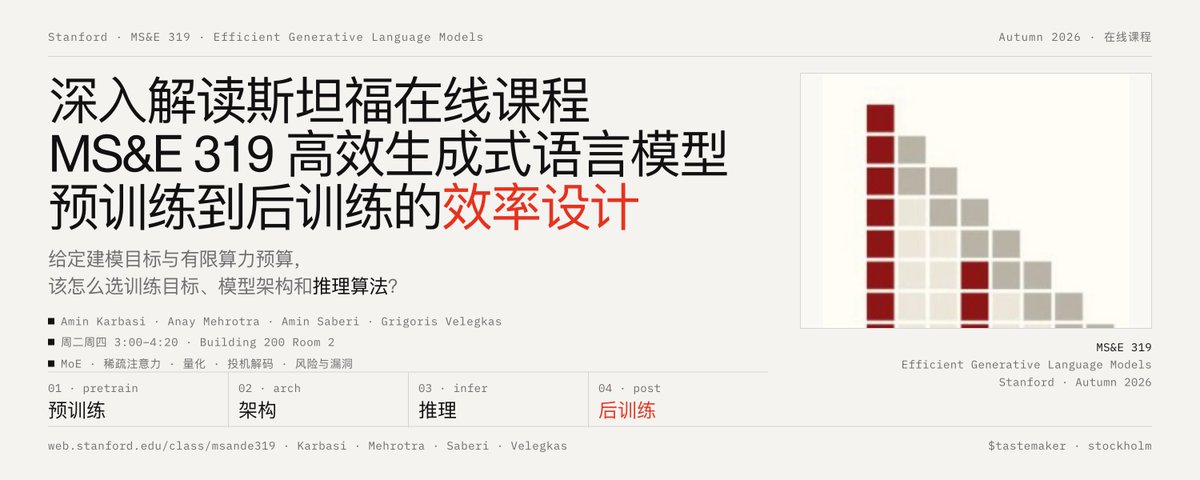
深入解读斯坦福在线课程 MS&E 319「高效生成式语言模型」

本文深入解读斯坦福 2026 秋季研究生课程 MS&E 319《Efficient Generative Language Models》。该课程以「效率」为设计科学,在算力预算有限的约束下,沿大模型生命周期系统讲授预训练、架构、推理、后训练四阶段的效率技术,包括多 token 预测、Muon 优化器、MoE、稀疏注意力、FlashAttention、KV 缓存压缩、量化、投机解码、LoRA、DPO 与蒸馏等,并涵盖越狱攻击与模型窃取等安全议题。文章认为该课填补了教育生态空位,内容前沿性与领域同步,揭示了每项效率技术背后的权衡取舍。

技术 › LLM meng shao 2026-09-2111.5 KB 18.9K 95 68