Wiki 知识库

全部文档 / 标签: 模型评测

76 篇
清除

实测阶跃星辰新模型 Step 5 Preview,网页复刻这块我愿称之为天才程序员级

作者实测阶跃星辰新模型 Step 5 Preview,认为其前端 UI 能力已进入第一梯队,价格仅为竞品三分之一却达到 K3 水平。测试显示它能高精度复刻 Apple 官网页面,配合 Skills 可实现动效网页设计,还能用 HTML5 Canvas 开发 2D/3D 游戏且操作流畅。作为 Agent 接入 Claude 框架后,它能从 72 页 PDF 中逐页提取数据核算利润率,并审计修复含 1800 多条公式的复杂 Excel 财务模型,揪出 22 处错误并标注不确定项。作者感叹国产模型正在从几家变成一批,整体表现超出预期。

技术 › LLM 卡尔的AI沃茨 2026-09-2211.1 KB 4.5K 10 66

Grok 4.7 交卷:模型更强了,便宜这笔账得重算

xAI 于 9 月 21 日发布 Grok 4.7,主打长任务能力:更大基础模型、更长强化学习训练、支持 50 万 token 上下文。文章分析官方与第三方基准成绩,指出其在编程等部分任务进步明显但并非全面领先,需结合自身需求看待榜单。价格方面,标准 API 单价较低,但长上下文(20 万 token 以上)计费翻倍、Fast 版本仅限特定平台,且模型实际 token 消耗可能很高,单价低不等于总价低。作者建议用真实工作任务测试模型,关注交付质量与总成本,而非被亮眼演示或单价吸引。
技术 › LLM 李新宝 2026-09-227.1 KB 1.3K 4 78

万字长文:通宵评测Qwen-Image-2.1

作者在48GB的4090上对Qwen-Image-2.1进行了13组实验、196张图的深度评测。模型视觉生成为7B DiT架构,配Qwen3-VL编码指令与参考图,支持原生RGBA透明。评测发现其强项为中文排版、原生透明通道和多图身份保持,弱项是「替换」语义常退化为「添加」、编辑具有非局部性、缺乏时间维度建模。文章详细测试了文字渲染阈值、透明度真实性、指令遵循、编辑精度、多图参考及性能表现,并给出KV cache与显存的权衡策略。最后作者通过360°转台动画实验,揭示了条件图下seed敏感性等反直觉发现,定位其为关键帧生成器而非视频模型。

技术 › LLM 实践哥 Li 2026-09-2118.2 KB 525.6K 599 90

如何用自己的数据微调一个小模型

本文是翻译整理的完整小模型微调指南(原作者Rahul),主张用1.5B参数模型配合200-500条高质量样本微调,即可在特定任务上超越通用前沿大模型。文章涵盖微调的正确认知(微调非提升智能而是稳定窄任务)、三个基线建立、选择Qwen2.5-1.5B等小基座模型、数据权利确认、PDF/OCR文本抽取与清洗、按公司切分数据集、QLoRA训练超参配置、幻觉数字检测评测、vLLM部署及监控重训策略。强调数据合规和评测纪律是真正值钱的部分,附完整可运行代码。

技术 › LLM yibie 2026-09-2010.3 KB 213.6K 1.1K 86

从未见过如此抽象的 AI 测评!三大AI大战屎山代码

文章介绍了B站兴起的AI测评生态:UP主用屎山代码改BUG、AI囚徒困境生存游戏、新三国梗问答、同一素材做游戏、量化交易回测等脑洞方式测试各大模型。与公开跑分榜单不同,这些由UP主临时出题、观众共同参与测评的方式避免了模型背题,更能反映AI真实能力。B站推出的AI无限竞技场将这些测评收进同一平台,29个主题、百大模型同场竞技,首期榜单第一名是GPT-6,但并非每个主题都是第一,体现了多角度测评的价值。

技术 › LLM 铁锤人 2026-09-207.6 KB 38.9K 24 61

爆肝30天!魔搭紫皮书开源:系统学习AI的免费指南

袋鼠帝及其AgentWork开源社区耗时30天推出免费开源的《魔搭紫皮书》,一本约40万字、8篇34章的系统学习AI指南。与侧重AI Agent应用的workbuddy蓝皮书和豆包工作蓝皮书不同,紫皮书面向想从零深入AI领域的读者,涵盖开源模型下载、微调(ms-swift)、评测(EvalScope)、应用场景(AI健身教练、智能客服质检、语音助手等)及Agent篇(Claude Code、DeepSeek Harness等)。作者分享了自己7年前报培训班学习编程的经历,强调开源时代AI学习资源免费可得,唯一门槛是执行力。

技术 › LLM 袋鼠帝 2026-09-206.1 KB 32.5K 328 63

别人看发布会我跑数据:六组实验五个开源仓库,Jev 的真实边界全在这

作者通过六组实验和五个开源仓库实测 TypeSafe 发布的 Jev 模型的真实能力边界。Jev 是只回答封闭问题、一次前向返回概率分布的模型。核心结论:Jev 适用于信号在语义中的场景(如泰坦尼克 0.83 AUC),对纯统计信号数据(如哈希 CTR 数据)无效;零样本表现相当于 150-500 条标注数据;最佳用法是作为特征融入已有模型而非单独使用,五个项目均获显著提升。作者还总结了问法即超参数、汇总预警取决于时间尺度、情绪分析无用等六条经验,以及评审循环偏差、真值精度等评测教训。

技术 › LLM Jason Zhu 2026-09-1917.6 KB 7.8K 51 86

拿到 Jev,然后呢?剔掉虚火之后的一份真实落地清单

TypeSafe AI 于 2026 年 9 月发布的 Jev 是一个只做选择题的 AI 模型(单选、打分、是/否),响应 0.07–0.5 秒、输入价格极低、输出免费。作者梳理了官方数据及 Hacker News 上的质疑,指出“Jev 取代大模型”是伪命题,其合理定位是高频、低价地执行小判断。文章按用途分类整理了已真实跑通的案例:为 AI Agent 当决策器、海量数据分类、高低置信度分流混合架构、实时反应界面和仿真实验,并列举了已接入的商业产品。作者还分享了自己四次失败的集成尝试与两轮实测结论,强调概率校准的重要性。

技术 › LLM huangserva 2026-09-1922.2 KB 552.7K 840 85

Jev 模型实测:新闻分类任务上的速度、质量与价格三赢

作者分享了使用新模型 Jev 对《人民日报》新闻进行湖北相关元素分类的实测体验。此前该项目一直使用 Gemini Flash Lite 系列,积累约 2.4 万条数据。通过 OpenRouter 上线 Jev 后用相同提示词对比测试:速度上单篇耗时从 3 秒降至 0.35 秒,提升近 10 倍;质量上与 Flash Lite 仅 15% 判断不一致,且差异多源于人名知识库差异,实际正确率约 95%;价格上处理 5 千条数据 30M Token 仅花费 1 美元。作者认为 Jev 代表的分类器大模型在分类场景下实现了速度/质量/价格的不可能三角,极具前景,并计划连夜用于优化生产项目。

技术 › LLM 李不凯正在研究 (@libukai) 2026-09-195.0 KB 75

Hamel 的 AI 产品工程笔记:Evals、Context、Systems 的优化全序

本文整理了 Hamel Husain 的 Maven 课程「AI Product Engineering」13 场讲座(共 9.5 小时)的笔记精华,按 Evals、Context、Systems 三大主题组织。核心结论是 AI 产品优化的顺序:先优化检索与上下文(投入产出比最高),再改进系统与执行框架,最后才考虑 post-training。Evals 贯穿一切改进,是判断优化效果的前提。文章涵盖数据 Agent 评测、模型级联降本、自动化错误分析、多向量检索、嵌入模型优化、OCR 选型、推理延迟调试、开源模型经济学等具体实践,强调评测环境应反映生产环境的真实脏乱,模型推理能力往往远超其所得的检索质量。

技术 › LLM meng shao 2026-09-1722.2 KB 27.6K 144 87

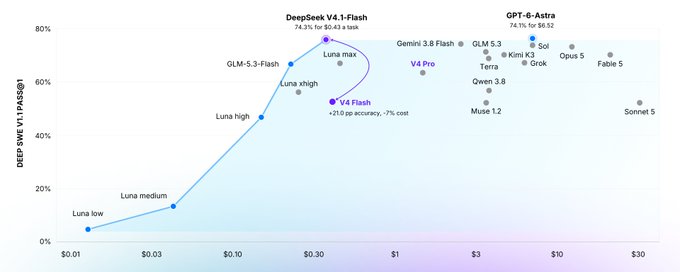
DeepSeek-V4.1-Flash on Fireworks: Astra-level DeepSWE at 1/15th the cost

Fireworks 发布的 DeepSeek-V4.1-Flash 在 DeepSWE 基准测试中以每任务 $0.43 的成本达到 GPT-6 Astra 级别的编码准确率,价格仅为 1/15。该模型采用 552B MoE 编码器-解码器分离激活架构(输入 8B、输出 16B 活跃参数),配合 KV Cache 优化(HBM 占用降至 1/4),在 Terminal-Bench 2.1 上以 12x 更低成本逼近 Astra。但在 HLE 学术推理上落后于 Astra;oracle 路由测试显示两模型组合可超越 Astra 单模型表现,凸显多模型路由系统的价值。

技术 › LLM Fireworks 2026-09-169.1 KB 24.1K 200 75

Ling-3.0-flash-Fin金融增强模型实测:从年报取数到可编辑底稿

作者实测蚂蚁百灵金融增强模型Ling-3.0-flash-Fin,用宁德时代2025年报和FinFIRST评测题检验其金融研究能力。模型能区分销量与装车量口径,精准提取11项核心指标并复算比率,生成三档情景和20行CSV底稿,但Web Search等外部工具未实际执行。作者认为该模型适合作为金融研究第一道工序,能分清披露、外部统计和计算值,但尚非无人值守的金融Agent。

技术 › LLM 阿川 | AI thinking 2026-09-148.6 KB 48.6K 219 78

我在 22.7B token 上从零训了一个 348M 模型,它能做 14 位加法

作者 nkthebass 从零训练了一个 348M 参数的 decoder-only 小模型 TinyBrainBot 350M V3 Math,用带纸笔(scratchpad)的竖式算术方式做计算。九项 GPT-3 算术子任务均值达 99.4%,加法干净做到 14 位,三位数乘法 98.0%。文章详细分析了首版三个缺陷的修复过程、加法天花板源于词表位名不足、减法错误集中在大小比较、应用题弱与算术高分不矛盾等发现,并分享了训练中关于联合分布控制和显式对齐步骤两个关键经验,以及 LoRA adapter 合并的意外收益。

技术 › LLM yibie 2026-09-138.4 KB 982 3 86

BestBlogs 早报 · 09-11|DeepSeek 降缓存成本,Magic 验预训练效率,Shopify 原生化

本期早报聚焦 Agent 能力落地过程中的工程变量与真实收益。精讲三篇:DeepSeek V4.1 Flash 通过大幅缩减 KV Cache 降低长上下文推理与缓存成本;Magic 用保留集、缩放律和防数据泄漏评测验证预训练配方的十倍效率提升,强调跨规模验证的重要性;Shopify 因编码模型降低双端实现成本,从 React Native 转向 Swift/Kotlin 原生开发,并通过 Helix 流程保证 AI 生成代码的可交付性。速览部分涵盖 Cognition SWE-2 的成本-能力 Pareto 优化、Agentic Harness 工作流框架、Anthropic 网络安全事件对齐复盘、规范驱动开发研究、LinkedIn 企业 Agent 的 Skills 实践与 Bolt CEO 关于原型到生产代码的访谈。

技术 › LLM ginobefun 2026-09-1123.0 KB 2.6K 2 79

这个时代最明确的两条风口-AI和IP

作者以一名刚入行AI模型评测的大厂新人视角,复盘入行一年多的经历,指出爆发期行业的'草台班子'本质,鼓励普通人不必等完全准备好再入场。文章提出当下两大风口:AI与IP。AI部分强调'有多少智能就有多少人工',模型进步依赖大量人工数据标注与评测,真正的红利是把个人创业的技术门槛降到极低,需要懂业务的人把AI落进具体场景。IP部分强调通过持续公开输出积累信任资产,摆脱'大厂藤壶'困境,并将内容创作拆为IP本人、助理、视频制作三个角色,尝试用AI辅助视频制作,开启个人账号的长期积累。

职场 › 职业发展 卡萨丁 2026-09-1012.0 KB 269 1 72

GPT Image 2.5悄悄上线,依赖提示语提升AI生图可控性的时代过去了

OpenAI突然发布GPT Image 2.5,生成速度更快、更高清,支持多次编辑保持一致性,可精确标注修改,并新增画布涂鸦绘图功能。API同时推出Flare(速度+50%)和Sunburst(更高精度)两个版本。作者通过logo、人物、定格动画、建筑、风格迁移、多尺寸封面等大量案例对比Image 2与2.5,发现新模型形变大幅减少、文字更清晰、一致性更好,还支持原生透明背景。网页版新增15个设计模版。作者认为最大的变化在交互方式:涂鸦、模版、标注精修将原本需要写进提示语的约束变成直觉操作,好的提示语不再是用好AI生图的前提。

技术 › OpenAI 卡尔的AI沃茨 2026-09-099.5 KB 49.3K 179 73

我把四份宇树科技申报材料交给金融模型跑了三次,第三次它没输给数字,输给了 JSON

作者用四份宇树科技公开申报材料构建了10万字符的证据包,对蚂蚁百灵金融模型 Ling-3.0-flash-Fin 进行三轮相同条件实测。前两轮均达 32/33 字段正确、19/20 整项正确,且对无答案问题不硬编;第三轮内容大体正确,却因 JSON 结构错误导致程序无法解析,形成'API 返回 3/3,严格结构化交付 2/3'的结果。文章指出模型进入真实金融工作流后,关键不再是答对问题,而是稳定交付下游可用的结构化结果,建议采用 JSON Schema 校验、失败重试与人工复核的生产路径,认为该模型适合作为金融 Agent 的中间推理层,但尚不能无人值守接管工作流。

技术 › LLM 波妞PONYO 2026-09-068.2 KB 26.1K 146 79

GPT-6 实测一整天:用了两年半 GPT,这是我第一次觉得 AI 真换代了

作者陈硕实测 GPT-6 Astra 一整天,通过 30-45 分钟制作可跑的 3D 游戏 Demo,验证了其核心能力。文章总结了 GPT-6 的四大升级:Computer Use 真正执行操作、异步工具调用、任务中追加指令、推理强度按阶段切换。还筛选了 X 上三个典型案例:重建火车图为 3295 个可编辑对象、自动跑模拟器测试、核对 41 份财务文件。作者强调应将 AI 整合进工作流,拆分输入、工具调用、验收和人工确认环节,而非神化模型能力,敏感操作仍需人工把关。

技术 › OpenAI 陈硕KAI 2026-09-0613.5 KB 27.2K 80 79

BestBlogs早报·09-06|蚂蚁数科 Harness 验收,Uber 成本治理,UrbanGround 测长程

本期早报围绕 Agent 从生成能力走向稳定交付的实践路径展开三条精讲:一是蚂蚁数科的 Harness 工程实践,通过约束层、状态写入、目标对齐与对抗验证建立 AI Coding 验收闭环,存量项目缺陷率显著下降;二是 Uber 的智能体成本治理,在周请求量增长9.4倍的情况下,通过成本乘数拆解、模型路由、上下文治理和缓存策略保持总支出稳定;三是 UrbanGround 在真实三维香港沙盒中评测多模态模型的长程导航能力,揭示局部识别与完整任务完成间的巨大断层。速览部分涵盖自建数据中心、ML 训练数据加载、上下文清理、边缘推理、开源代码治理、AI 电话代理等主题。

技术 › Agent ginobefun 2026-09-0623.3 KB 7.5K 3 84

实测GPT-6 Astra:曾经的那个OpenAI,回来了

作者实测OpenAI新发布的GPT-6 Astra模型,认为其综合能力追平Claude Fable 5,OpenAI重回黄金时代。文章从三方面展开:一是速度大幅提升,任务完成时间从数小时缩短到十余分钟;二是前端和审美能力史诗级强化,一句话即可生成高精度3D网页模型;三是代码能力追平Fable 5,能从本质层面发现并修复系统深层问题,并介绍Codex实验性跨窗口笔记功能。作者还分享了为超级模型简化的AGENT.md配置建议,强调聪明模型需要更少限制规则。

技术 › OpenAI 数字生命卡兹克 2026-09-0520.7 KB 58.8K 278 77

GPT-6发布,OpenAI说AGI时代来了

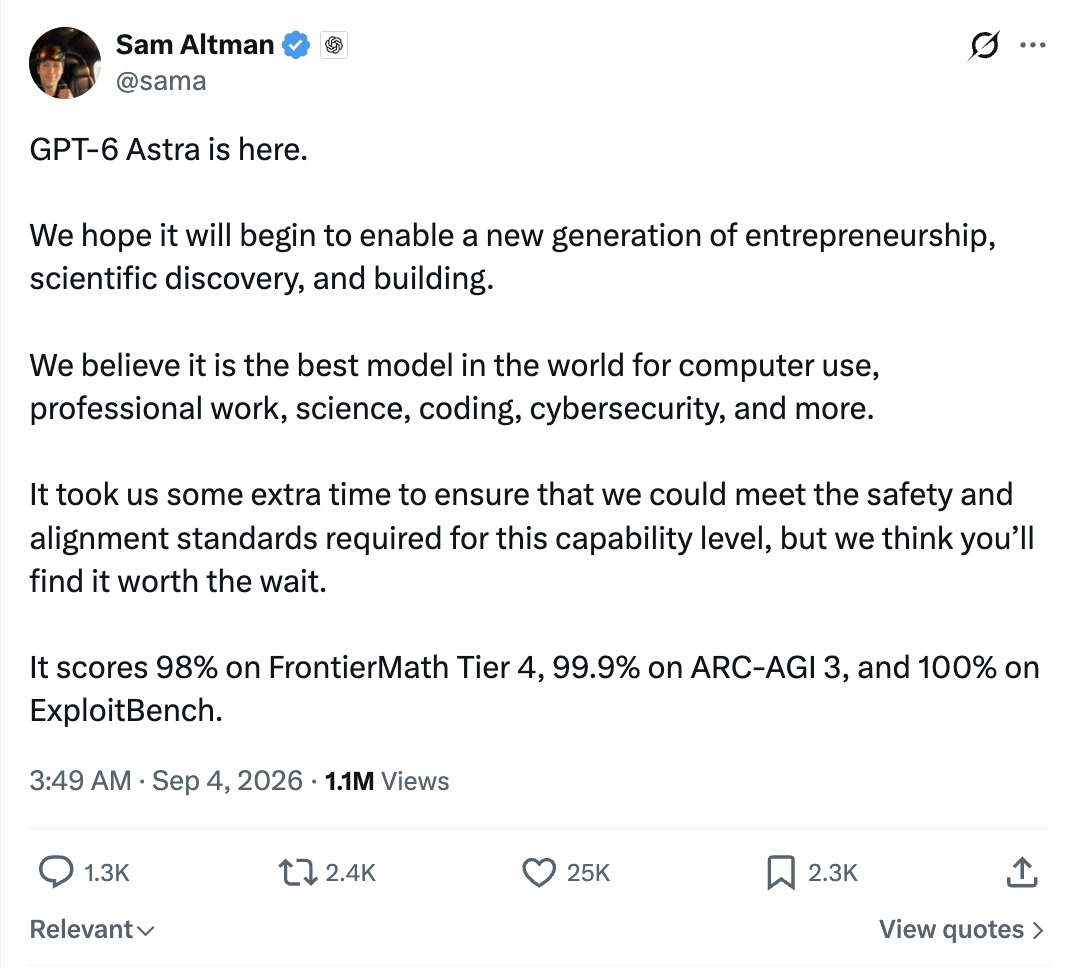
OpenAI于2026年9月4日发布GPT-6 Astra,与Anthropic的Claude Fable 5.1正面竞争。Astra在数学(FrontierMath 97.6%)、ARC-AGI-3(99.9%)、电脑操控(OSWorld 2.0)等评测上大幅领先,编程类任务则与Claude咬得较紧未全面胜出。文章分析了各项benchmark数据、定价(与Fable 5.1相同)、Codex跨上下文记笔记等新功能,指出Astra是首个触发Critical网络安全阈值的模型,因此漏洞利用能力被限制。作者认为AGI时代特征初显,电脑操控能力将碾压此前人机协作的苦力活。

技术 › OpenAI 花叔 2026-09-0415.2 KB 16.6K 15 80

GPT-6 Astra全面解析 - “欢迎来到AGI时代。”

OpenAI发布GPT-6 Astra,定位为迄今最智能且最对齐的模型。文章详细解析其新特性:105万Token上下文窗口、作为全球最佳操作电脑的模型(OSWorld完成率72.6%)、ARC-AGI-3达到99.9分远超人类平均水平、视觉判断力和审美大幅加强、更强的主动性(Judgment)能自主消化不确定性、安全对齐显著提升(幻觉率降至2.0%)、成为首个达到网络安全Critical等级的模型。同时文章指出隐忧:模型思维链可监控性显著下降,人类越来越难理解其推理过程,AI正在走向奇点。

技术 › OpenAI 数字生命卡兹克 2026-09-0417.5 KB 674.2K 1.2K 71

我让蚂蚁百灵的金融模型,和它自己打了 441 轮

作者对蚂蚁百灵发布的金融模型 Ling-3.0-flash-Fin 与其通用基座 Ling-3.0-flash 进行了 441 轮对比实测,使用微软 FY26 Q4 财报和宁德时代 2025 年报等一手公开材料,设计八类任务。结果显示两个模型都能以分析师水准完成建模、口径辨析、抗幻觉等任务,准确率上金融版没有体现出明显优势;唯一显著差距在长篇输出场景,金融版更易'想太多'后返回空白(研报撰写失败率 18.6% vs 0%)。文章还给出反直觉发现:长上下文直投比 RAG 检索更准、更快、更便宜,并坦诚记录了测评过程中的多次自我纠错。

技术 › LLM 阿良|AI 工作流 2026-09-0319.1 KB 38.6K 141 90

实测Claude Fable5.1:长时间Agent任务和浏览器自动化稳压GPT5.6

作者实测Claude Fable 5.1新模型,发现其在长时间Agent任务、浏览器自动化和电脑自动化方面显著提升,达到甚至超越Codex GPT 5.6的水准。缓存读取成本下降75%。作者用一句话提示语让模型完成goodcase.ai网站的UI批量优化、提示语分类系统和热度衰减算法更新。还基于杜威十进分类法、分面分类、洛克索引法、瓦尔堡好邻居法则和卢曼卡片盒笔记法等五个理论,让Fable 5.1制作了文件整理skill(carl-file-organizer)。通过3D版愤怒的小鸟游戏测试,Fable 5.1完成度高于GPT 5.6 Sol,包含4种鸟和8个关卡,物理反馈细致。但写作能力相比Opus 4.6有所退步。

技术 › Claude 卡尔的AI沃茨 2026-09-0213.4 KB 4.8K 3 76

实测智谱 GLM-5.3-Flash,我称之为能稳稳把 DeepSeek 纳入斩杀线

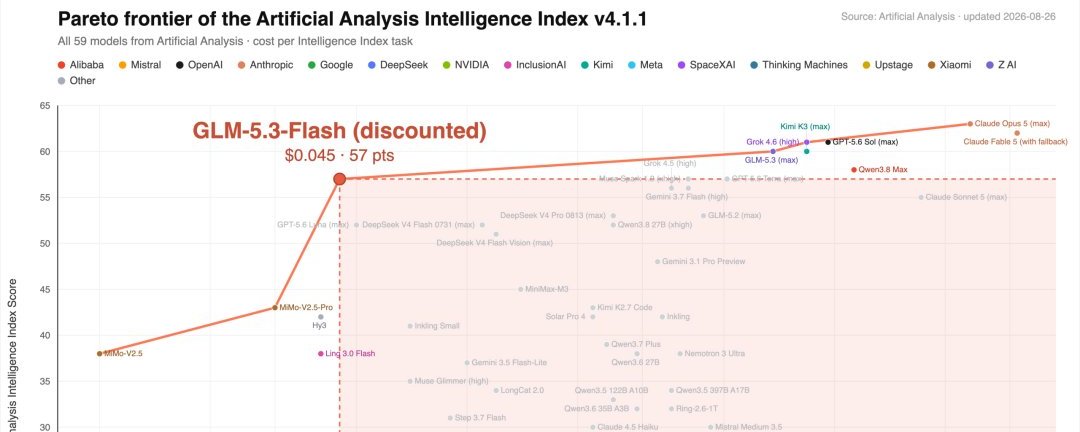
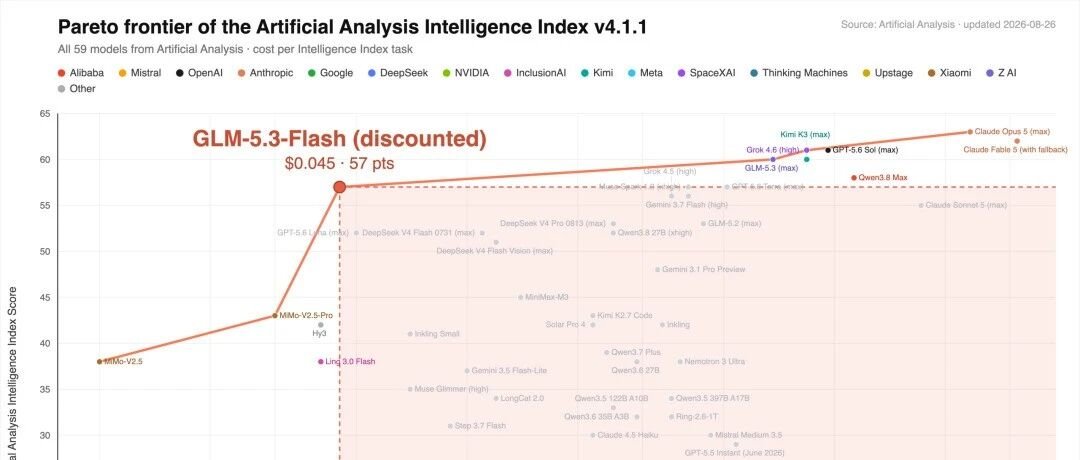
作者实测智谱新发布的 GLM-5.3-Flash 模型,对比 DeepSeek V4 Flash 的价格与性能。该模型每百万 Token 输入 0.8 元、输出 2.8 元,在 Artificial Analysis 榜单上以 $0.045 成本获得 57 智力分,14 项 benchmark 中赢 DeepSeek 11 项,视觉端六项全胜,与 Opus 4.8 对比 13 项赢 9 项。实际测试中,模型可通过一句话从截图、视频、链接复刻网站(如 GitHub、3D 游戏 Krunker),前端与视觉能力极强。作者计划将日常 coding 和 agent 任务分流给它以节省成本。

技术 › LLM 卡尔的AI沃茨 2026-08-3111.6 KB 1.9K 1 71

非常值得部署的本地小模型:写文章,做PPT,直接workbuddy里使用

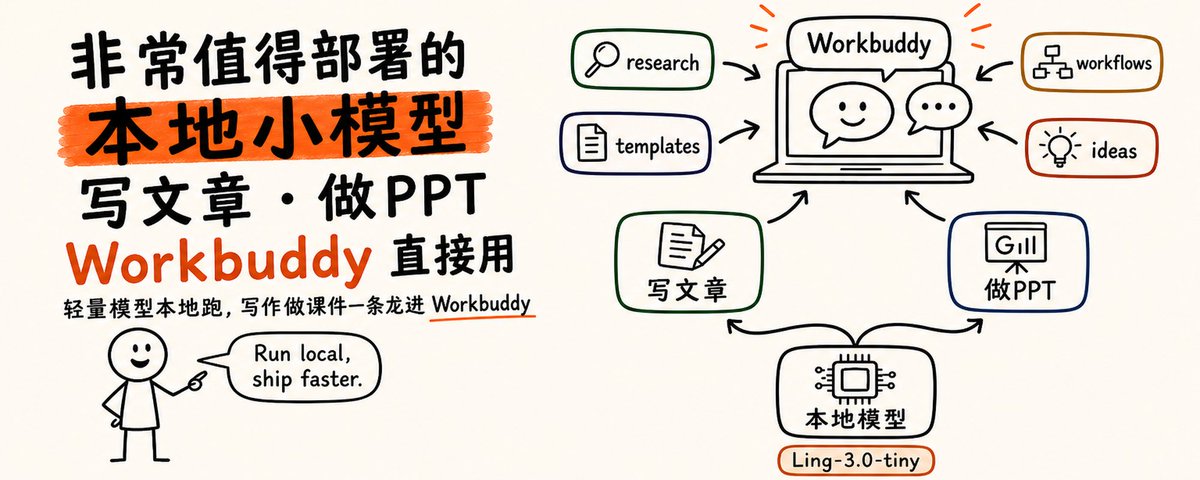
文章介绍了蚂蚁刚开源的本地小模型 Ling-3.0-tiny(7.9B 总参数,每 token 激活 1.3B),在 Apple Silicon Mac 上的部署与实测表现。作者通过让 Cursor/Codex 自动部署 Rapid-MLX 的 4bit 版本,实测 M3 Max 上首字延迟约 55 毫秒,稳态解码约 110-125 tok/s,4bit 权重仅 4.2GB。该模型适合本机快速开发、大纲草稿、纪要压缩、做课件等短任务,也可接入 workbuddy 作为日常模型,但不适合复杂推理和长知识问答。文中给出了完整部署提示词、速度测试和文案处理实测案例。

技术 › LLM 产品经理老王霸 2026-08-307.4 KB 23.3K 74 77

本地小模型实测!Ling-3.0-tiny vs Qwen3.5-9B

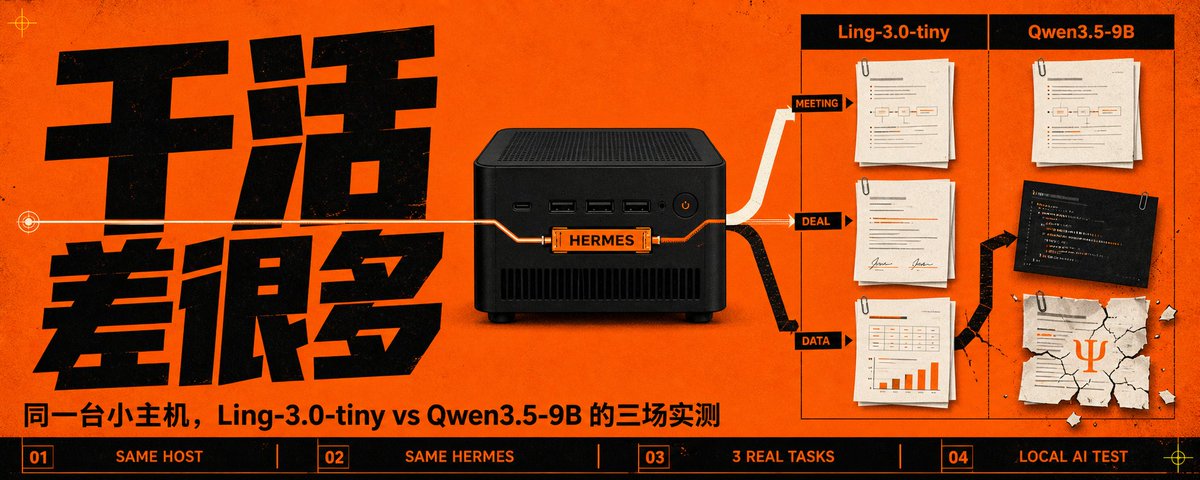
作者在 AMD Ryzen AI MAX+ 395 小主机上,用相同提示词和 Hermes 环境,对 Ling-3.0-tiny 与 Qwen3.5-9B(均 Q8_0、64K 上下文)跑三份真实业务任务:电商中台需求整理、商务合作决策备忘录、X 长文数据分析。结果 Ling 在前两轮抓住主线、输出可继续修改,总耗时仅约为 Qwen 的 56%;Qwen 在数据题上更稳,但商务任务两次失控,一次忘记任务、一次虚构公司实体。作者最终选择 Ling 作为默认模型,并强调应以模型最差一轮而非最好一轮作为取舍标准,同时收紧本地 Agent 的权限边界,保持人工把关。

技术 › LLM SakuAI 2026-08-298.2 KB 7.2K 20 83

WorkBuddy首发Hy4 preview实测:对手是Kimi K3和GLM-5.3

作者实测腾讯混元Hy4 preview模型,该模型在WorkBuddy中首发并限时免费。Arena代码榜1633分,与Grok-4.6、Claude等旗舰模型处于同一区间。作者通过Three.js体素游戏、HTML PPT制作、信息真实性核实及脏数据表分析等多维度实测,对比Kimi K3、GLM-5.3和上一代Hy3。结果显示Hy4 preview不仅规格完成度高,更在数据陷阱识别上以7/7胜出,能主动指出问题本身不成立、标注已知缺陷,展现出「敢质疑数据」的审计能力,作者认为腾讯的模型能力已真正赶上头部水平。

技术 › LLM 花叔 2026-08-2814.7 KB 13.7K 30 87

智谱GLM-5.3-Flash发布:真正的智能平权

文章揭秘了海外爆火的匿名模型OX Alpha的真实身份——智谱发布的GLM-5.3-Flash。该模型是总参数320B、激活18B的MoE架构,GLM-5系列首个原生多模态模型,支持图像、视频和文本输入,上下文达100万。其能力逼近Opus 4.8,而价格极低(每百万Token输入0.8元、输出2.8元),比DeepSeek V4还便宜一半。作者通过自建1000条新闻评测集实测发现其在精选率和品味上优于MiMo 2.5 Pro和DeepSeek V4 Pro,前端代码能力也直逼顶级模型。此外,智谱用10万张国产卡扛下了匿名测试期的全部推理流量。作者决定将AIHOT网站模型全面切换至GLM-5.3-Flash。

技术 › LLM 数字生命卡兹克 2026-08-2714.1 KB 44.9K 123 72

V4Flash 的价格、Opus4.8 的能力:智谱 GLM-5.3 Flash(Ox Alpha)正式开源

匿名模型 Ox Alpha 揭晓为智谱 GLM-5.3 Flash,320B 参数、MIT 开源、原生多模态、1M 上下文,限时价格仅为 Opus 4.8 的 1/40。作者通过三个前端场景实测:仅凭一张图用 Three.js 复刻玻璃折射海报、看录屏视频还原 60 片玻璃螺旋彩带交互网站、将静态体素海报改造为滚动揭示的 3D 网页,均表现出顶级多模态理解与代码能力,远超同价位的 DeepSeek V4 Flash,接近 Fable 5 但便宜约百倍。作者认为其把'便宜又够用'的行业斩杀线大幅推进,让预算有限的创作者也能用上前沿智能。

技术 › LLM 歸藏(guizang.ai) 2026-08-2712.0 KB 113.6K 72 77