Wiki 知识库

全部文档 / 标签: 开源模型

87 篇
清除

实测MiMo-V2.6:小米347万美元训出的开源模型深度评测

作者实测小米直播后训练的MiMo-V2.6模型。小米以直播方式公开后训练全过程,Flash和Pro合计花费347万美元,Pro在Artificial Analysis智能指数榜登上开源模型第一(46分)。作者通过五个真实任务测试:three.js程序化3D建模太和殿、高端旅行社官网前端审美、修复开源仓库真实bug、办公数据处理与核对、以及对发布仅七天的Jev模型做长程研究与幻觉控制。结果显示模型在agentic编程、审美、错误处理和事实核查上表现出色,且缓存命中率达95.7%、成本低廉,作者认为智能正走向普惠,计划将常用开源API迁移到MiMo-V2.6。

技术 › LLM 花叔 2026-09-2211.3 KB 14.5K 9 78

如何用 AI 视频模型创建高质量镜头运动

本文是 LTX-2.5 AI 视频模型的镜头运动指导教程。文章介绍了该 220 亿参数开源音视频基础模型的架构原理,指出良好的镜头运动需具备时间连贯性、意图匹配和画面完整性。作者强调使用官方文档化的镜头词汇(如 pushes in、pulls back、pans across 等),并给出最关键的提示词技巧:描述运动完成后主体在画面中的状态,为模型提供'目的地'而非仅方向。文章还讲解了帧数约束((F-1)%8==0)、提示词修复案例、多镜头剪辑中的镜头规划方法,以及复杂运动可使用 IC-LoRA 深度条件控制等确定性手段。
技术 › AI视频 LTX.io 2026-09-2214.4 KB 137K 162 84

今夜的荣光属于MiMo V2.6

文章对比评测了同日凌晨发布的Grok 4.7与小米MiMo V2.6两款大模型。作者提出大模型的"不可能三角"——性能、价格、速度难以同时满足。Grok 4.7表现低于预期,前端能力崩盘,Coding Agent评测得分惨淡;而MiMo V2.6则超出预期,AA指数46分与Grok 4.7打平,位列开源与国产第一,CritPt科研推理仅次于GPT和Claude,价格极低(缓存输入0.025元/百万Token),输出速度达130 Token/s,成为作者心中解决不可能三角的版本答案。作者还介绍了小米公开直播强化学习训练过程的创新做法及其技术报告。

技术 › LLM 数字生命卡兹克 2026-09-2219.2 KB 41.2K 103 72

爆肝 30 天,我们开源了开源模型最全实践指南(建议收藏)

作者苍何与 AgentWork 开源社区历时 30 天打造了开源模型实践指南《魔搭紫皮书》,已被 ModelScope 魔搭开源组织收录。全书 8 章 34 节、40 余万字,涵盖开源模型选型、部署运行、微调与评测、业务系统实践(如 AI 健身教练、智能客服质检)、AIGC 特别篇及 Agent 特别篇(MCP、Skill、Claude Code 等)。所有实验步骤均人工实操验证,旨在帮助开发者从下载模型到真正用好的全过程,项目开源在 GitHub,欢迎社区共创。

技术 › LLM 苍何 2026-09-177.9 KB 15.8K 128 65

建议收藏:从零到一用自然语言调出 3D 雨夜书房(附完整 Prompt + GitHub 开源地址)

作者用上海 AI 实验室新开源的 744B MoE 智能体模型 Atria Dawn Preview 做实测,通过自然语言生成一间可交互的 3D 雨夜书房:窗外下雨、桌上点灯、书架的书可取下阅读、纸笔可手写保存、还有带动画和中文朗读的立体儿童绘本。文章记录了从初始提示词到多轮返修的全过程,指出该模型能组织出可运行原型并响应反馈修改,但主体生成耗时约 219 秒、需 7 轮返修,收尾工作仍需 Codex 补充。项目代码已开源并附在线体验地址,核心结论是:提示词的每条要求都应能在成品中验收,模型能力须回到实际使用结果上评估。

技术 › LLM Berryxia.AI 2026-09-1519.7 KB 12.5K 36 75

Atria Dawn Preview:上海 AI 实验室与多所高校联合开源的智能体模型

上海 AI 实验室与多所高校联合开源了智能体基础模型 Atria Dawn Preview,面向科研工作者、开发者和专业知识工作者。该模型能自主查找资料、调用工具并运行测试,直接产出研究报告、可运行程序、文档表格、3D 模型和小游戏等可验证成果。作者实测用其纯靠代码生成精准美观的 3D 飞机模型,效果出色。该模型各项评分位居国产模型第一梯队,研发团队非常年轻,约三分之二为来自复旦、北大、上交大等高校的在校学生。

技术 › LLM Gorden Sun 2026-09-152.3 KB 58

我在 22.7B token 上从零训了一个 348M 模型,它能做 14 位加法

作者 nkthebass 从零训练了一个 348M 参数的 decoder-only 小模型 TinyBrainBot 350M V3 Math,用带纸笔(scratchpad)的竖式算术方式做计算。九项 GPT-3 算术子任务均值达 99.4%,加法干净做到 14 位,三位数乘法 98.0%。文章详细分析了首版三个缺陷的修复过程、加法天花板源于词表位名不足、减法错误集中在大小比较、应用题弱与算术高分不矛盾等发现,并分享了训练中关于联合分布控制和显式对齐步骤两个关键经验,以及 LoRA adapter 合并的意外收益。

技术 › LLM yibie 2026-09-138.4 KB 982 3 86

DeepSeek V4.1 Flash 正式发布,全面超越自家 Pro 模型?实战测评

DeepSeek 发布 552B 参数的开源 MoE 模型 V4.1 Flash,原生支持多模态视觉理解,官方称其性能、费用、速度全面超越 V4 Pro,V4 Pro 将于 9 月 14 日下线。作者通过两个实战项目(3D 程序化城市生成器、基于 draw.io 的 AI 智能绘图工具)横向对比 V4.1 Flash、V4 Pro 和 GLM-5.3-Flash。结果显示 V4.1 Flash 完成度最高,输出速度达 287 TOK/s,成本仅约 5 元/项目,多模态能力让前端开发质量明显提升,最终结论是梁神回归,可重新推荐为日常 AI 编程模型。

技术 › LLM 程序员鱼皮 2026-09-1012.8 KB 4.8K 12 73

把 Sydney Sweeney 装进 MiniMax H3:人物 LoRA 的原理和本地使用

作者拆解了 Playtime-AI 发布的 Sydney Sweeney 人物 LoRA(仅 155MB)如何在 MiniMax H3 视频模型上无需参考图、仅凭名字生成人物视频。文章讲解 LoRA 低秩自适应原理:冻结基础模型,只训练小矩阵 A、B 记录人物身份差量;还原训练过程(3440 步、120 epoch、rank 16、约 5% caption dropout);并分享本地加载实践,包括底模版本兼容、量化格式、采样步数(6 步而非 30 步才清晰)和触发词拼写等常见坑。最后指出 LoRA 技术正在改变人物身份的传播方式。

技术 › LLM Michael Guo 2026-09-0813.8 KB 32.5K 183 87

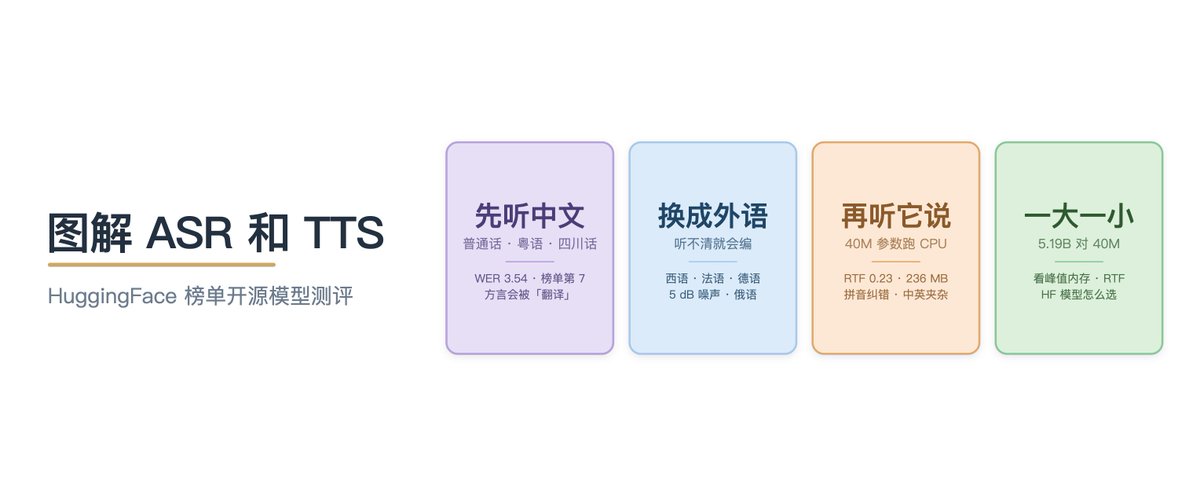
图解 ASR 和 TTS:HuggingFace 开源模型测评

作者实测了 HuggingFace 上多语种榜单第一、可本地部署的开源语音模型 Hojo-ASR-Multi-V1 和 Hojo-TTS-Light-40M。通过普通话、粤语、四川话及多国外语的实际听写测试,发现该 ASR 模型在普通话和粤语表现出色,但在方言虚词、专名和噪声场景下会出错;TTS 小模型在 CPU 上即可快速合成中英夹杂语音。文章还分析了模型体量、内存和 RTF 的关系,并给出不同场景下 ASR/TTS 开源模型的选型建议。

技术 › TTS WquGuru 2026-09-0514.2 KB 108.2K 105 86

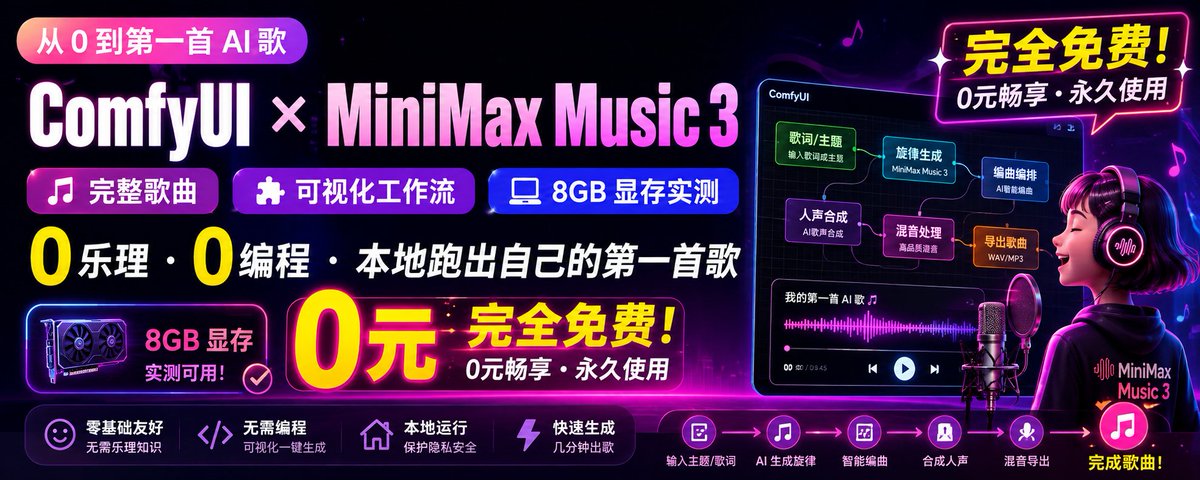
从0到第一首 AI 歌:ComfyUI + MiniMax Music 3 完全上手

本文是一篇面向零基础用户的 AI 音乐生成实战教程,讲解如何使用 ComfyUI 和开源模型 MiniMax Music 3,在本地电脑上生成最长 5 分钟的完整歌曲(含前奏、主歌、副歌、尾奏)。文章介绍了 ComfyUI 的节点式工作流概念、Comfy Desktop 安装方法、模型三件套下载配置,重点讲解了如何撰写结构化音乐描述和带段落标签的歌词,并附带可直接复制粘贴的中文抒情流行歌曲模板。教程在 RTX 4070 Laptop 8GB 显存环境实测通过,针对低显存给出了 int8 量化模型等优化建议。

技术 › TTS 小海豚笔记 2026-09-0423.8 KB 2.4K 42 80

底层看稀缺 顶层看客户:SpaceX IPO、AI 基建周期与产品化自己

本文是 indigo 8月末直播的整理,围绕“当智能变得便宜且无限供给,稀缺的东西才有定价权”这一主线展开。文章回顾了三个月内的 AI 大事:SpaceX 完成史上最大 IPO、Anthropic 估值近万亿、中国开源模型追平美国前沿、AI 基建信贷化成为“数字时代新房地产”。作者分析了软件不可投资、思考不可外包、投资 Alpha 无法由 LLM 发现等观点,指出知识工作者的护城河在于稀有数据、品位与信任;并从物理约束探讨 AI 算力瓶颈(电、内存、封装),最后落脚于“产品化我自己”——在后 AI 时代通过稀缺性构建个人竞争力。

投资 › 宏观经济 indigo 2026-09-0236.8 KB 22.9K 14 86

多数金融 AI 都是花瓶!Ling-3.0-flash-Fin 为什么才是真正生产力工具?

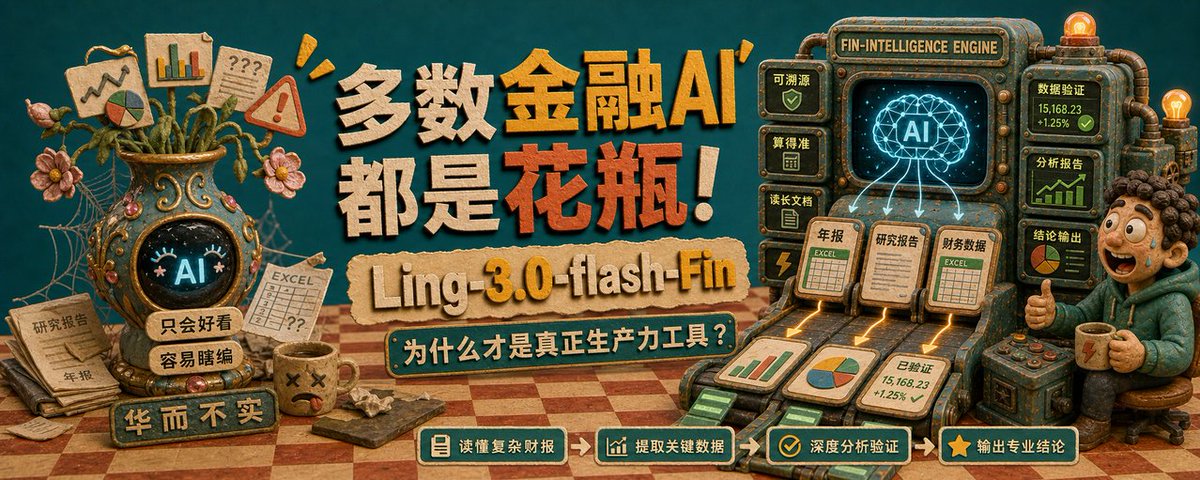
文章评测了蚂蚁百灵推出的金融专属大模型 Ling-3.0-flash-Fin,认为其与通用 AI 相比具备三大优势:内容贴合金融专业逻辑不瞎编、结论可溯源、财务计算准确。作者实测了基于 Codex 调用该模型 API 的金融探究 Demo,并梳理了六大落地场景:自动翻阅年报研报、Excel 财务建模与验算、生成分析研报初稿、银行尽调材料初审、全自动金融链式工作流、开源免费支持二次开发。文章认为该模型真正嵌入金融工作流,降低了行业技术壁垒,将重新定义金融人的工作模式,同时强调 AI 只是辅助,最终决策仍需人工复核。

技术 › LLM Modengsir AI 2026-09-029.8 KB 16.4K 132 66

Hugging Face从入门到精通:万字长文详解

本文是一篇关于Hugging Face平台的详尽入门指南,旨在帮助初学者快速上手。文章首先介绍了Hugging Face的价值,即可以自由选择模型、试用在线演示并下载到本地。随后,文章详细讲解了平台首页的五大核心区域(搜索框、Models、Datasets、Spaces、更多菜单),并指导读者如何通过Spaces体验AI应用、通过Models查找和下载模型、通过Datasets预览和获取数据。文章还深入解析了模型页面的关键信息(如模型卡、文件版本、社区讨论、许可),以及模型下载和本地使用的具体方法,包括量化版本的选择和硬件要求。最后,文章强调了数据集的预览功能,帮助用户做出明智的下载决策。全文语言通俗,步骤清晰,适合所有对AI感兴趣的读者。

技术 › 工具与效率 Miles Ma 2026-09-0127.1 KB 119.7K 472 79

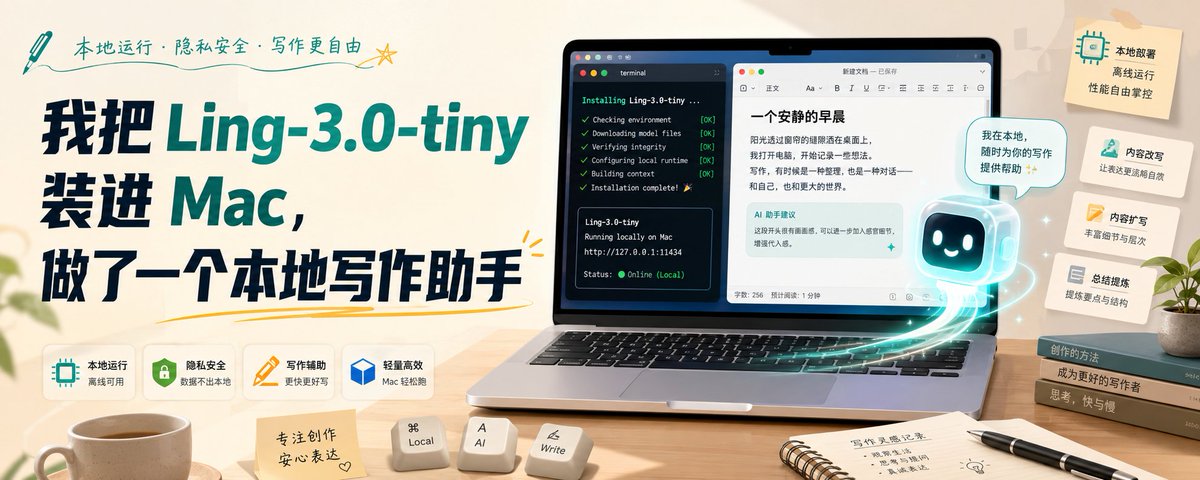
我把 Ling-3.0-tiny 装进 Mac,做了一个本地写作助手

作者记录了在 Mac mini(M4、16GB)上部署蚂蚁开源的混合推理小模型 Ling-3.0-tiny 的完整过程:编译 Ollama 实验分支、下载 FP8/BF16 权重并导入,验证服务后搭建了一个只调用本机接口的写作页面。随后用一篇真实口述稿进行四轮写作测试——提炼结构、检查问题、局部改写和反馈调整,发现模型擅长结构整理与问题扫描,但润色时 AI 味重,难以还原作者口吻。文章还对比了 FP8 与 BF16 的输入输出速度,并总结了端口冲突、上下文设置和接口安全等部署注意事项,最后给出将其用于写作第一轮辅助的定位。

技术 › LLM 小墨同学 2026-08-3017.2 KB 28.5K 40 82

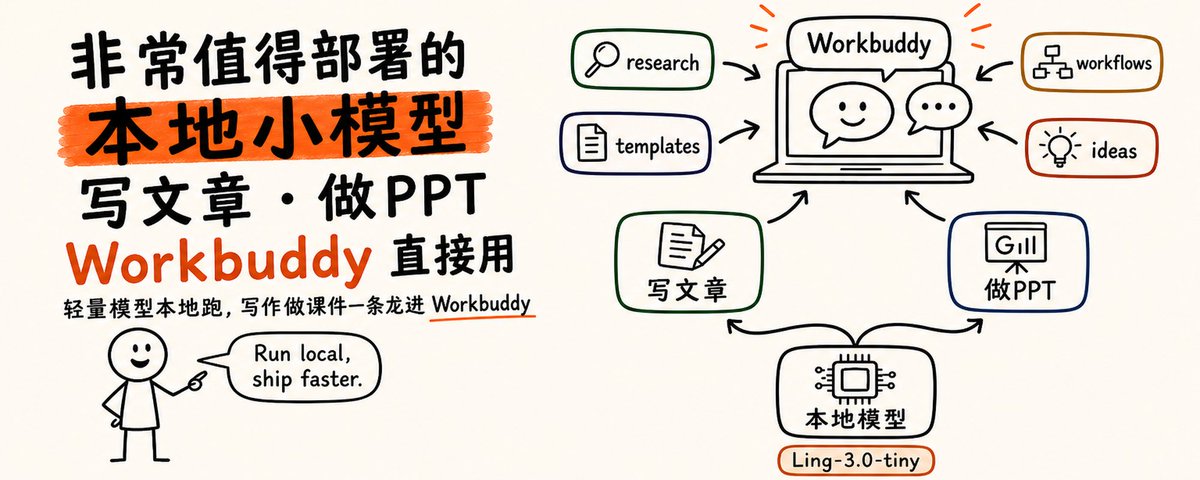
非常值得部署的本地小模型:写文章,做PPT,直接workbuddy里使用

文章介绍了蚂蚁刚开源的本地小模型 Ling-3.0-tiny(7.9B 总参数,每 token 激活 1.3B),在 Apple Silicon Mac 上的部署与实测表现。作者通过让 Cursor/Codex 自动部署 Rapid-MLX 的 4bit 版本,实测 M3 Max 上首字延迟约 55 毫秒,稳态解码约 110-125 tok/s,4bit 权重仅 4.2GB。该模型适合本机快速开发、大纲草稿、纪要压缩、做课件等短任务,也可接入 workbuddy 作为日常模型,但不适合复杂推理和长知识问答。文中给出了完整部署提示词、速度测试和文案处理实测案例。

技术 › LLM 产品经理老王霸 2026-08-307.4 KB 23.3K 74 77

BestBlogs 早报 · 08-30|腾讯开源 Hy4,Anthropic 员工用 Claude,携程推行代码即文档

本期早报聚焦 AI 能力如何进入真实任务并沉淀为组织资产。精讲一:腾讯发布开源大模型 Hy4 preview(770B 参数、激活 49B、1M 上下文),通过 CodeBuddy、WorkBuddy 等产品形成任务反馈闭环,并让模型参与推理系统自优化,端到端吞吐提升 31.8%。精讲二:Anthropic 分享员工在 Slack 中使用 Claude 的实践,通过明确搜索范围、匹配标准、事实核验与人工签字责任,把开放协作改造成可检查的工作流。精讲三:携程机票前端团队构建 Lumos,以 MR 为事件触发自动文档生成与向量知识库建设,人工维护文档时间下降 80% 以上。三条案例共同勾勒出「能力进入任务—过程接受核验—结果沉淀为资产」的完整实践路径。

技术 › LLM ginobefun 2026-08-3033.2 KB 6.8K 3 75

Herman:现在是 1998 年!AI 泡沫还没来

本文是 168X 战情室访谈精华,半导体研究与高频交易背景的嘉宾 Herman 系统阐述了对 AI 行业与美股半导体的最新判断。他作为 6 月第一批看空者如今翻多:Anthropic ARR 下修等利空落地后市场未踩踏,杠杆已出清;锚定 Anthropic/OpenAI 是错的,二者只消耗 27% 算力,微软等 CSP 企业端盈利快速兑现,用卡回本周期极短。他判断当前类似 1998 年而非 2000 年互联网泡沫,真正泡沫尚未到来。节目还讨论开源模型改变 CSP 处境、存储高 margin 难以为继、补涨轮动到光/CPU/功率、Apple 扶持英特尔、老黄 5,000 亿基建融资局、币圈与散户建议等议题,并警示 token 用不满的人将先被淘汰。

投资 › 股票 168X(Mr. Z 对谈 Herman) 2026-08-2835.8 KB 413.4K 371 80

爆火的《牛来》模型正式发布!GLM-5.3-Flash 实战测评

匿名爆火的「牛来」模型 Ox-Alpha 揭晓身份,是智谱的首个原生多模态模型 GLM-5.3-Flash。仅 320B 参数(激活 18B),能力对标 Claude Opus 4.8,价格仅其 1/40,MIT 协议开源,跑在 10 万张国产芯片上。作者使用智谱官方 Harness 工具 ZCode 进行三个项目实测:复刻 Apple Vision 产品页、开发全栈 AI 绘图工具、制作 3D 联机对战游戏《牛来格斗》。测评显示其视觉理解与截图自主验证能力对 AI 编程体验提升巨大,长程任务稳定,但实时网络同步等后端难点仍有不足。

技术 › LLM 程序员鱼皮 2026-08-2818.9 KB 14K 9 72

2026 开源模型全网最全盘点:从入门到榨干(含双机实测)

文章系统盘点了 2026 年值得关注的开源 AI 模型,涵盖语言、图片、视频三大类别,包括 Qwen、DeepSeek、Kimi、GLM、MiniMax、混元等国产阵营及海外模型。作者拆解了模型命名规则(参数量、MoE、量化、许可证等),提出五步选型筛选法,并比较各硬件平台(Mac 统一内存、NPU AI PC、大内存 APU 等)的适配能力。文章还讲解了本地部署的适用场景与许可注意事项,最后通过 Mac 和 Windows 双机实测检验模型在文字、看图、分镜和视频任务上的真实表现,帮助读者判断自己需要哪类模型以及电脑能否带动。

技术 › LLM 诺鸭船长3 2026-08-2735.5 KB 44.1K 51 87

对标 Opus 4.8,价格只有 1/40,“牛来”模型 GLM-5.3-Flash 实测

智谱发布 GLM-5.3-Flash 模型(320B 总参数、仅激活 18B),即此前在 X 上爆火的匿名“牛来”模型。其 AA 综合智能指数达 57 分,与 Opus 4.8 相当,但价格仅为后者的 1/40,并采用稀疏注意力+线性注意力混合架构,由国产芯片支撑全部线上推理流量。作者通过多个实测案例展示模型能力:一句话从 PDF 生成企业官网、生成带真实图片的 PPT、模拟 Omarchy Linux 界面、构建在线 Excel、开发多款小游戏,以及用多模态能力自动剪辑《楚门的世界》电影解说视频。文章认为该模型以架构创新和国产算力打破了“前沿模型必然昂贵”的逻辑,且已以 MIT 协议开源。

技术 › LLM 向 向阳乔木 2026-08-2715.3 KB 26.7K 22 77

V4Flash 的价格、Opus4.8 的能力:智谱 GLM-5.3 Flash(Ox Alpha)正式开源

匿名模型 Ox Alpha 揭晓为智谱 GLM-5.3 Flash,320B 参数、MIT 开源、原生多模态、1M 上下文,限时价格仅为 Opus 4.8 的 1/40。作者通过三个前端场景实测:仅凭一张图用 Three.js 复刻玻璃折射海报、看录屏视频还原 60 片玻璃螺旋彩带交互网站、将静态体素海报改造为滚动揭示的 3D 网页,均表现出顶级多模态理解与代码能力,远超同价位的 DeepSeek V4 Flash,接近 Fable 5 但便宜约百倍。作者认为其把'便宜又够用'的行业斩杀线大幅推进,让预算有限的创作者也能用上前沿智能。

技术 › LLM 歸藏(guizang.ai) 2026-08-2712.0 KB 113.6K 72 77

Pi Agent + Qwen 3.8 27B 深度优化

作者在懒猫AI算力舱 X5(128GB显存)上部署 Qwen 3.8 27B 稠密模型,真实项目中跑了4个任务均完成良好。通过 MTP 投机解码 + NVFP8 混合优化并关闭 thinking 模式,速度从 13.9 提升到 30.8 Tokens;但发现关闭思考模式会降低代码推理准确度,重新开启后实测稳定 26.47 Tokens(含思考阶段实际可达 35.23 Tokens/s)。后续还将通过重新量化构建 draft engine 进一步提速。

技术 › LLM Andy Stewart 2026-08-252.7 KB 26.1K 42 55

一次性讲清楚 Qwen3.8 27B 的本地部署

本文详细介绍如何在本地部署阿里开源的 Qwen3.8 27B 模型,覆盖 Mac 和 N 卡两条路线,并附 4090 实测数据。作者通过四轮质量测试发现 9.83GB 压缩版在短任务上与 30GB 版本打平,指出 12GB 游戏卡即可运行。文章系统讲解硬件选型、量化版本选择、KV Cache 显存计算、MTP 加速配置及常见踩坑,强调窗口大小只占显存不影响速度这一关键认知,是一篇面向零基础用户的完整部署指南。

技术 › LLM huangserva 2026-08-2571.4 KB 296.8K 683 91

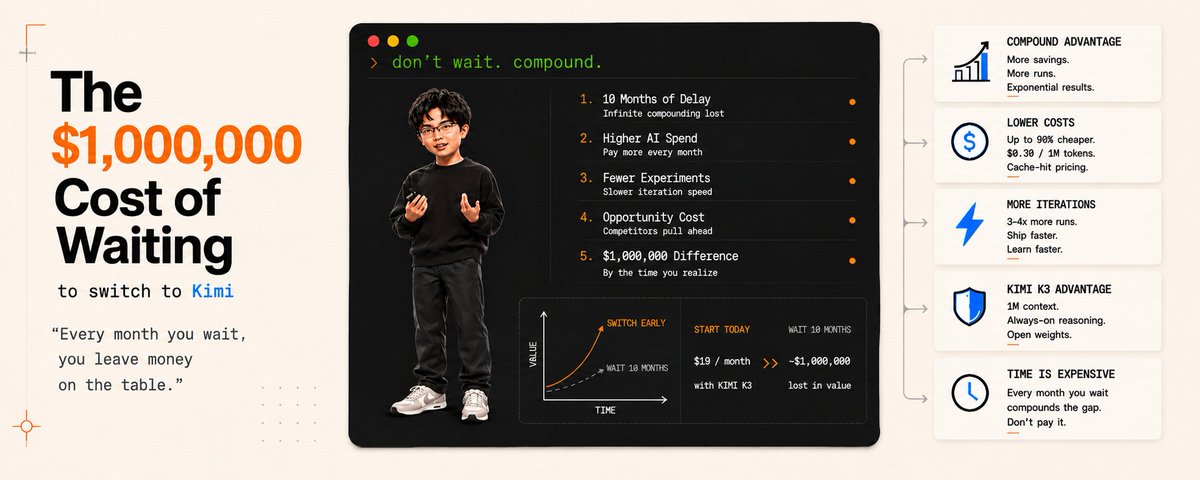
等待切换到 Kimi 的百万美元代价

文章以复利投资为类比,论述延迟切换到更便宜的 AI 模型(如 Kimi)的隐性成本。通过 Emma 和 James 两位投资者的对比说明时间复利的威力,指出 AI 开发中省下的推理成本可转化为更多实验、更快学习,形成复利式优势。昂贵推理就像投资中的管理费,悄无声息地拖累长期发展。建议按任务匹配模型,尽早利用低成本推理加速产品迭代,因为错过的实验时间无法事后弥补。

技术 › LLM leopardracer 2026-08-249.8 KB 406.1K 150 52

本地部署的Ling-3.0-tiny实测:7.9B小模型能把活干好吗

作者在128GB统一内存小主机上本地部署开源MoE模型Ling-3.0-tiny(7.9B参数,激活1.3B),用llama.cpp Vulkan加载Q8_0量化版本。实测任务是将2360行、2小时17分的客户会议飞书妙记转写交给模型,进行需求提取、实施方案搭建和报价结构整理。结果显示:模型能在235秒内完成需求提取,方案模块划分与人工方案接近,但时间戳偶有不准需人工复核。经提示词调优后,碰撞长度上限次数从16次降至3次。作者认为它适合承担会议整理、需求归类等“脏活”,但范围、价格、承诺等决策仍需人负责,并推荐在真实业务场景中使用。

技术 › LLM 阿川 | AI thinking 2026-08-247.6 KB 20.7K 59 78

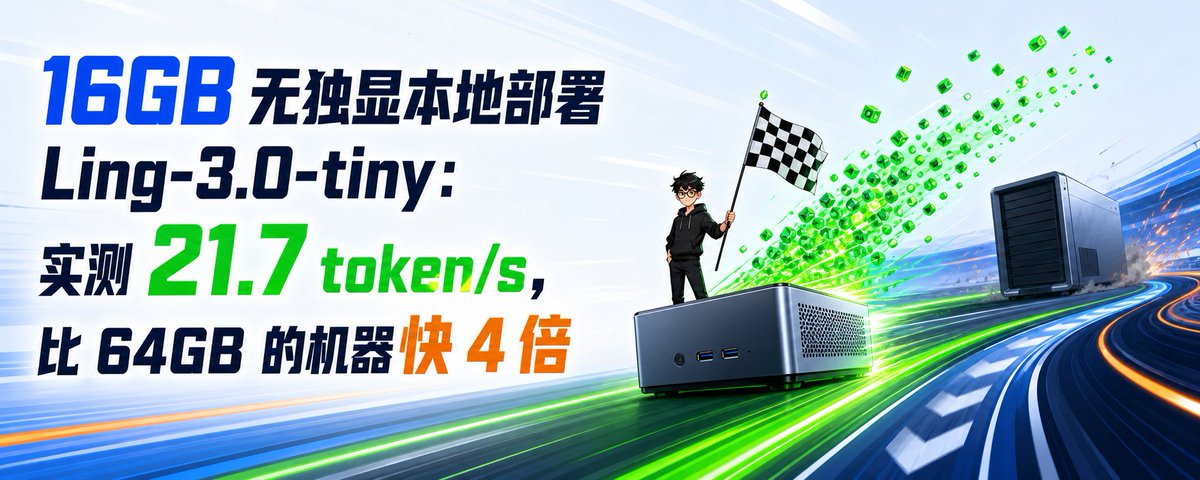
16GB 无独显本地部署 Ling-3.0-tiny 实测:21.7 token/s 与推理引擎版本的秘密

作者在一台单通道 16GB 内存、无独显的 Ryzen 5 5600G 台式机上,使用 llama.cpp 官方版部署 Ling-3.0-tiny(Q4KM 量化),实测生成速度 21.70 tok/s,比配置更强的 64GB+3090 机器快近 4 倍。经排查,差异源于推理引擎版本而非硬件。文章还分析了该模型线性注意力架构带来的超低上下文内存开销(约 6.79 KiB/token),总结了思考模式、Windows 编码、线程设置三个实践坑,并给出三步部署教程,证明普通电脑即可流畅本地运行该模型。

技术 › LLM 阿良|AI 工作流 2026-08-2414.2 KB 71.3K 177 90

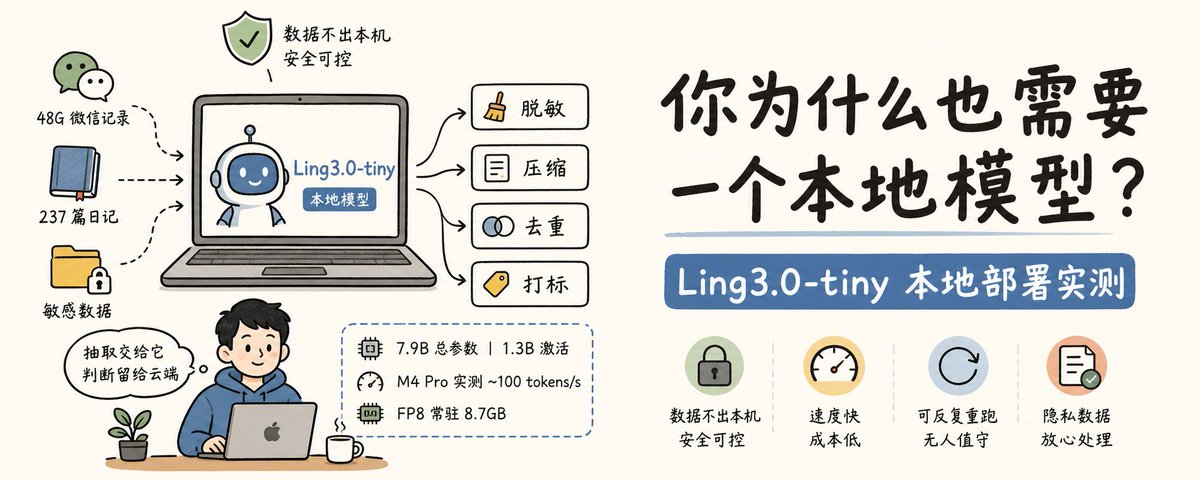
你为什么也需要一个本地模型?Ling3.0-tiny 本地部署实测

作者介绍了在 MacBook M4 Pro 上部署蚂蚁百灵开源的 Ling-3.0-tiny 稀疏 MoE 模型的完整过程,用于处理 48G 微信记录和 237 篇日记等隐私数据。文章详述了 FP8 权重选择、编译 MLX 后端 ollama、避坑指南等实操细节,实测生成速度约 78-99 tokens/s。在脱敏、命名实体识别、长文压缩、去重四个场景中表现优异,并总结分工原则:抽取任务交给本地模型,语义判断留给云端模型。

技术 › LLM 柯基是只猫 2026-08-2412.2 KB 20.2K 102 92

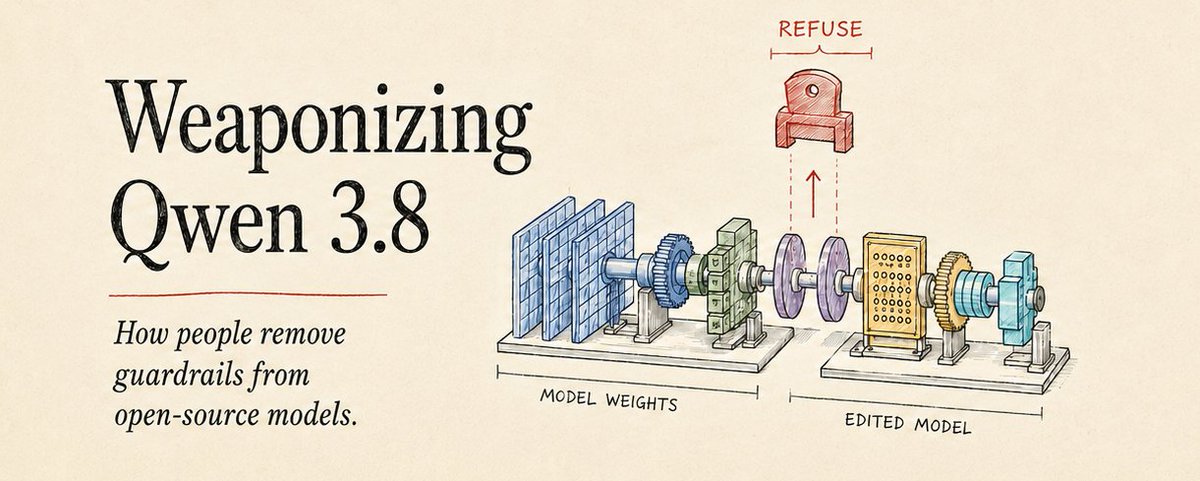
解除 Qwen 3.8 的安全护栏:Abliteration 技术解析

文章探讨网络上流传的'无审查'Qwen 3.8 模型。作者测试发现官方原版 Qwen 3.8 对有害请求全部拒绝,所谓无审查版本实为经过 abliteration 处理的衍生模型。Abliteration 是一种永久性的权重修改技术,基于 2024 年 Arditi 等人的研究发现:模型的拒绝行为由内部单一方向向量介导。通过对比有害与无害提示在残差流中的激活差异,用 PCA 找出拒绝方向并从权重中减去,从而移除拒绝反射但保留模型知识。相关衍生模型在 Hugging Face 上已获超 76 万次下载。

技术 › 网络安全 Scott Williams 2026-08-2222.5 KB 42.1K 157 72

AI 产业挖掘机:泡沫爆了再去捡!2027 是杀伤力很大的一年

本文是 168X 节目对 AI 产业挖掘机的访谈摘要。嘉宾认为,当前 AI 产业存在短期泡沫,Coding 之外缺乏新应用场景,开源模型冲击闭源模型,上游高毛利难以持续,AI 投资更像房地产而非 2000 年互联网泡沫。他建议散户空仓等待泡沫破裂,再捡拾政府会救的公司,并预警 2027 年可能是指数跌幅很大的一年。

投资 › 宏观经济 168X 2026-08-2131.6 KB 53.6K 55 74