Wiki 知识库

全部文档 / 标签: 量化

40 篇
清除

推理是训练的 12 倍,可一块卡生成时只跑出 5% 的算力

文章基于 YC Paper Club 播客,剖析 LLM 推理成本真相:按两年模型寿命摊算,推理总算力约为训练的 12 倍。decode 阶段 MFU 仅 5%,瓶颈在显存带宽而非算力。DeepSeek 通过 KV cache 保留 72 小时、radix attention、零开销调度等手段将缓存命中率做到 96%,实现 38 美元一卡时、80% 毛利。文章还讨论了 SSM 等被低估的模型结构、服务商质量参差(同一模型不同服务商差距超开源闭源差距)以及开源推理生态的规模,指出推理成本优化才是 LLM 竞争的胜负手。

技术 › LLM Saito 2026-10-268.7 KB 140 77

LoRA 与 QLoRA:用一块 GPU 微调大模型

本文从“模式”(一列乘一行的秩1矩阵)概念出发,系统讲解 LoRA 与 QLoRA 如何降低大模型微调的显存开销。LoRA 通过低秩近似冻结原有权重,只训练少量新增模式(B·A),将可训练参数减少到约万分之一;量化则用 4 位 NF4 格式配合分块缩放和双重量化存储权重,保留全部模式但降低每个数的精度。QLoRA 结合两者:冻结权重用 4 位存储,LoRA 分支用 16 位训练,使 65B 模型只需一块 48GB GPU 即可微调,Guanaco 在 Vicuna 评测中达到 ChatGPT 的 99.3%。文中还比较了低秩近似与量化误差结构的不同,并给出 7B 模型显存估算:全参数微调约 100GB,LoRA 约 15GB,QLoRA 约 5GB。

技术 › LLM Dongxi 东锡 NLP 2026-10-2412.7 KB 13K 32 76

Cerebras 如何部署万亿参数前沿模型

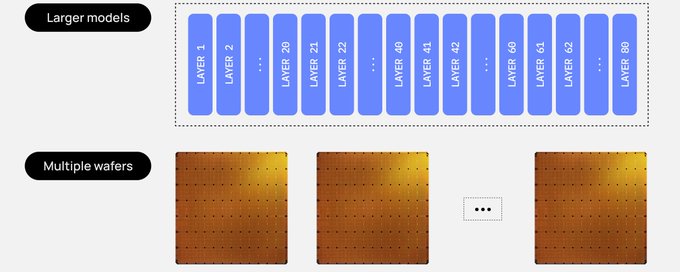
Cerebras 团队详细介绍了如何在 WSE-3T 晶圆级芯片上部署万亿参数大模型。以 3 万亿参数的开源模型 Kimi K3 为例,团队通过 4-bit 权重量化和 8-bit KV 缓存计算每层约 16 GB 的显存需求,将模型切分到 59 片晶圆上:每个 dense 层独占一片晶圆,每片可放两个 linear-attention 层。晶圆间通过以太网 RDMA 传递激活值,权重无需移动。系统以流水线方式运行,各阶段可同时处理不同请求和微批次,从而实现 1000-2000+ tokens/秒的推理速度。

技术 › LLM Sarah Chieng 2026-10-239.9 KB 282.4K 816 85

How to Build the Most Powerful AI Trading System (Hedge Fund Infrastructure)

文章阐述了如何构建对冲基金级别的 AI 交易系统。作者指出,AI 模型本身不是瓶颈,缺乏基础设施才是关键:散户 AI 缺少数据、算力和交易执行三大层。数据层需避免幸存者偏差和前视偏差;算力层需要集群化回测;交易层需全天候执行。通过 MCP 协议,可将 Claude、ChatGPT 等 AI 接入 QuantGPT 终端,获得机构级数据仓库、云端研究算力和实盘交易能力,以远低于 Bloomberg 终端(约 3 万美元/年)的成本(49-149 美元/月)构建完整 AI 交易系统。

投资 › 量化交易 Roan 2026-10-1720.3 KB 1.1M 970 64

把 96.5GB 的 GLM-5.3-Flash 塞进单张 4090 48GB,跑出 41.8 token/s

本文记录了在单张魔改 RTX 4090 48GB 上,通过系统级调优将 96.5GB 的 MoE 模型 GLM-5.3-Flash 推理提速至 41.8 token/s 的完整工程实录。作者采用混合 i-quant 量化,将 12,096 个专家常驻显存与锁页内存,通过实测发现减少 CPU 线程反而提升 42% 速度、扩大显存池至 46GB 带来质变、以及激进的 PCIe 搬运策略是致命代偿陷阱。文章逐毫秒拆解了 24.47ms 的 token 耗时去向,指出 PCIe 搬运是硬瓶颈,并对比了更稀疏的 Qwen3.8-Flash-Next 架构可达 120 tok/s 的原因。

技术 › LLM huangserva 2026-10-1217.6 KB 9.3K 57 89

16.9 MB 的语音识别,和它不认识的语言

Cactus Compute 发布了 16.9 MB 的本地语音识别模型 Whistle,纯 CPU 运行、无依赖,与同公司的 Needle 模型共享引擎。作者实测发现:七种欧洲语言(英德法西意荷波)识别准确度高,首 token 仅 5-8 毫秒,解码速度约 1300 token/秒,官方性能数据基本可信。但关键缺陷在于:遇到不支持的语言(如中文、日文)时,模型不会报错也不会返回空,而是硬套进已知语种生成'假词',造成静默污染。文章指出该模型设计目标是端上语音自动化入口而非单纯转写,并提醒中文用户慎用。

技术 › TTS yibie 2026-10-116.2 KB 4.4K 36 83

Karpathy的本地LLM加速技巧终于有了完整解决方案:Uzu推理引擎

文章回顾了Karpathy在2023年指出的本地LLM推理瓶颈:解码阶段受限于内存带宽,每次前向传播只生成一个token,使得推理速度存在硬上限。以M5芯片和4-bit Qwen3.5 9B为例,理论极限约29 token/s,llama.cpp和MLX接近该上限。开源推理引擎Uzu通过组合优化突破瓶颈:采用4-bit/8-bit整数量化降低内存流量,利用M5的int8硬件加速路径,在量化前应用块对角随机Hadamard变换抑制离群值误差,并通过推测解码一次性验证多达16个草稿token。实测Uzu在M5上达到92-117 token/s,显著超越llama.cpp和MLX。

技术 › LLM Akshay 2026-10-0928.4 KB 115.2K 257 78

12G显存部署125B Qwen3.8-Flash-Next 全攻略

本文介绍了如何借助Strata框架和Agent自动化流程,在12GB消费级显卡上部署125B参数的MoE模型Qwen3.8-Flash-Next。文章解释了MoE稀疏激活(每token仅激活6B)与Strata让GPU、CPU、RAM、SSD协同工作的原理,对比了不同量化方案(UD-IQ4_XS与UD-Q4_K_XL)在专家缓存命中率上的速度差异。作者全程使用蚂蚁的Ling-3.1-flash Agent完成从读文档、检查硬件、安装、排错到测速验收的部署流程,并成功将本地模型接入pi。该方法可复用于部署Ling、GLM、Kimi、DeepSeek等其他本地模型。

技术 › LLM 实践哥 Li 2026-10-087.4 KB 159.4K 454 79

12G显存部署125B Qwen3.8-Flash-Next 全攻略

本文介绍如何在12GB显存上部署125B参数的Qwen3.8-Flash-Next模型。核心是Strata技术让GPU、CPU、RAM和SSD协同工作:常用专家留GPU,其余放RAM,CPU处理cache miss。RTX 5070 12GB + 64GB RAM在Q2_0量化下短对话可达94 tok/s。文章还讲解了量化选择策略——显存占用相同时速度可差1.72倍,关键在于专家命中率。作者全程使用蚂蚁的Ling-3.1-flash Agent自动完成从检查机器、选权重、下载安装到排错验收的完整部署流程,跑通了一套用Agent自动部署本地模型的可复用方法。

技术 › LLM 实践哥 Li 2026-10-087.4 KB 79

AI 工程师面试:大厂反复考的 25 道通用题

文章总结了 AI 工程师面试中各科技大厂(OpenAI、Meta、DeepSeek、Anthropic 等)反复考察的高频题目,覆盖三大模块:LLM 内部原理(attention、KV cache、RoPE、MoE、scaling laws、解码策略等)、推理部署与 GPU 性能(continuous batching、PagedAttention、量化、并行策略、显存估算、延迟指标等),以及 RAG、Agent、微调、评测、安全、多模态、系统设计等方向。作者指出各家面试题高度重合,建议优先刷这些通用题以获得最高性价比。

技术 › LLM 山景城小路 2026-10-073.7 KB 21.2K 258 71

权重压到 4 bit,大模型为什么还能工作?

文章以 Qwen3.8-27B 为例,系统讲解大模型权重量化的原理。从参数如何参与矩阵乘法运算入手,说明 bit 数与编码格式(FP16、BF16、INT4)的关系,演示 0.73 如何被 4 bit 编码为 0.8 并引入误差。深入分析了刻度选择中范围、分辨率与截断误差的取舍,权重误差如何随输入放大为输出误差,以及 GPTQ、AWQ、PTQ、QAT 等量化方法如何利用校准数据控制误差。最后估算 4 bit 模型的存储大小(约 13.5-19 GB),讲解 KV 缓存、混合注意力结构对显存的影响,并给出选择和评估本地量化模型的实用建议。

技术 › LLM gKev1n 2026-10-0511.9 KB 4.9K 36 84

MIT 新课 6.5940 TinyML 与高效 AI 计算(MIT HAN Lab):从剪枝量化到大模型部署与分布式训练的效率全栈课

文章介绍 MIT 韩松(Song Han)实验室开设的高效机器学习旗舰课程 6.5940 TinyML and Efficient AI Computing。课程分四章递进:高效推理(剪枝、量化、蒸馏、NAS)、面向特定领域的优化(TinyML、LLM 量化部署、长上下文、扩散模型)、高效训练(分布式训练、设备端训练)及进阶专题。课程以动手为中心,无考试,由 5 个 Lab(从 GPU 编程到本地 LLM 部署)和 NeurIPS 模板期末项目构成评分。作者认为该课程知识体系完整、与研究前沿零距离、工程实践导向鲜明,是学习模型压缩、LLM 推理优化和 TinyML 的最佳公开课,所有视频和课件均已公开。

技术 › LLM meng shao 2026-09-308.1 KB 5.3K 56 79

「Learn Inference」LLM 推理工程全景指南:从 Attention 内核到多云 GPU 容量,两阶段、三层栈、五大技巧

本文是 Philip Kiely 所著《Inference Engineering》的交互式伴读站点介绍,系统梳理 LLM 推理工程全貌。文章以 prefill/decode 两阶段为原子结构,按运行时、基础设施、工具链三层展开,逐章讲解模型结构(Attention、KV 缓存、MoE)、GPU 硬件选型(带宽 vs 算力)、软件栈(vLLM、SGLang、TensorRT-LLM)、五大优化技巧(量化、投机解码、缓存、并行、解耦)以及多模态与生产实践(扩缩容、路由、成本、可观测性)。核心思想是:先诊断瓶颈再优化,一切优化皆是权衡,具体知识会过期而底层约束移动缓慢。

技术 › LLM meng shao 2026-09-2918.6 KB 3.4K 11 86

LLM Inference Handbook 精读:Prefill、Decode、KV Cache,与一切皆权衡的推理工程

本文深度解读 Modular 公司开源维护的《LLM Inference Handbook》,系统梳理 LLM 推理工程的知识体系。文章提炼三大核心框架:prefill(算力受限)与 decode(带宽受限)的两阶段二分法;KV cache 作为系统中心约束的地位,围绕它的 PagedAttention、prefix caching、PD 分离等技术网络;以及“一切皆 trade-off,唯一方法论是 benchmark”的工程哲学。内容还涵盖 continuous batching、speculative decoding、GPU 内存金字塔、FlashAttention、量化与蒸馏三部曲、Agent 生态与部署运维等主题,强调推理优化的本质是围绕有状态 KV cache 做内存管理与调度。

技术 › LLM meng shao 2026-09-2218.3 KB 14.6K 139 84

深入解读斯坦福在线课程 MS&E 319「高效生成式语言模型」

本文深入解读斯坦福 2026 秋季研究生课程 MS&E 319《Efficient Generative Language Models》。该课程以「效率」为设计科学,在算力预算有限的约束下,沿大模型生命周期系统讲授预训练、架构、推理、后训练四阶段的效率技术,包括多 token 预测、Muon 优化器、MoE、稀疏注意力、FlashAttention、KV 缓存压缩、量化、投机解码、LoRA、DPO 与蒸馏等,并涵盖越狱攻击与模型窃取等安全议题。文章认为该课填补了教育生态空位,内容前沿性与领域同步,揭示了每项效率技术背后的权衡取舍。

技术 › LLM meng shao 2026-09-2111.5 KB 18.9K 95 68

深读免费书「Inference Engineering」:Prefill 吃算力、Decode 吃带宽,讲透从 CUDA 到生产部署的推理优化

文章深度解读 Baseten 出版的免费工程书《Inference Engineering》,系统讲解如何把 AI 模型在生产环境中跑得快、省、稳。全书以三层推理栈(运行时、基础设施、工具层)为骨架,核心分析框架是瓶颈判断:prefill 算力受限、decode 带宽受限、图像视频生成算力受限。内容涵盖模型与硬件理解(算术强度、KV cache、选卡策略)、软件栈(vLLM/SGLang/TensorRT-LLM 三大引擎对比)、五大加速技术(量化、投机解码、缓存、并行、分离部署)及其交互关系,以及生产化部署的延迟全栈账本、故障处理与成本核算,强调约束换性能、技术按组合评估等基本原则。

技术 › LLM meng shao 2026-09-2111.2 KB 13.1K 145 84

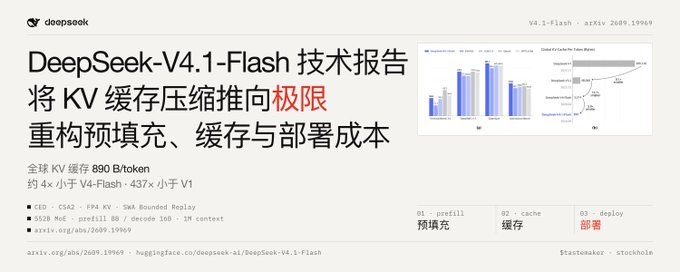
DeepSeek-V4.1-Flash 技术报告:将 KV 缓存压缩推向极限,重构预填充、缓存与部署的成本结构

本文深度解读 DeepSeek-V4.1-Flash 技术报告,该模型通过 CED 不对称编码器-解码器架构、CSA2 跨层稀疏注意力复用、FP4 主 KV 量化及 SWA Bounded Replay 近似恢复四项设计,将常驻 HBM 的全局 KV 缓存降至 890 bytes/token(约为上一代四分之一),持久化缓存降至八分之一。文章详细解析各项技术的原理与协作机制,澄清了对压缩数字的常见误读,评估模型能力变化,并与 PagedAttention、MiniCache 等已有 KV 压缩路线对比,指出该工作将缓存压缩从算法点推进为面向百万 token 长程 agent 场景的系统级共同设计,同时讨论其证据强度与局限。

技术 › LLM meng shao 2026-09-1921.7 KB 7K 25 82

显存就这么多,怎么把字吐得更快?——从 MoE、KV Cache 到 DFlash 的本地部署全景拆解

文章从一张16GB显卡出发,系统拆解大模型本地部署的显存与速度权衡。首先澄清运行显存不只包含模型权重,还有KV Cache、运行时工作区和草稿模型开销;解释MoE与量化对容量和计算的不同影响,区分总参数与激活参数;分析CPU/GPU卸载的代价;介绍KV Cache与混合注意力如何影响上下文长度;区分Prefill与Decode两个阶段的速度特征;最后详解投机解码、MTP与DFlash/DFlash2的加速原理及实测收益。强调各优化手段需配合使用,预算刚好装满并不代表能稳定运行。

技术 › LLM huangserva 2026-09-1423.1 KB 9.9K 69 84

The Math Needed for AI Inference Engineering (Complete Roadmap)

本文系统梳理了AI推理工程所需的核心数学知识路线图。内容涵盖:浮点数表示(FP32/FP16/BF16/FP8/INT8等格式的位分配与精度/范围权衡)、舍入误差累积、溢出与下溢、机器epsilon、灾难性消除及稳定softmax与log-sum-exp技巧;量化数学,包括scale与zero-point线性映射、对称/非对称量化、粒度选择、范围裁剪、激活离群值处理及基于Hessian的曲率方法;以及线性代数计算成本分析,如矩阵乘法的浮点运算量与内存读写开销估算。作者强调在性能分析前能手算层耗时是推理工程中最有价值的习惯。

技术 › LLM vixhaℓ 2026-09-0827.9 KB 93.1K 870 85

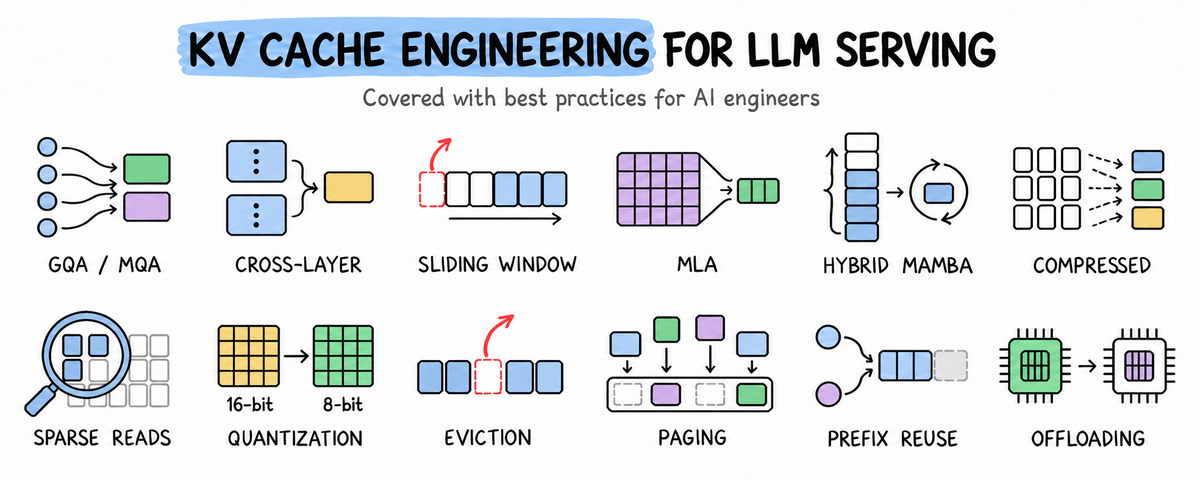
KV Cache Engineering for LLM Serving, clearly explained

文章系统讲解了LLM推理中KV缓存的工程优化。KV缓存随序列长度增长,Llama 3.1 70B单条128K序列的BF16缓存约需40GB,成为GPU内存和注意力计算的双重瓶颈。作者将12种优化技术按减少的对象分类:GQA/MQA减少KV头数量,跨层注意力减少缓存层数,滑动窗口与淘汰减少保留token数,MLA减少表示宽度,量化减少字节数,混合循环层用固定状态替代增长缓存,分页与前缀复用减少分配浪费。文章配有可运行代码示例,并分析各技术的适用场景与权衡。

技术 › LLM Avi Chawla 2026-09-0640.4 KB 206.5K 557 82

读懂大模型|别怕,大模型的本质就是一个函数

文章以 DeepSeek 开源的 V4-Flash-Vision-Exp 为例,深入浅出地讲解大模型的本质:一个做矩阵运算的超大函数。作者介绍了模型文件结构(权重分片、config.json、tokenizer.json),并详细解析输入输出处理流程,包括文本分词、BPE 算法、Embedding、MoE 混合专家架构、概率性输出与自回归生成机制。此外还逐项解读了核心参数,如词表大小、网络层数、注意力头数、YaRN 长上下文伸缩、视觉模块和 FP8/FP4 低精度量化等,帮助读者建立对大模型原理的整体认知。

技术 › LLM ray 2026-09-0413.7 KB 2.9K 7 74

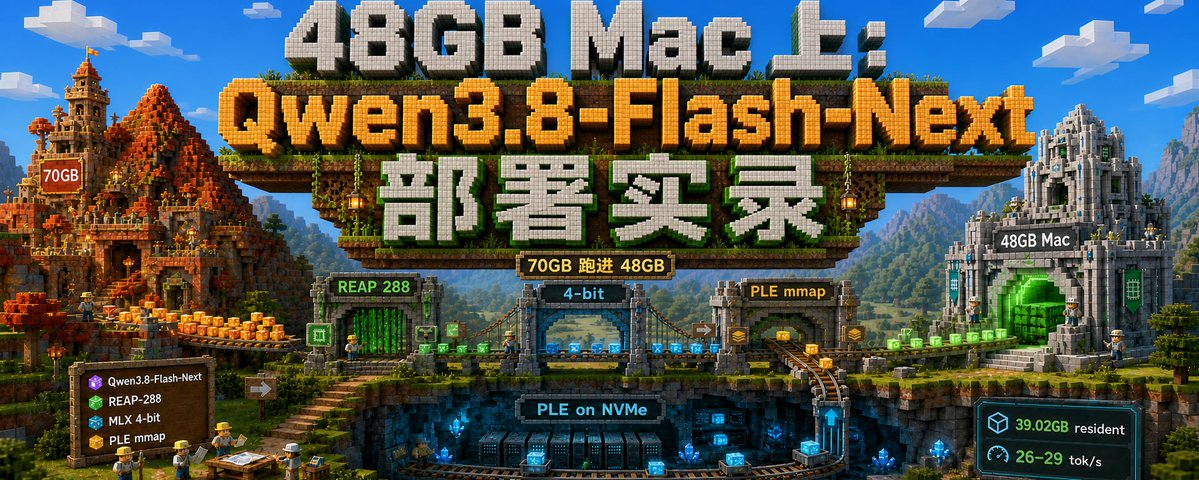
70GB 模型跑在 48GB Mac 上:Qwen3.8-Flash-Next 部署实录

作者在 48GB 内存 MacBook Pro(M4 Pro)上成功部署了磁盘体积约 70GB 的 Qwen3.8-Flash-Next REAP-288 MLX 4-bit 模型。文章解析了能跑起来的三重原因:REAP 将每层 512 个专家裁剪至 288 个、主模型与 PLE n-gram 表均做 4-bit 量化、以及 51B 参数的 PLE 表通过 mmap 留在 NVMe 按需流式读取。实际驻留约 39GB,首次加载约 10.14 秒,decode 稳定在 26~29 token/s,prefill 峰值约 149 token/s。实测最大上下文仅 8,217 tokens(配置声明 262K),建议日常使用 7,680 tokens。文章还记录了 Metal 内存上限调整、oMLX 服务启动及完整基准测试过程。

技术 › LLM 雪瑜 2026-09-0110.7 KB 55.5K 175 90

第一次下载本地大模型,如何看懂 Hugging Face 上的各种参数?

本文面向第一次在 Hugging Face 下载本地大模型的用户,讲解如何理解各种参数和名词。作者提出把整条链路分为五层:硬件资源、模型本身、权重精度与量化、文件格式、推理框架。文章依次解释了显存与统一内存的区别、参数量与文件大小的估算、Dense 与 MoE 架构差异、Base/Instruct/VL 等版本选择、BF16/FP8/4bit 等精度概念、GGUF 格式与量化方案、Safetensors 分片与配置文件、Hugging Face 页面阅读顺序,以及 MLX、llama.cpp、Ollama、LM Studio 等工具的关系,帮助新手不再凭文件名猜测下载。

技术 › LLM 雪瑜 2026-09-0118.8 KB 19.3K 196 86

从零安装Qwen3.8-27B:Mac本地部署与性能调优指南

本文详细介绍了如何在 Apple Silicon Mac 上从零部署 Qwen3.8-27B 模型。作者苏乐指出,普通 Mac 无需升级到最新 Mac Studio 即可运行该模型,关键在于算清内存账:模型权重、上下文缓存、运行缓冲、草稿模型和系统开销共享统一内存。文章对比了 4-bit、8-bit 和 BF16 量化版本的选择建议(24GB/32GB 选 4-bit,48GB/64GB 可选 8-bit),并提供了完整的部署流程:使用 uv 管理环境、通过 hf 命令下载模型、先测 baseline 速度再逐步开启优化。文章还解释了 DFlash 2 投机解码加速原理——通过轻量草稿模型并行提出候选 token,再由主模型验证,从而显著提升生成速度。

技术 › LLM 苏乐 2026-09-0137.3 KB 435.7K 623 85

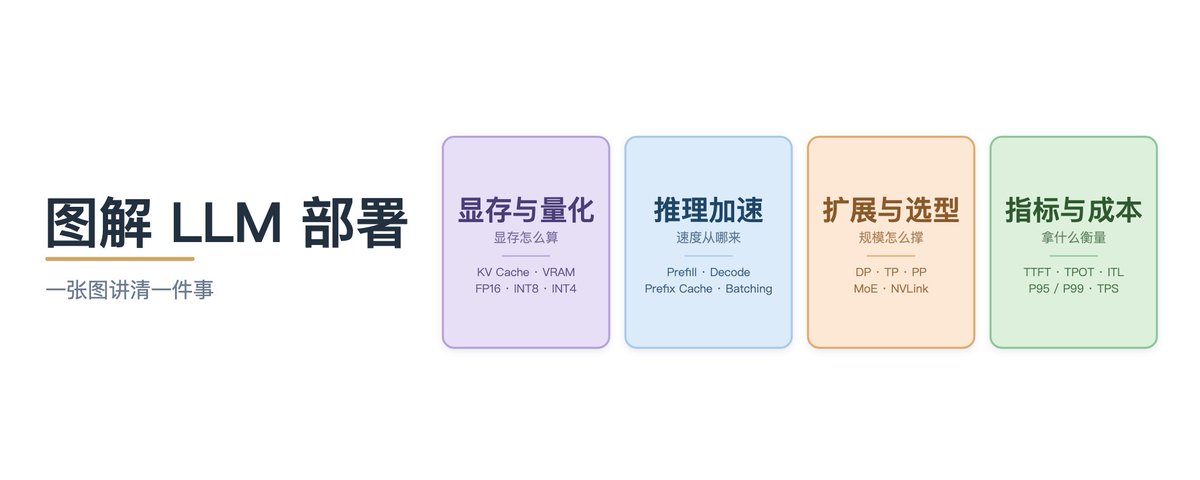
图解大语言模型部署

本文系统讲解大语言模型自部署的核心指标与实践要点,覆盖延迟类指标(TTFT、TPOT/ITL、P95/P99)、吞吐类指标(TPS、QPS、连续批处理)、资源类指标(显存与KV cache计算、量化精度)、服务质量(错误率、探针、可用性)以及成本核算(cost per token、TCO)。作者以 Ling-3.0-Flash MoE 模型在 DGX Spark 上的真实实测为例,将抽象指标落地为具体数字,帮助读者选对硬件配置、排查吞吐瓶颈与OOM问题、评估自建与API的划算临界点。

技术 › LLM WquGuru 2026-08-2927.1 KB 56.2K 199 89

千问 Qwen3.8 27B 本地化部署:小白保姆级教程

本文是一篇面向小手的本地大模型部署教程,作者在配备 AMD Ryzen AI MAX+ 395、64GB 统一内存的 Ubuntu 24.04 机器上,完整演示了如何用 Ollama 部署千问 Qwen3.8 27B 量化模型(UD-Q3_K_XL)。文章首先解释了本地化部署、参数规模、量化(Q3_K_XL)、token 等基础概念,说明本地部署的隐私、离线使用、无次数限制等优势。随后分 Windows 和 Linux 两条路线讲解环境检查、Ollama 安装、模型下载(约 13GB,运行占 29GB)、首次对话,以及如何确认 GPU(ROCm/Vulkan)真正接管计算,并提供常见问题排查方法,最终一条命令即可在本地跑通模型。

技术 › LLM Adrian Punk 2026-08-2820.9 KB 1.1M 1.6K 76

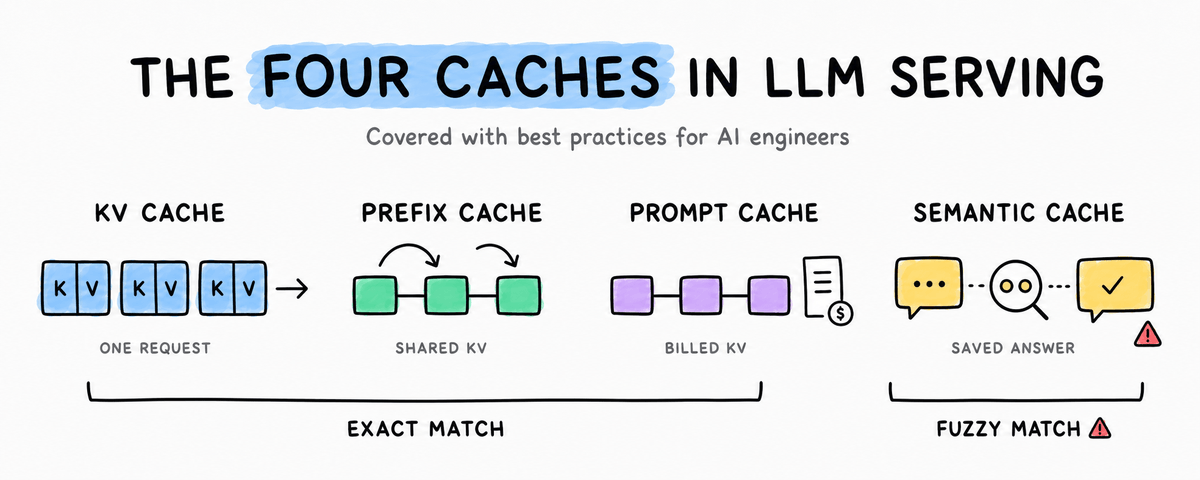
LLM 中的 KV Cache、Prefix Cache、Prompt Cache 与 Semantic Cache 详解

文章系统讲解了 LLM 推理中四层常被混淆的缓存机制:KV cache 存储单次请求的注意力张量;Prefix caching 在服务端以 token ID 哈希链为键复用这些张量;Prompt caching 是服务商对该查找的计费版本;Semantic cache 则以嵌入向量的余弦相似度为键存储完整响应。前三层为精确匹配、不影响正确性,未命中只损失延迟和费用;第四层为模糊匹配,可能返回错误答案。文章基于 transformers v5 提供可运行代码示例,涵盖缓存增长、内存带宽瓶颈、GQA/MLA/量化等优化手段,以及阻碍缓存复用的五类常见问题。

技术 › LLM Avi Chawla 2026-08-2833.6 KB 1.7M 1.4K 85

一次性讲清楚 Qwen3.8 27B 的本地部署

本文详细介绍如何在本地部署阿里开源的 Qwen3.8 27B 模型,覆盖 Mac 和 N 卡两条路线,并附 4090 实测数据。作者通过四轮质量测试发现 9.83GB 压缩版在短任务上与 30GB 版本打平,指出 12GB 游戏卡即可运行。文章系统讲解硬件选型、量化版本选择、KV Cache 显存计算、MTP 加速配置及常见踩坑,强调窗口大小只占显存不影响速度这一关键认知,是一篇面向零基础用户的完整部署指南。

技术 › LLM huangserva 2026-08-2571.4 KB 296.8K 683 91

从单机到双机:小白靠 AI 助手跑通 124B 大模型的完整记录

本文记录了一位非计算机出身的普通用户,借助 AI 助手,成功在双节点 NVIDIA DGX Spark 上部署蚂蚁百灵 124B 参数的 Ling-3.0-flash 模型,并完成单机 FP4 与双机 FP8 的对比评测。文章详细介绍了从模型下载、SGLang 编译、单机部署到双机配置、公网 API 开放的全过程,并提供了性能数据、踩坑清单和 AI 协作方法论。核心结论是:双机在长输入预填充上优势明显(2.2倍),但解码速度提升有限;上下文长度是硬约束,单机 FP4 适合日常任务,双机 FP8 适合长文档处理。

技术 › LLM Xiangyu 香鱼 2026-08-1916.2 KB 172.2K 163 86

保姆级教程:DGX Spark 本地跑通 124B 大模型全记录

本文记录了作者在公司配置的英伟达 DGX Spark 桌面级 AI 超算上本地部署大模型的完整过程。文章首先介绍选择 DGX Spark 的原因(数据隐私、成本可控),解析其 GB10 芯片与 128GB 统一内存的硬件配置,讲解稠密模型与 MoE 稀疏模型的区别,最终选定蚂蚁百灵 Ling-3.0-flash(fp4/int4 量化版本)进行部署。作者对比了 Ollama 与 vLLM 的优劣,选择 vLLM 完成部署,并借助 Claude Code 远程操作。最后进行了 MTP 推理加速测速对比,并成功将本地模型对接到 Claude Code 实际使用。

技术 › LLM AI少年 2026-08-1817.4 KB 184.5K 132 82